Command Palette
Search for a command to run...
原生稀疏注意力:硬件对齐且原生可训练的稀疏注意力机制
原生稀疏注意力:硬件对齐且原生可训练的稀疏注意力机制
摘要
长上下文建模对下一代语言模型至关重要,但标准注意力机制的高计算成本带来了显著的计算挑战。稀疏注意力为在保持模型能力的同时提升效率提供了一条有前景的路径。我们提出了 NSA,一种原生可训练的稀疏注意力机制,通过算法创新与硬件对齐优化的结合实现高效的长上下文建模。NSA 采用动态层级稀疏策略,将粗粒度 token 压缩与细粒度 token 选择相结合,从而同时保持全局上下文感知与局部精度。我们的方法通过两项关键创新推动了稀疏注意力设计的进展:(1)通过算术强度平衡的算法设计实现显著加速,并针对现代硬件进行实现层面的优化。(2)实现端到端训练,在不牺牲模型性能的前提下减少预训练计算量。如图 1 所示,实验表明使用 NSA 预训练的模型在通用基准、长上下文任务以及基于指令的推理任务上均达到或超过 Full Attention 模型。同时,NSA 在 64k 长度序列的解码、前向传播和反向传播阶段均实现了相对于 Full Attention 的显著加速,验证了其在整个模型生命周期中的高效性。
一句话总结
北京大学、DeepSeek-AI 和华盛顿大学提出 NSA,一种原生可训练稀疏注意力机制,采用动态分层策略,将粗粒度 token 压缩与细粒度 token 选择相结合,以支持端到端训练,并在 64k 长度序列上相比 Full Attention 实现显著加速,同时在通用和长上下文基准上保持或超越性能。
核心贡献
- NSA 是一种面向长上下文建模的原生可训练稀疏注意力机制,将 keys 和 values 组织成时间块,并组合压缩后的粗粒度 tokens、被选中的细粒度 tokens 以及滑动窗口。
- 它引入一种硬件对齐的块级稀疏注意力设计,具有专用 kernel 以平衡算术强度和内存访问,并提供可训练前向与反向 operator,以实现稳定的端到端训练并减少预训练计算。
- 在通用、长上下文和推理基准上,实验使用一个 270 亿参数 transformer 模型,在 2600 亿 tokens 上进行预训练,显示 NSA 达到或超过 Full Attention,并在 A100 GPU 上对 64k 长度序列实现不断提升的加速。
引言
长上下文建模对大语言模型日益重要,因为仓库级代码生成、文档理解、推理和自主 agents 等应用需要在数千或数万个 tokens 上进行连贯处理。Softmax 注意力对这些长程依赖非常有效,但其计算成本增长迅速,在非常长的序列上可能主导解码延迟。
已有稀疏注意力方法试图通过 KV cache 淘汰、块级选择、采样、聚类与哈希等技术利用注意力本身的稀疏性。然而,这些方法往往没有把理论上的计算缩减转化为真实硬件加速,并且很多方法缺少实现稳定端到端模型训练所需的训练时支持。
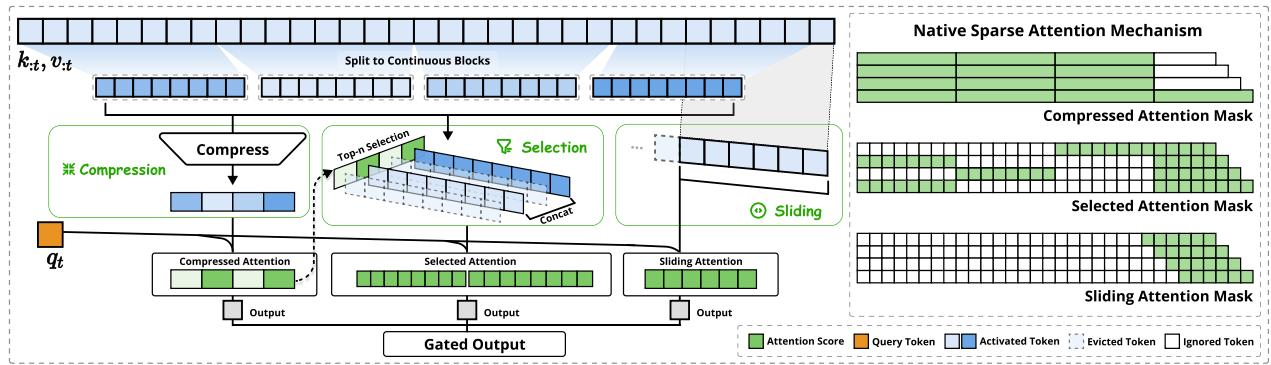
作者提出 NSA,一种原生可训练稀疏注意力架构,将 keys 和 values 组织为分层 token 块,并使用压缩粗粒度 tokens、被选中的细粒度 tokens 以及用于局部上下文的滑动窗口。他们还设计硬件对齐 kernel 与可训练 operator,使稀疏注意力能够在匹配或超过 Full Attention 性能的同时加速推理和训练。
方法
作者将 NSA 设计为一种原生可训练稀疏注意力机制,用于解决长上下文语言建模中的两个瓶颈:训练和预填充阶段的二次方注意力计算,以及解码阶段受内存限制的键值访问模式。从标准因果自注意力出发,query token qt 的输出为
ot=Attn(qt,k:t,v:t),其中
Attn(qt,k:t,v:t)=∑j=1tαt,j∑i=1tαt,ivi,αt,i=exp(dkqt⊤ki).该设计基于这样一个观察:注意力计算和内存访问在不同执行阶段占据主导。在训练和预填充阶段,批处理注意力操作具有较高的算术强度,通常受计算限制。在自回归解码阶段,每次前向传播只生成一个新 token,但必须访问完整的键值缓存,导致算术强度较低并受到内存带宽限制。因此,NSA 在密集注意力阶段减少计算量,同时在解码阶段减少内存流量。
核心思想是用为每个 query 构建的紧凑、信息密集表示来替代完整的先前键值记忆 k:t,v:t:
K~t=fK(qt,k:t,v:t),V~t=fV(qt,k:t,v:t).NSA 不再关注过去的每个 token,而是构建若干类别的重映射键值对,并使用学习得到的 gate 聚合它们的输出:
ot∗=c∈C∑gtc⋅Attn(qt,K~tc,V~tc),其中 C={cmp,slc,win} 表示压缩分支、选择分支和滑动窗口分支。重映射后的键和值的总数为
Nt=c∈C∑size[K~tc],该设计通过保证 Nt≪t 维持高稀疏性。总体架构如以下框架图所示:
第一个分支是 token 压缩。它将时间上连续的 keys 和 values 块聚合为块级表示。对于块长度 l 和滑动步长 d,压缩 key 分支为
fKcmp(k:t)={ϕ(kid+1:id+l)1≤i≤⌊dt−l⌋},其中 ϕ 是一个带块内位置编码的可训练 MLP,它将一组 keys 映射为一个压缩 key。对应的压缩 values 以类似方式生成。当 d<l 时,相邻块会重叠,从而缓解严格不重叠分块造成的信息碎片化。该分支能够捕获粗粒度语义模式,同时显著缩短注意力序列长度。
第二个分支是 token 选择。由于压缩表示可能丢失细粒度信息,NSA 选择性地保留少量原始 token 块。选择按块进行而不是按 token 进行,这既是为了硬件效率,也是因为注意力重要性通常呈现空间连续性。块级内存访问和计算更符合现代 GPU 行为,能够实现稠密读取并更好利用 Tensor Core 操作。
为避免对每个选择块都进行评分带来的额外开销,NSA 从压缩 keys 上计算得到的注意力分数导出选择块重要性:
ptcmp=Softmax(qt⊤K~tcmp).如果压缩块和选择块采用相同的分块方案,压缩注意力分数可以直接作为选择块重要性分数。否则,根据选择块和压缩块之间的空间关系聚合重要性。对于分组查询注意力或多查询注意力,还会在共享同一键值组的 query heads 之间对分数求和:
ptslc′=h=1∑Hptslc,(h).top-n 选择集合为
It={i∣rank(ptslc′[i])≤n}.被选中的 keys 按如下方式拼接:
K~tslc=Cat[{kil′+1:(i+1)l′∣i∈It}],V~tslc 以类似方式构造。被保留的子集会参与细粒度注意力,同时把相关性较低的 tokens 从计算中淘汰出去。
第三个分支是滑动窗口。局部上下文通常变化很快,如果在隐式处理中不加区分,可能会主导学习。因此 NSA 将最近的 tokens 隔离到一个专用分支中:
K~twin=kt−w:t,V~twin=vt−w:t.将局部注意力与压缩和选择分离,可以减少捷径学习;这种情况下模型可能过度依赖邻近 tokens,而未充分利用长程稀疏模式。输出为每个分支使用独立的键值投影,并通过 MLP 和 sigmoid 激活从输入特征导出的学习门控机制。通过减少局部、粗粒度和细粒度信息路径之间的梯度干扰,这支持稳定的端到端训练。
硬件实现聚焦于稀疏选择分支,因为压缩和滑动窗口注意力可以复用面向 GQA 和 MQA 架构的现有高效 kernel。对于稀疏选择,标准 FlashAttention 风格的加载按时间连续 query 块进行,可能效率较低,因为同一块中的 queries 可能需要互不相交的 KV 块。因此该 kernel 采用以组为中心的加载策略。对于每个位置 t,它加载 GQA 组内的所有 queries,即 Q∈R[h,dk],以及它们共享的被选 KV 块索引 It。内循环随后按 It 索引依次取连续的 key 块和 value 块到 SRAM 中,其中 kernel 块大小 Bk 整除选择块大小 l′。query 和输出循环被调度在网格上,因为内循环长度在不同 query 块之间近似恒定。kernel 组织方式如下图:
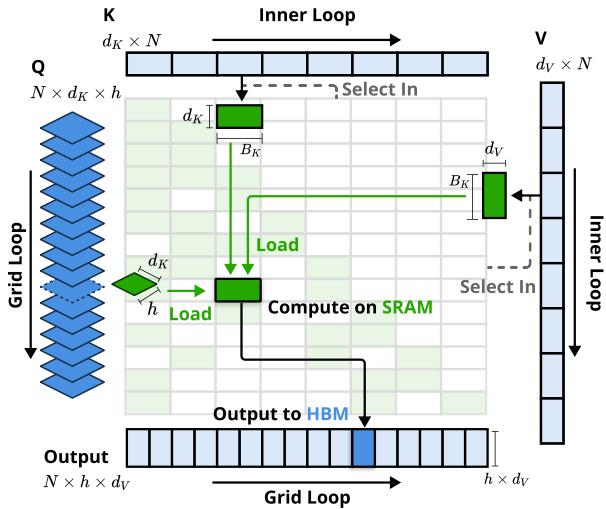
该 kernel 设计通过在 GQA 组内所有 query heads 之间共享相同的被选块,减少冗余 KV cache 搬运。它还平衡 streaming multiprocessor 工作负载,并提高有效算术强度。通过结合分层压缩、块级选择、滑动窗口注意力、学习门控以及以组为中心的硬件执行,该方法把理论稀疏性转化为在计算受限和内存受限两个阶段的实际加速。
实验
实验在通用、长上下文、推理和效率设置下,使用一个大规模 GQA-MoE 模型,将 NSA 与 Full Attention 和稀疏注意力基线进行比较。NSA 在标准基准上保持竞争力,并有显著推理增益;其分层稀疏注意力实现稳健的长上下文检索,并在长上下文任务上表现更优。经过数学推理微调后,NSA 优于 Full Attention 基线,表明稀疏注意力能够保留长程逻辑依赖。效率分析显示,随着上下文长度增加,NSA 的训练和解码加速越来越显著。
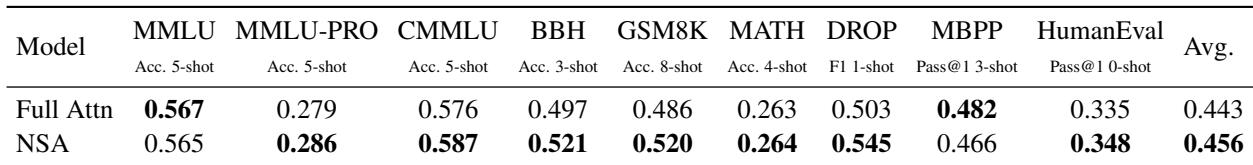
在知识、推理和编码基准上,NSA 在高稀疏性下相对于 Full Attention 提升总体平均分。它在大多数单个任务上超过 dense 基线,在推理基准上尤其明显;在编码任务上接近基线,在 MMLU 和 MBPP 上略低于基线。尽管使用稀疏注意力,NSA 的平均分数仍高于 Full Attention。最大的相对提升出现在 DROP 和 GSM8K 等推理任务上,说明模型能够学到重要的上下文信息
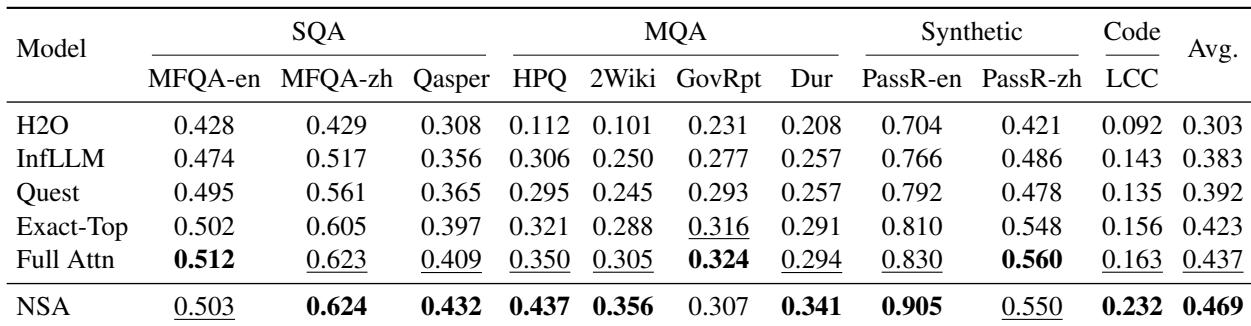
NSA 在评估的稀疏注意力基线和 Full Attention 中取得最强的 LongBench 总体平均分。优势主要来自长上下文推理任务,尤其是多跳问答、代码理解和段落检索;尽管一些单文档 QA 结果仍接近或略低于 Full Attention。NSA 在所有比较方法中达到最高 LongBench 总体分数。最明显的定性提升出现在多跳 QA、段落检索和代码任务上。Full Attention 在一些单文档 QA 子集上仍具竞争力,因此 NSA 的优势在更困难的长上下文设置中最为明显。
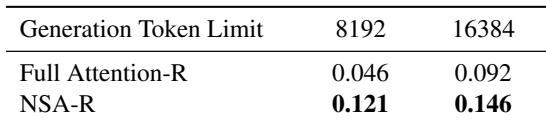
在使用数学推理轨迹进行监督微调后,NSA-R 在较短和较长生成长度限制下,都在 AIME 上取得高于 Full Attention-R 基线的平均准确率。该稀疏变体在推理任务上表现出明显优势,增益在 8k 限制下最明显,并在 16k 下仍然保持。监督微调后,NSA-R 在 AIME 上超过 Full Attention-R。稀疏变体在较短生成长度限制下取得更大相对提升。当生成长度限制被延长时,性能优势仍然存在。
解码分析以 token 当量估计内存访问量,并显示随着上下文长度增加,稀疏注意力方法访问的 tokens 远少于 full attention。由于解码受内存限制,减少的 KV cache 加载预计会随着序列长度增长转化为成比例的更大加速。该优势在长上下文中尤其明显,稀疏方法接近一个数量级的加速。随着上下文长度增加,内存访问量始终远低于 full attention。随着序列更长,预期解码加速增长,在最长测试上下文中大约达到 12 倍。
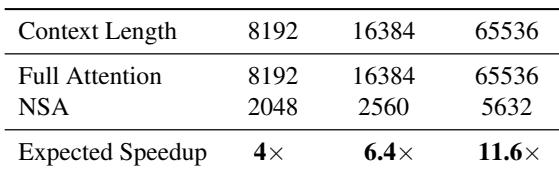
实验在标准知识、推理和编码基准、长上下文 LongBench 任务、监督微调后的数学推理上评估 Native Sparse Attention,并附带解码内存访问分析。总体而言,NSA 在保持稀疏的同时取得强于 full attention 的整体表现,在推理和更困难的长上下文任务上提升最明显,但在一些编码和单文档 QA 案例中接近或略低于 full attention。微调后的稀疏变体在不同生成长度限制下也优于其 dense 对应模型。解码分析显示,NSA 访问的 tokens 远少于 full attention,随着上下文长度增长可带来尤其大的预期加速。