Command Palette
Search for a command to run...
探究语言模型蒸馏中的容量差距定律
探究语言模型蒸馏中的容量差距定律
Chen Zhang Qiuchi Li Dawei Song Zheyu Ye Yan Gao Yan Hu
摘要
语言模型(LM)蒸馏旨在将大型教师模型中的知识蒸馏至小型学生模型中。作为 LM 蒸馏面临的一个关键问题,性能优异的学生模型往往源于规模相对较小的教师模型而非更大的教师模型,尤其是在教师与学生之间存在显著容量差距的情况下。这一问题通常被称为容量差距的诅咒,表明在教师模型规模扩大的过程中,可能存在一个最优教师以产生性能最佳的学生模型。因此,需要对不同规模范围的教师模型进行蒸馏实验以确定最优教师,这在大语言模型(LLM)的背景下计算开销巨大。本文通过从一项涵盖广泛小规模(<3B)LLM 蒸馏的初步研究中归纳出容量差距定律来应对这一关键瓶颈,发现在不同模型规模和数据规模下,最优教师的规模始终与学生模型的规模呈线性关系。将该定律扩展至更大规模(7B)的 LLM 蒸馏后,我们成功获得了超越众多竞争对手的多功能 LLM。
一句话总结
北京理工大学的研究人员与合作者确立了语言模型蒸馏中的容量差距规律,表明在不同模型规模和数据规模下,最优教师规模与学生规模线性缩放,从而消除对教师的穷举搜索,并得到性能优于众多竞争对手的 7B LLM。
核心贡献
-
该论文将大语言模型蒸馏中的容量差距诅咒重新表述为不可能三角,阐明了使用超大教师的任务无关蒸馏为何会带来高计算成本,并推动了基于规律的教师选择方法。
-
该工作通过参数低于 3B 的模型实验发现并形式化了容量差距规律,表明在不同模型规模和数据规模下,最优教师规模随学生规模线性增长,这支持将其外推到 7B 蒸馏。
-
实验表明,使用该规律能够实现计算高效的 7B 语言模型蒸馏,产生多能模型,在基础语言理解和指令遵循基准上有所提升,同时强化计算量与性能 Pareto 前沿。
引言
语言模型蒸馏将知识从大型教师模型转移到更小的学生模型,使大语言模型更易于部署,同时保留有用行为。已有研究揭示了一个关键局限,称为容量差距诅咒:更大的教师并不总能带来更好的学生,因此找到最佳教师往往需要在不同模型规模上进行代价高昂的实验。这在目标学生规模、最优教师规模和有限计算预算之间形成了艰难权衡。作者通过发现目标学生规模与其最优教师规模之间的线性缩放规律来解决这一瓶颈。他们利用该规律高效选择教师,降低蒸馏开销,并生成在语言理解和指令遵循任务上性能强劲的小型语言模型。
数据集
-
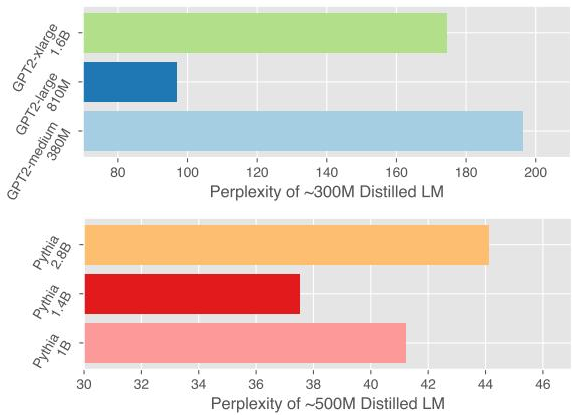
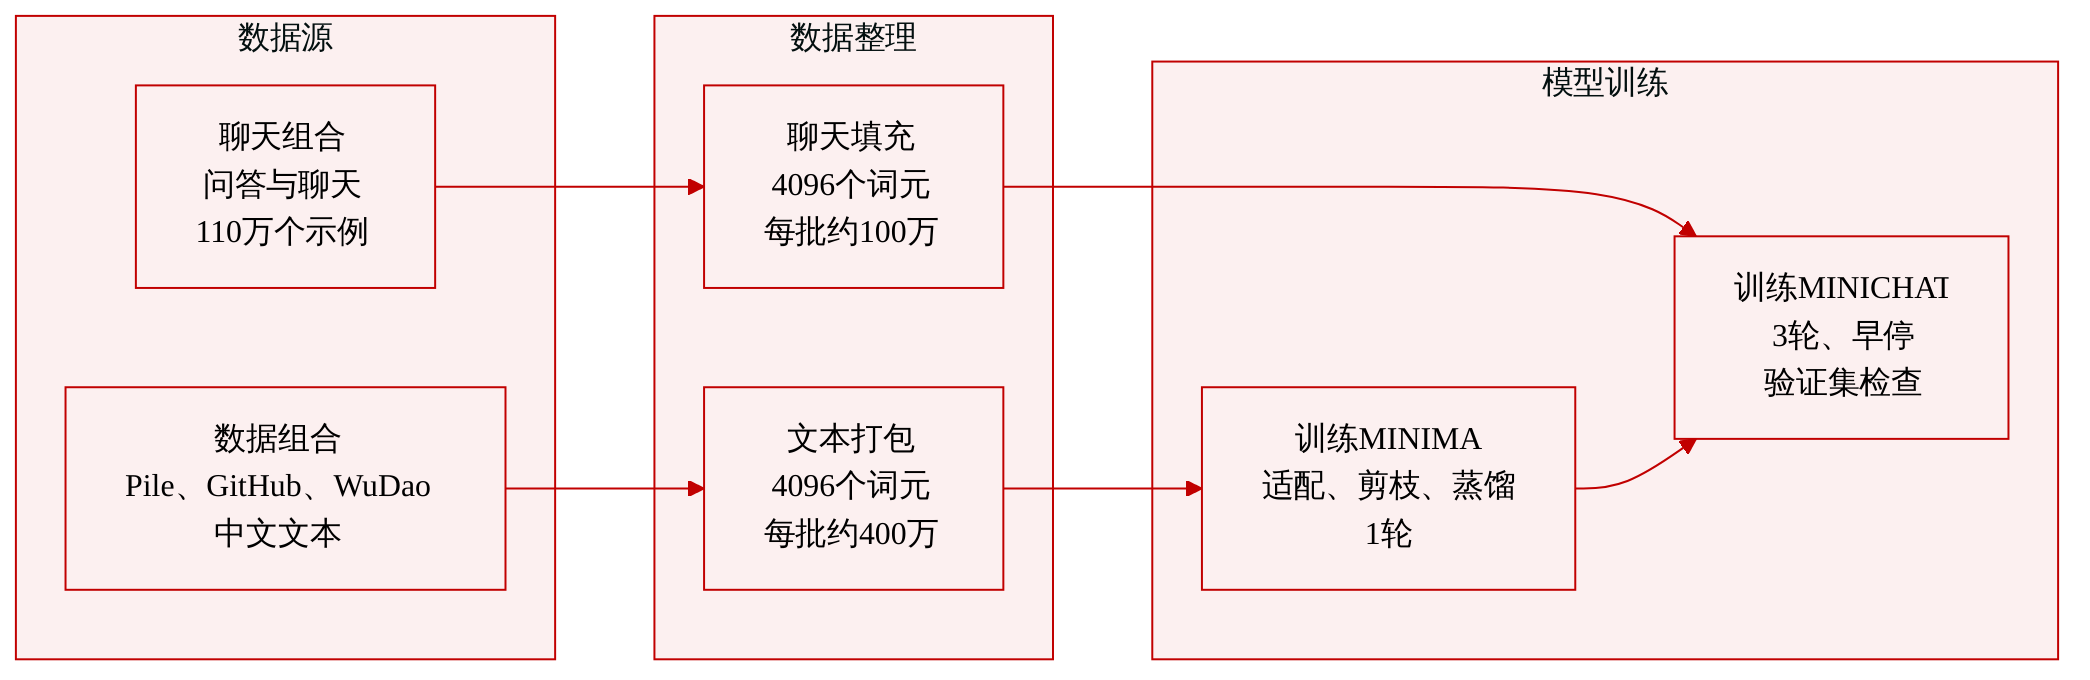
作者使用两组主要数据:用于模型适配、剪枝和蒸馏的中文增强通用文本混合数据集,以及用于监督微调的指令遵循数据集。
-
通用混合数据集:
- 来源:子采样的 Pile、GitHub 和 WuDao。
- 用途:用于将 LLaMA2-7B 适配到中文词表,并支持为创建 0.4B、7B 和 3B 规模的 MINIMA 模型进行剪枝和蒸馏。
- 规模和混合比例:节选中未说明;论文引用表 1 展示统计信息。
-
指令遵循数据:
- 来源:大量单轮问答对和多轮对话会话的集合。
- 规模:总计 1.1M 个样例。
- 用途:用于将 MINIMA 微调为 MINICHAT。
- 统计信息:详见论文附录 B。
-
数据处理与序列构造:
- 对于蒸馏,样例被打包成长度为 4,096 个 tokens 的序列,批大小为 1,024 个序列,对应约 4M tokens。
- 对于微调,样例被填充到 4,096 个 tokens 的序列中,批大小为 256 个序列,对应约 1M tokens。
- 节选中未提及其他裁剪、元数据构建或训练、验证和测试划分细节。
方法
作者采用了一种容量差距探索流程,将教师规模视为可调变量,而不是无限制资源。对于目标规模的学生模型,目标是找到有限计算开销下能带来最佳蒸馏学生性能的教师规模。该流程首先选择一个特定规模的语言模型教师,通过剪枝教师构建更小的学生模型,执行蒸馏,然后记录得到的性能。通过在多组教师和学生规模对上重复该流程,该方法获得每个目标学生规模是否存在一致最优教师规模的证据。
学生模型构建阶段采用由参数表达力分数引导的结构化剪枝。学生模型通过给架构单元添加可训练缩放变量,从教师模型中剪枝得到。注意力头由变量 ξj 加权,前馈神经元由变量 νk 加权,隐藏状态在各层之间由共享变量 μ 加权。修改后的计算表达为
MHA(xi)=j=1∑Aξj⋅Attn(μx≤i;WjQ,WjK,WjV,WjO), FFN(xi)=k=1∑Iνk⋅g(xiWkI)WkO.这些变量揭示了每个单元对剪枝目标的重要性。注意力头、神经元或隐藏状态的表情力分数通过剪枝损失相对于其对应变量的期望绝对梯度计算:
Ijhead=Exi∂ξj∂Lpruning,Ikneuron=Exi∂νk∂Lpruning,Ihidden=Exi∂μ∂Lpruning.剪枝损失使用教师输出和真实标签:
Lpruning=i∑∣V∣−yitruthlogyiteacher.表达力分数较低的单元被视为较不重要,并优先剪枝。该方法对分数应用 ℓ2 归一化,以减少跨层的不平衡剪枝。由于隐藏状态剪枝与注意力或神经元剪枝呈乘性交互,各组件稀疏度设置为
p′=1−1−p,其中 p 是期望的整体模型稀疏度。这种调整有助于实现目标全局稀疏度,同时让嵌入相对于 Transformer 内部参数压缩得更少。
蒸馏阶段使用简单 token 级目标,结合教师软目标和真实标签的硬目标:
Ldistillation=21i∑∣V∣−yiteacherlogyistudent+21i∑∣V∣−yitruthlogyistudent.该目标在保留来自输出分布的教师信号的同时,仍用真实监督锚定学生模型。训练后,比较每个剪枝学生模型的性能,以选择对该学生规模产生最佳结果的教师规模。
随后,收集到的学生规模 S 与最优教师规模 T⋆ 配对被用于估计缩放关系。该方法将观测配对拟合为线性规律:
T⋆≈α⋅S+β.如下方图所示:
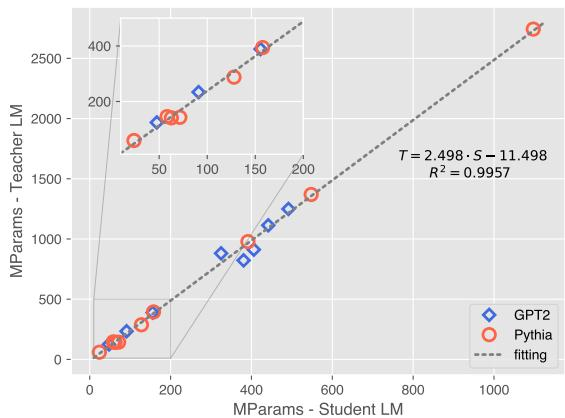
拟合结果为 α=2.498、β=−11.498 和 R2=0.9957,支持学生规模与最优教师规模之间近乎线性的关系。得到的估计规律为
T⋆≈2.498⋅S−11.498≈2.5⋅S.等价地,若教师规模 T⋆,则预测该教师为最优的对应学生规模约为 0.4⋅T⋆。这一表征使教师选择可以由直接的缩放估计引导,而不是对许多教师规模进行穷举试验。
实验
实验首先在多个模型和数据规模上蒸馏经过剪枝的 GPT2 和 Pythia 学生模型,然后使用广泛的语言、推理、代码和对话评估,将容量差距分析扩展到更大的基于 LLaMA 的 MINIMA 和指令微调的 MINICHAT 模型。小规模结果显示,学生性能随规模提升,而增加教师规模呈现先上升、后稳定、再下降的模式,并揭示出稳定的最优教师规模;大规模模型在与高效和指令微调基线的对比中表现具有竞争力。消融实验进一步表明,对称剪枝和简单蒸馏仍然有效,支持容量差距规律的鲁棒性和实用价值。
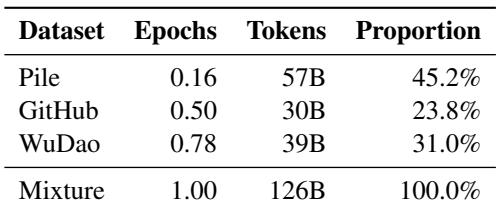
蒸馏后的 3B 模型在融合 Pile、GitHub 和 WuDao 的混合语料上训练,经过一个 epoch 总计约 126B tokens。Pile 占比最大,GitHub 占比最小,支持适配后的 LLaMA2 和 LLaMA3.1 蒸馏。该混合数据集也用于剪枝,帮助塑造面向中文和通用任务的紧凑学生模型。训练混合数据融合通用网页文本、代码和中文网页数据。按占比,Pile 是主导来源,GitHub 是最小来源。同一混合数据集支持 3B MINIMA 学生模型的剪枝和蒸馏。
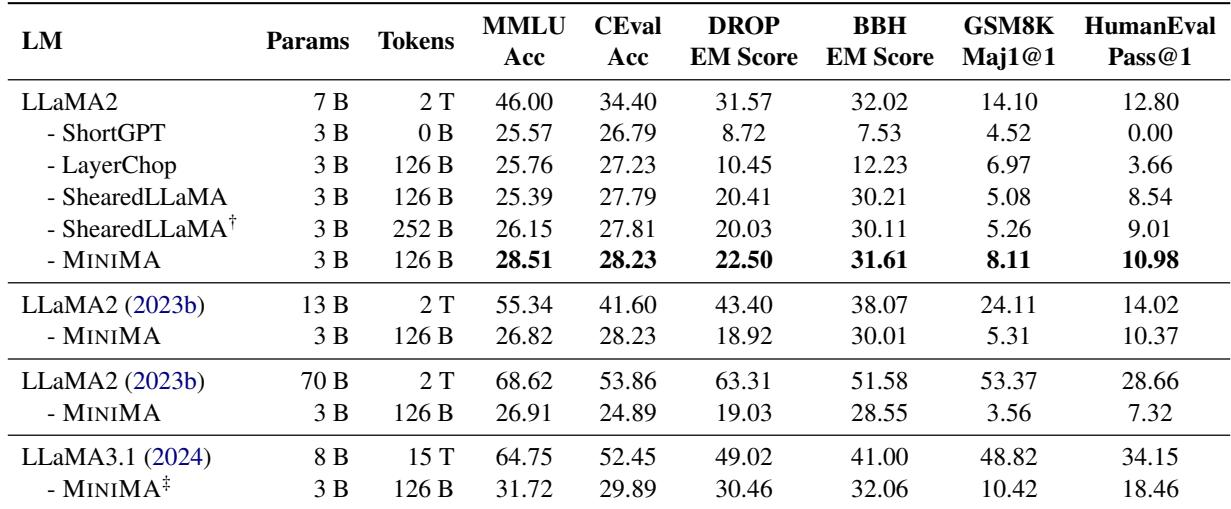
MINIMA 被描述为一个 3B 蒸馏模型,在知识、推理和代码基准上优于可比的剪枝和层删除基线。它仍强于计算量可比的 ShearedLLaMA 设置,表明蒸馏可以与其他效率方法竞争。报告的结果也支持论文中的容量差距解释以及更强教师模型的价值。在相近模型规模和 token 预算下,MINIMA 优于层删除和全局剪枝基线。增加 ShearedLLaMA 的 token 预算并不能缩小与 MINIMA 的差距。更强的教师语言模型能够提升蒸馏模型的标准基准性能。
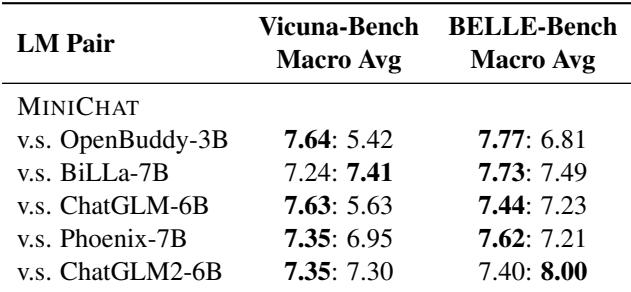
MINICHAT 在 Vicuna-Bench 和 BELLE-Bench 上均明显强于规模匹配的 3B 基线 OpenBuddy-3B,其宏平均成对 GPT4 评估分数更高。它也与更大或规模不同的指令模型总体保持竞争力,尽管在 Vicuna-Bench 上略低于 BiLLa-7B,在 BELLE-Bench 上低于 ChatGLM2-6B。MINICHAT 在两个被评估基准上均大幅超过规模匹配的 OpenBuddy-3B 基线。MINICHAT 在规模不匹配基线上也保持竞争力,只有少数情况下基线得分更高。评估结果支持 MINICHAT 作为尽管规模缩减仍很强的指令遵循模型。
消融结果显示,当 MINIMA 的剪枝优先级发生变化时,它仍总体具有竞争力。全局剪枝可在部分知识基准上带来小幅优势,而层删除和教师助手通常竞争力较弱。朴素蒸馏接近 patient knowledge 方案,表明剪枝设计比蒸馏目标更核心地影响所观察到的行为。MINIMA 与采用其他剪枝策略的变体表现相当。全局剪枝产生混合效果,在一些任务上得分更高,在另一些任务上得分更低。层删除和教师助手在所报告任务上通常弱于 MINIMA。
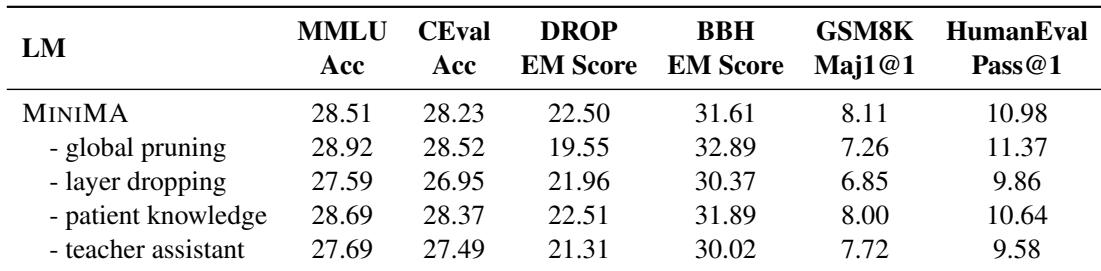
实验评估了在英文、代码和中文混合语料上训练的 3B MINIMA 与 MINICHAT 模型,使用通用知识、推理、代码和指令遵循基准,以及基于 GPT-4 的成对评估。MINIMA 持续优于可比的剪枝、层删除和计算量可比的高效基线;更强的教师模型能提升性能,消融实验显示剪枝设计比蒸馏目标更重要。MINICHAT 大幅超过规模匹配的 OpenBuddy-3B 基线,并与更大指令模型总体保持竞争力,表明蒸馏在规模缩减后仍能产生强大的小型语言模型。