Command Palette
Search for a command to run...
IndicSynth:面向低资源印度语言的大规模多语种合成语音数据集
IndicSynth:面向低资源印度语言的大规模多语种合成语音数据集
Divya V. Sharma Vijval Ekbote Anubha Gupta
摘要
近年来,合成语音生成技术的进展使得生成能够模拟人声的高质量合成(伪造)语音成为可能。这些技术带来了身份盗窃和虚假信息传播的滥用威胁。因此,此类强大技术的滥用使得开发鲁棒且泛化能力强的音频深度伪造检测(ADD)和反欺骗模型变得迫切。然而,此类模型往往存在语言偏差,导致在某一语言数据集上训练的模型在域外语言上评估时准确率较低。这种偏差降低了模型的可用性,并凸显了对多语种合成语音数据集以开展偏差缓解研究的迫切需求。然而,现有数据集大多为英语或中文。多语种合成数据集的匮乏阻碍了多语种 ADD 和反欺骗研究。此外,在印度等语言多样性丰富的国家,这一问题尤为突出。因此,我们提出 IndicSynth,该数据集包含 4,000 小时的合成语音,涵盖 989 位目标说话人(包括 456 位女性和 533 位男性),涉及 12 种低资源印度语言。数据集包含丰富的元数据,涵盖性别信息和目标说话人标识符。实验结果表明,IndicSynth 是多语种 ADD 和反欺骗研究的一项重要贡献。该数据集可从 https://github.com/vdivyas/IndicSynth 获取。
一句话总结
SBILab 和 IIIT-Delhi 推出 IndicSynth,这是一个 4,000 小时合成语音数据集,包含 12 种低资源印度语言和 989 名目标说话人,用于解决音频深度伪造检测和反欺骗模型存在语言偏差的问题,这些模型在领域外语言上表现不佳。
核心贡献
-
该论文提出 IndicSynth,这是一个约 4,000 小时的大规模多语言合成语音数据集,来自 989 名目标说话人,其中包括 456 名女性和 533 名男性,覆盖 12 种低资源印度语言。该数据集提供说话人标识符、性别元数据,以及模仿子集和多样性子集,用于音频深度伪造检测与反欺骗研究。
-
该数据集使用最先进的说话人验证和音频深度伪造检测模型在印度语合成语音上进行评测。实验表明,模仿子集可通过冒充攻击欺骗说话人验证系统,而现有深度伪造检测器在印度语测试集上表现较差。
-
通过 t-SNE 可视化和最先进的语言识别模型验证 IndicSynth 的语言真实性。这些评测支持该数据集作为多语言音频深度伪造检测、反欺骗、性别偏差和抵御冒充攻击的资源。
引言
文本转语音和语音转换方面的最新进展使生成逼真的合成语音成为可能,可应用于辅助技术、媒体、教育和娱乐,但同一能力也可能被滥用于冒充、金融欺诈、错误信息传播和安全泄露。先前的音频深度伪造检测与反欺骗研究高度依赖英语和中文等高资源语言合成语音数据集,这可能限制模型向其他语言的泛化,并降低实际全球可用性。现有数据集还常常缺乏冒充攻击和偏差研究所需的目标说话人标识符和性别元数据。作者提出 IndicSynth,这是一个大型多语言合成语音数据集,覆盖 12 种低资源印度语言,包含约 4,000 小时来自 989 名目标说话人的音频,并提供性别和说话人身份元数据。作者利用该数据集组织成模仿子集和多样性子集,以评估当前深度伪造检测器和说话人验证系统能否处理逼真的多语言合成语音,并评估数据集的语言真实性。
数据集
-
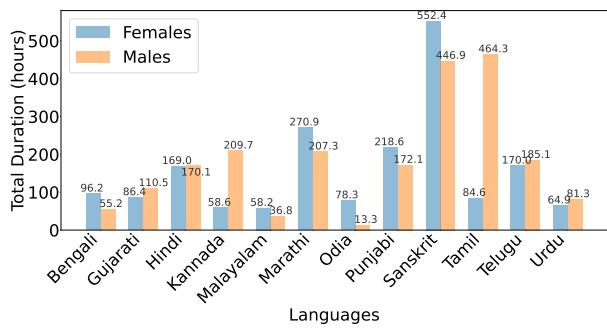
IndicSynth 是一个大规模多语言合成语音数据集,包含约 4,000 小时音频,覆盖 12 种低资源目标语言:孟加拉语、古吉拉特语、印地语、卡纳达语、马拉雅拉姆语、马拉地语、奥里亚语、旁遮普语、梵语、泰米尔语、泰卢固语和乌尔都语。
-
该数据集基于 IndicSuperb 中的真实语音和转录文本构建,IndicSuperb 以 Creative Commons CC0 许可证发布,并为相同 12 种语言提供真实录音。
-
作者将公开可用的文本转语音和语音转换模型应用于 IndicSuperb 的真实数据,以创建合成语音,并使用真实目标语音、源语音和转录文本作为生成基础。
-
IndicSynth 包含两个主要子集:
- 模仿子集:紧密模仿目标说话人的合成语音,用于研究说话人冒充和反欺骗风险。它通过在 IndicSuperb 上微调 XTTS-v2 生成,覆盖 10 种语言:孟加拉语、古吉拉特语、卡纳达语、马拉雅拉姆语、马拉地语、奥里亚语、旁遮普语、泰米尔语、泰卢固语和乌尔都语。
- 多样性子集:与目标说话人相似度较低的合成语音,旨在提供更广泛的合成语音多样性,并提升音频深度伪造检测模型的泛化能力。它直接由 TTS 和语音转换模型生成,未在 IndicSuperb 上微调。
-
对于多样性子集,孟加拉语合成数据使用公开可用的 Coqui VITS 模型生成,该模型在未公开的孟加拉语数据上训练。作者还使用 XTTS-v2 和 FreeVC24 为 12 种目标语言生成合成数据。
-
在数据集构建过程中,作者从 IndicSuperb 随机选择真实音频和转录文本。进行语音转换时,要求源说话人和目标说话人性别相同,以支持更高质量的合成语音生成。
-
IndicSynth 包含模型特定和语言特定元数据文件。对于 TTS 生成的片段,元数据记录目标说话人 ID、真实目标音频片段 ID、目标说话人性别、转录文本以及生成的合成音频片段 ID。对于 VC 生成的片段,元数据记录源说话人 ID、真实源片段 ID、目标说话人 ID、真实目标片段 ID、说话人性别以及合成片段 ID。
-
论文使用 IndicSynth 连同 IndicSuperb 真实数据,支持多语言音频深度伪造检测和反欺骗研究。模仿子集适合评估冒充攻击漏洞,而多样性子集适合在更广泛合成语音上训练或微调检测模型。
-
该摘录未提供明确的子集大小、训练划分比例、混合比例或裁剪策略,仅提及随机选择真实音频和转录文本以及使用模型特定元数据。
方法
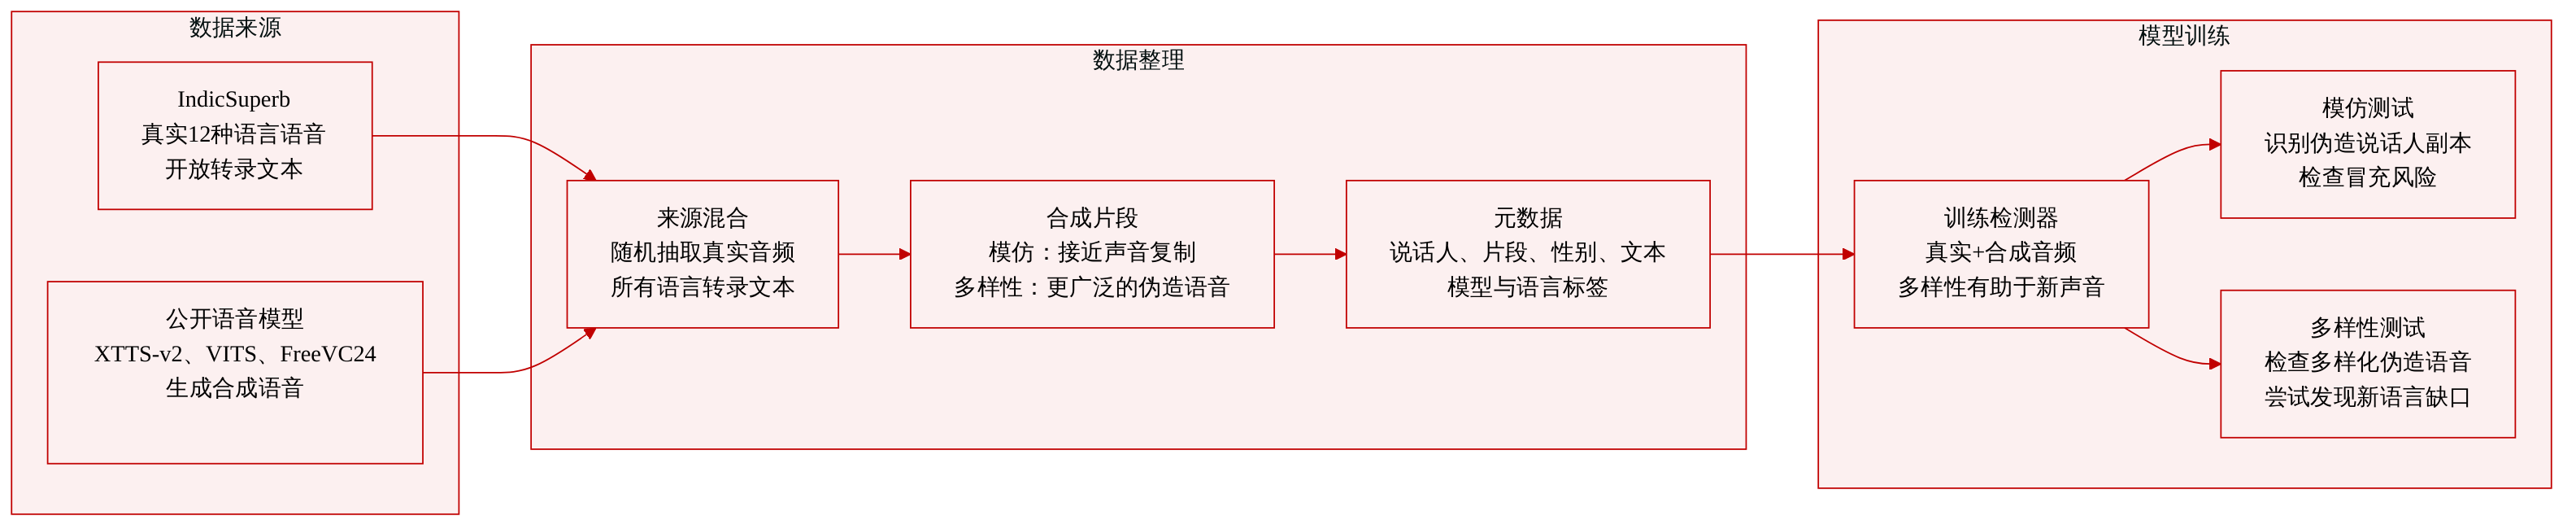
IndicSynth 通过一个模块化合成语音流程生成,该流程结合两个互补的声学生成模块:基于文本转语音的语音克隆和语音转换。作者利用公开可用的真实多语言语料库 IndicSuperb 作为该流程的基础。该源语料库提供目标语言的真实语音录音及其相关转录文本。该框架随后将选定的真实音频样本和转录文本分流到不同合成路径中,生成可支持多语言音频深度伪造检测和反欺骗研究的合成数据。
参考框架图:
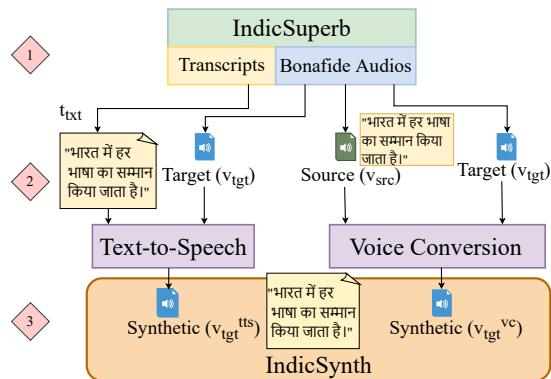
在第一条路径中,文本转语音模块充当语音克隆组件。它接收转录文本和真实目标说话人录音作为条件输入。该模型生成一段合成话语,该话语说出给定转录文本,同时尝试复现目标说话人的声学特征。该过程可写作:
vtgttts=TTS(ttxt,vtgt)在第二条路径中,语音转换模块使用两段真实录音:一段源话语和一段目标话语。转换后的输出保留源录音的语言内容,同时尝试将说话人身份转移到目标录音。该转换过程可写作:
vtgtvc=VC(vsrc,vtgt)双路径设计创建具有不同相似度属性的合成样本。当文本转语音模型适配到同一源领域时,它可以生成高度接近目标说话人的话语。相反,当生成模型未经适配直接应用时,所生成的合成语音与目标说话人的相似度更低,因此提供更高的说话人多样性。
作者利用这种差异构建面向模仿和面向多样性的合成数据。对于模仿子集,XTTS-v2 在真实 IndicSuperb 数据上对若干目标语言进行微调。在同一源语料上微调有助于生成的合成语音保持接近目标语音特征,使该子集适合评估说话人验证系统对冒充式攻击的脆弱性。
对于多样性子集,该流程使用公开可用的生成模型,且不在真实目标语料上微调。该方法在孟加拉语多样性分支使用 Coqui VITS,在跨目标语言文本转语音生成中使用 XTTS-v2,在语音转换中使用 FreeVC24。进行语音转换时,源说话人和目标说话人随机选择,但每对保持说话人性别相同,这有助于提升转换质量并减少伪影。
元数据生成流程也是方法的一部分。对于每个合成模型和目标语言,系统记录可追溯信息,例如说话人标识符、源音频标识符、目标音频标识符、说话人性别、转录文本细节和合成输出标识符。该结构使下游用户能够了解每个样本由哪个模型生成,以及哪些真实录音作为条件输入。
最终合成语料分布在多种低资源语言上,并包含男性和女性合成语音。生成过程选择真实音频和转录文本时,支持广泛的多语言覆盖,同时允许合成数据的语言和性别分布发生变化。
如下图所示:
实验
实验通过测试 IndicSynth 是否暴露现有语音模型的弱点,以及其合成录音是否具有语言真实性,来评估该数据集。主要在英语上训练的音频深度伪造检测模型在未见印度语设置中出现明显性能下降,而语言识别结果和嵌入可视化表明,多数合成语音保留可识别的语言特征。说话人验证测试进一步显示,模仿子集可高度接近目标说话人并造成欺骗风险,且存在某些依赖性别和语言的差异。总体而言,这些结果支持 IndicSynth 作为研究模型泛化、多语言欺骗漏洞和更强鲁棒性的有用资源。
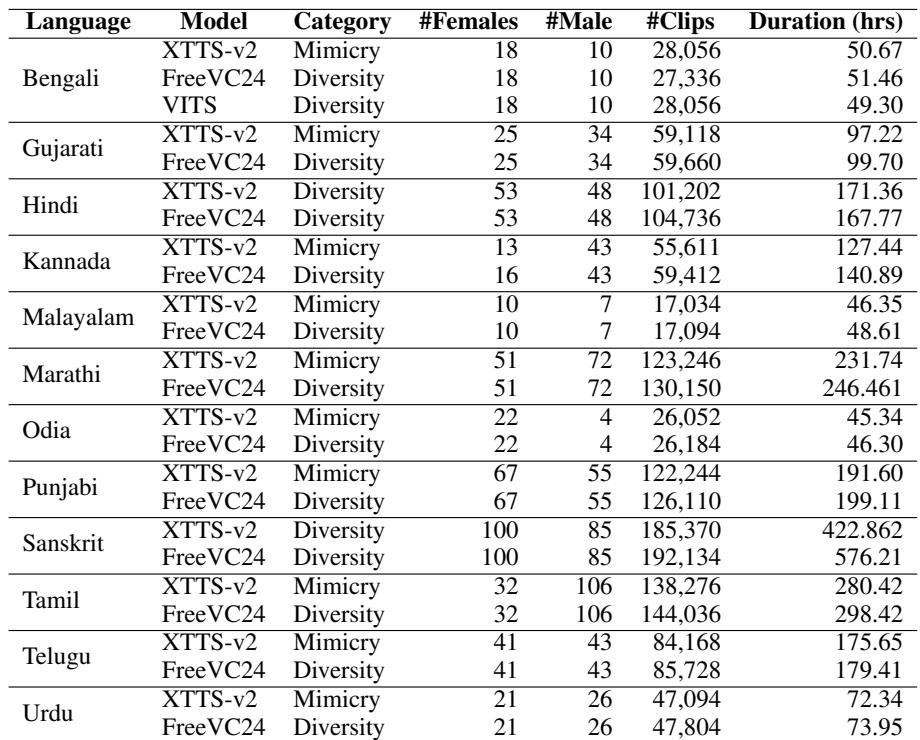
IndicSynth 被呈现为一个多语言合成语音集合,使用 TTS 和语音转换模型基于真实 IndicSuperb 录音构建。概览区分模仿目标说话人的模仿子集和旨在覆盖更广泛合成语音以用于音频深度伪造检测的多样性子集。在列出的语言子集中,片段数量和时长随目标说话人数量增加,而 XTTS-v2、FreeVC24 和 VITS 等模型变体在单种语言内提供相近的输出规模。模仿子集对应高度接近目标说话人的合成语音,支持对冒充攻击和说话人验证薄弱环节的研究。多样性子集被描述为覆盖更广泛的合成语音,符合提升多语言音频深度伪造检测的目标。列出的子集包含男性和女性目标说话人,片段数和总时长因语言和生成模型而异。
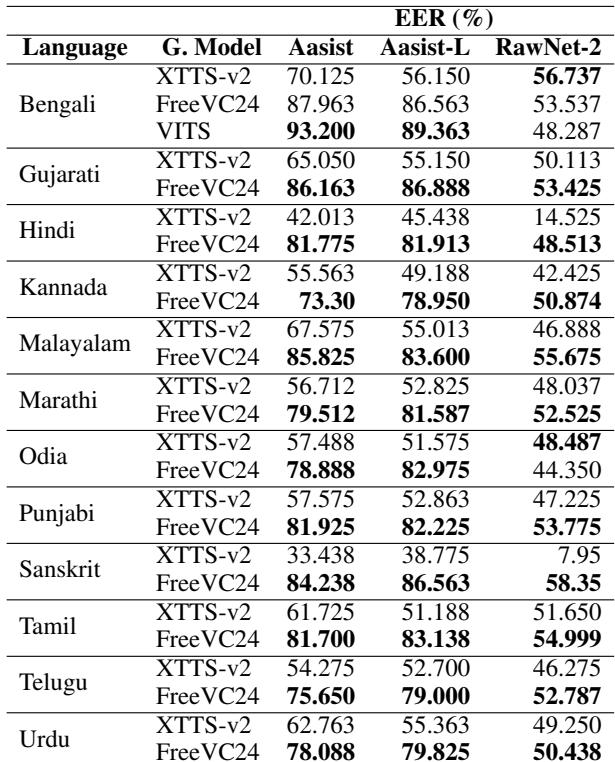
被评测的音频深度伪造检测模型在 IndicSynth-IndicSuperb 上的错误率远高于其先前报告的英语基准性能。在可用印度语语言和生成模型中,检测仍然困难,三个模型在无自适应情况下都难以区分真实语音和合成语音。在所显示结果中,RawNet2 受影响似乎小于 Aasist 和 Aasist-L,但其错误率仍然偏高。英语训练的 ADD 模型在没有领域自适应的情况下,对未见印度语合成语音泛化较差。多个语言和合成来源上的高 EER 值表明在 IndicSynth-IndicSuperb 上判别能力较弱。
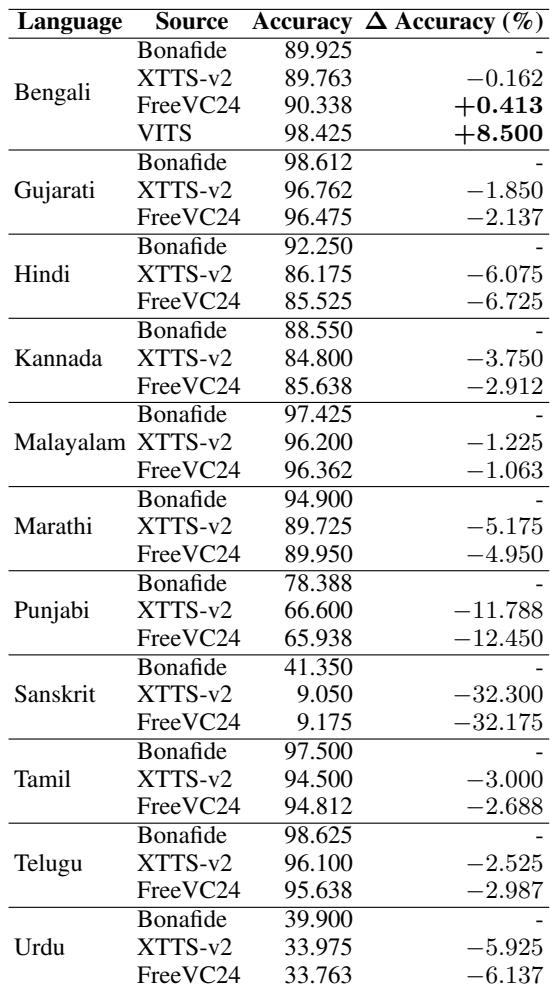
该评测使用语言识别检验合成 IndicSynth 音频是否保留目标语言的语言特征。多数真实和合成测试集的准确率超过 80%,合成测试集通常与真实表现接近。部分孟加拉语合成来源的准确率甚至超过真实音频,而奥里亚语通过嵌入可视化进行评估,因为语言识别模型不支持它。多数真实和合成测试集的语言识别准确率超过 80%。多数合成测试集相对真实音频的准确率差异较小,通常低于 10%。来自 FreeVC24 和 VITS 的孟加拉语合成音频达到比真实孟加拉语音频更高的准确率。古吉拉特语真实和合成结果保持较高水平,测试合成模型仅有小幅下降。
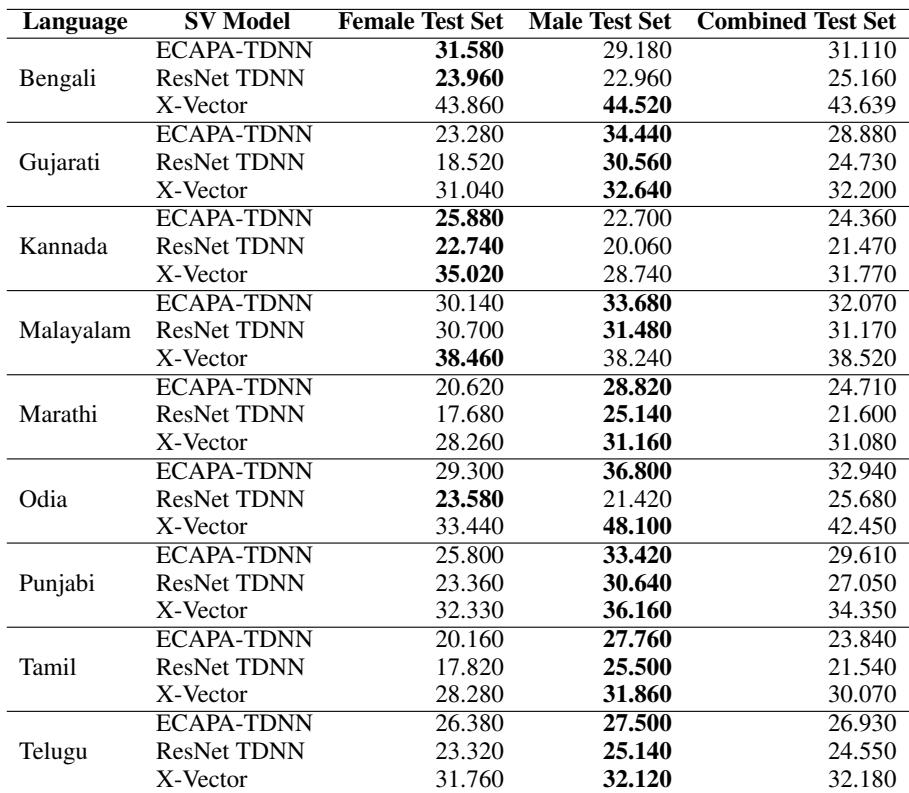
当负试验对包含与目标说话人真实语音配对的 IndicSynth 模仿音频时,说话人验证模型显示等错误率升高。这表明合成模仿语音高度接近目标语音,可能削弱被测模型区分真实配对与欺骗配对的能力。因此,模仿子集有助于评估冒充风险并提升说话人验证系统的鲁棒性。被测说话人验证模型在报告语言的基于模仿的负试验上表现出显著错误。在现有模型比较中,X-Vector 往往表现出高于 ECAPA-TDNN 和 ResNet TDNN 的错误率。特定性别的错误模式因语言和模型而异,表明对模仿攻击的脆弱性并不一致。
IndicSynth 被评估为一个多语言合成语音基准,涵盖由若干 TTS 和语音转换模型生成的说话人模仿子集和更广的多样性子集。实验表明,现有音频深度伪造检测器对未见印度语合成语音泛化较差,无论语言或生成器,其错误率都远高于英语基准。语言识别结果表明,合成音频大体保留目标语言特征并接近真实语音,而说话人验证实验显示,模仿攻击可高度接近目标语音并削弱模型判别能力,不同模型和性别的敏感程度存在差异。