Command Palette
Search for a command to run...
多语言模型中的类型学引导适配
多语言模型中的类型学引导适配
Ndapa Nakashole
摘要
多语言模型常常将语言多样性视为数据不平衡问题,而忽视了结构上的差异。我们引入了形态学指数(MoI),这是一种基于类型学的度量标准,用于量化语言在名词分类中对表面形态的依赖程度。基于MoI,我们提出了MoI-MoE,一种专家混合模型,它根据形态结构进行路由输入。在对10种班图语言(一个形态丰富且代表性不足的大语系)的评估中,MoI-MoE超越了强基线模型,在斯瓦希里语的名词类别识别上提高了14个百分点,同时保持了在祖鲁语等形态丰富语言上的性能。这些发现强调了类型学结构作为多语言模型适配中实用且可解释的信号。
一句话总结
来自加州大学圣迭戈分校和 Okalai AI 的研究者提出了 MoI-MoE,一种专家混合(Mixture of Experts)模型,利用形态学指数(Morphological Index,MoI)按形态结构对输入进行路由,在 10 种语言上将斯瓦希里语名词类别识别准确率提升了 14 个百分点,同时保持了祖鲁语等形态丰富语言的性能。
核心贡献
- 本文提出了形态学指数(Morphological Index,MoI),这是一种基于类型学的指标,用于量化一种语言在名词类别分类中对表层形态的依赖程度,将语言多样性重新定义为结构变异而非数据不平衡。
- 在 MoI 的基础上,本文提出了 MoI-MoE,一种按形态结构对输入进行路由的专家混合模型。这将领类型学视为架构设计原则,在结构相近的语言之间指导专家选择和参数共享。
- 在 10 种班图语言上的评估表明,MoI-MoE 在名词类别识别任务上优于单体模型和 token 重叠基线,将斯瓦希里语的准确率提升了 14 个百分点,同时保持了祖鲁语的性能。该模型还支持下游词性标注任务,并为缺乏名词类别标注的词典提供了可扩展的名词标注方案。
引言
作者解决了多语言建模中的一个结构性弱点:像 mBERT 和 XLM-R 这样的单体 Transformer 在类型多样的语言之间共享参数,这稀释了表示能力,导致在非洲低资源语言上表现不佳。此前的专门化工作(如 AfriBERTa 和 BantuBERTa)按谱系对语言进行分组,但这种分组过于粗略,无法捕捉功能差异;例如,斯瓦希里语和祖鲁语都属于班图语系,但在形态表层结构上差异显著。作者提出,模型分组应以结构类型学而非谱系为指导。
为了实现这一目标,他们引入了形态学指数(Morphological Index,MoI),这是一个连续、可解释的指标,用于量化一种语言在名词分类中对形态的依赖程度。随后,他们构建了 MoI-MoE,一种专家混合模型,其中每个专家专注于不同的形态区域,由一个轻量级、非学习的路由器根据 MoI 选择专家。这种由类型学驱动的路由在低形态语言中放大语义特征,同时保持高形态语言的准确率。作者通过三项分析验证了 MoI:与基于规则的准确率的相关性、与语义特征和形态特征的交互、以及路由性能。他们还将名词类别识别(Noun Class Recognition,NCR)定义为核心评估任务,发布了覆盖 10 种班图语言、包含 65K 个名词的数据集。此前的类型学感知工作将类型学视为元数据,使用来自 WALS 等数据库的粗略语言向量,但这些向量的填充过于稀疏,无法区分结构相似的语言;而本工作将领类型学视为架构设计原则,促进结构相近语言之间的迁移,并减少跨语言干扰。
数据集
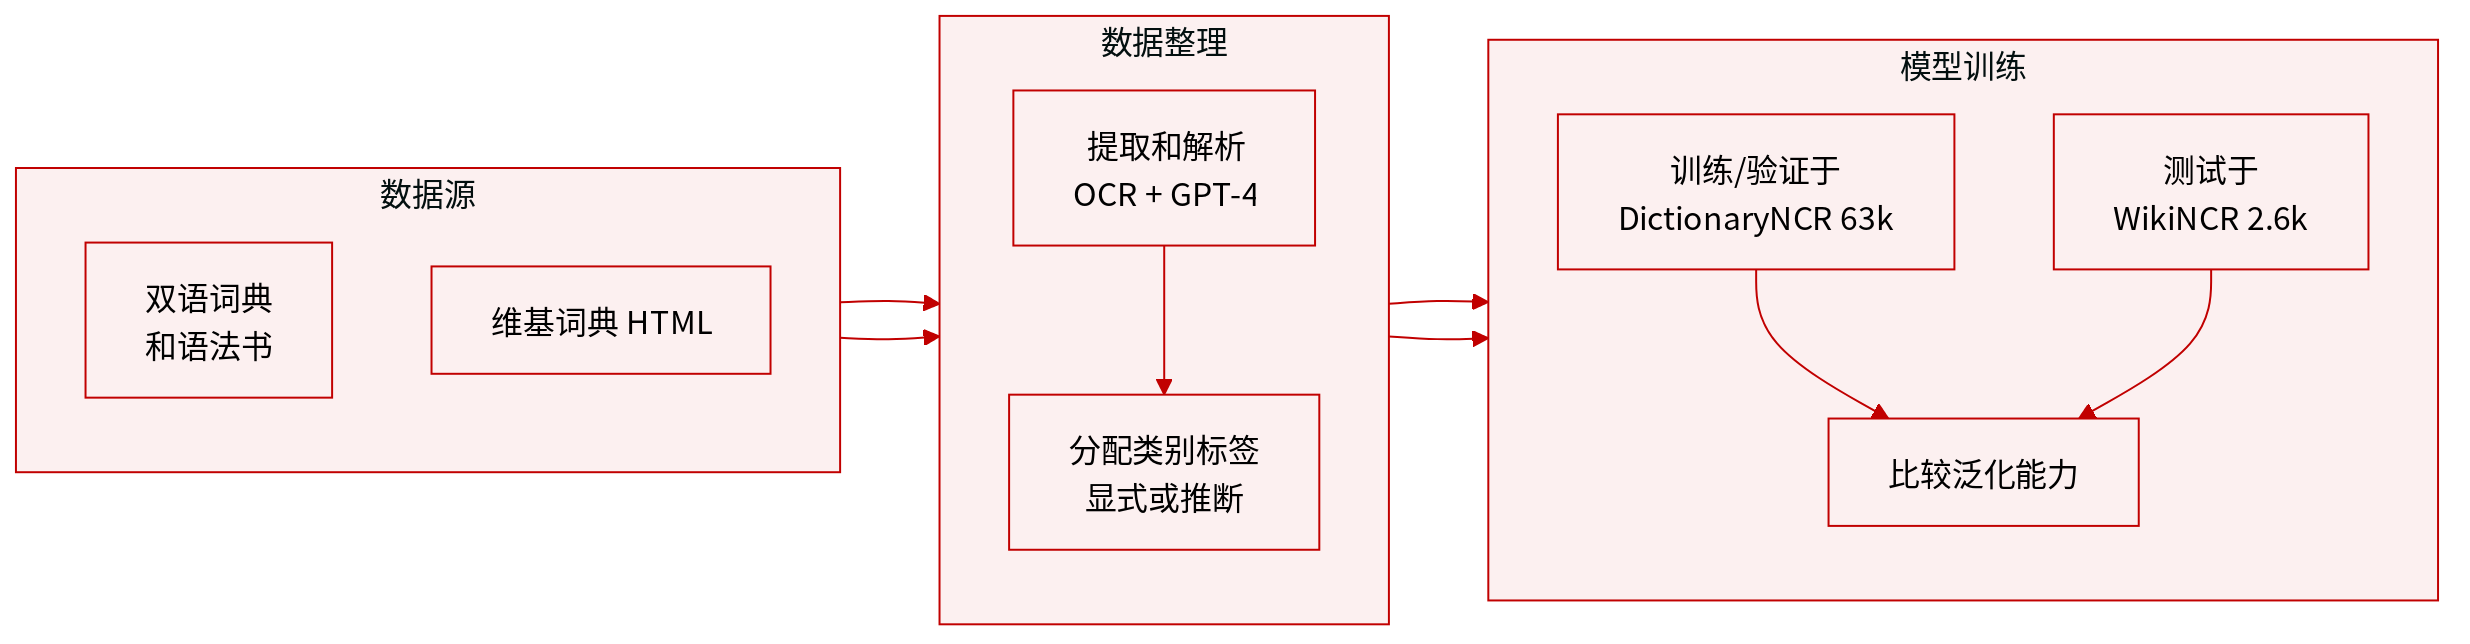
作者为班图语言的名词类别识别(NCR)构建了两个数据集。每个条目包含一个班图语名词、其类别标签、英文释义以及 GPT-4 扩充的定义。
数据集构成与来源
- DictionaryNCR 是主要数据集,包含约 63,000 个名词,涵盖 10 种语言。该数据集由通过 Google Books、美国国会图书馆、大学档案馆和在线来源获取的双语词典和语法书籍汇编而成。
- WikiNCR 是一个较小的域外测试集,包含约 2,600 个名词,涵盖 3 种语言,来源于 Wiktionary,其中某些语言提供了明确的名词类别标签(使用 BeautifulSoup 从 HTML 条目中解析)。
各子集的关键细节
- DictionaryNCR 的来源分为两类:
- 类型一(显式类别标签):斯瓦希里语、宽亚玛语、绍纳语、卢干达语和索托语的词典直接标注了名词类别。这些条目(共 62,844 条中的 31,524 条)仅需提取和格式化。
- 类型二(推断类别标签):恩东加语、姆本杜语、科萨语、祖鲁语和赫雷罗语的词典提供了带前缀的名词,但没有显式的类别标签。作者使用从语法中推导的映射规则从前缀推断类别标签,并通过前缀模式和释义启发式地解决歧义情况。
- WikiNCR 的覆盖范围有限,但可作为域外评估的补充测试平台。
处理与过滤
- 大多数 DictionaryNCR 来源为扫描件或 PDF 格式,因此作者使用 MathPix 进行 OCR,随后使用 GPT-4 进行解析和结构化。
- 对两种语言共 200 个样本的人工检查未发现幻觉内容,表明提取流程的质量良好。
论文中的用途
- DictionaryNCR 是主要的训练和评估数据集,而 WikiNCR 作为域外测试集用于评估泛化能力。
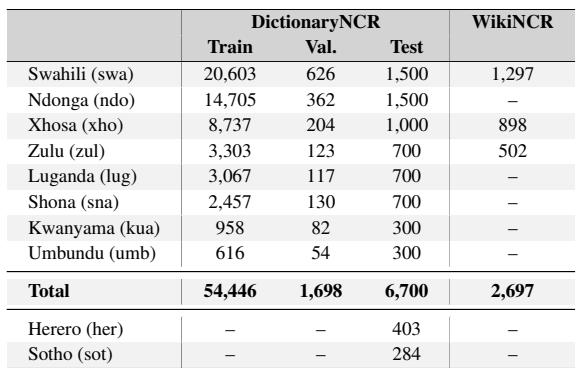
- 两个数据集的类别分布情况在附录中给出(DictionaryNCR 见表 9,WikiNCR 见表 10),总体统计结果汇总于表 3。
方法
作者提出了一种利用形态学指数(Morphological Index,MoI)指导名词类别识别(NCR)多语言模型设计的方法。MoI 通过将语言中所有名词类别前缀的字符长度相加,量化名词类别区分在表层形态中的标记明确程度。
参考展示班图语名词分解为前缀和词干的框架图。
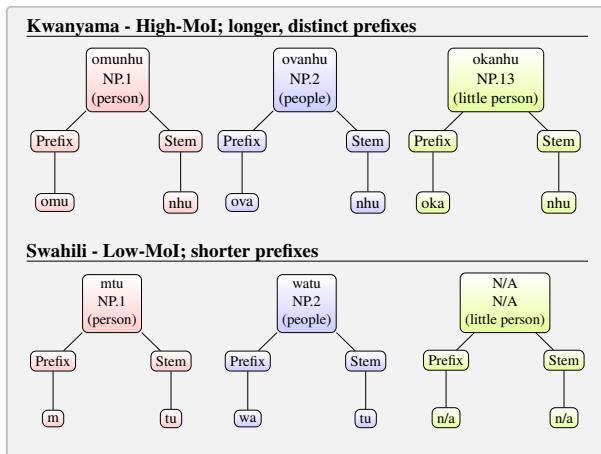
该指数的计算方式如下:
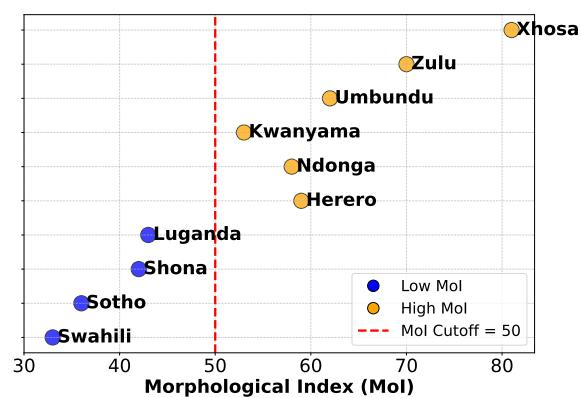
MoIl=c∈Cl∑∣pc∣其中 Cl 表示语言 l 中的名词类别集合,∣pc∣ 是类别 c 前缀的字符长度。该指标使系统能够区分高 MoI 语言(依赖更长、更具区分性的前缀)和低 MoI 语言(较短或重叠的前缀将分类负担转移给语义)。这些分数在语言间的分布呈现出明显的分离,使用 50.0 作为临界值将语言划分为不同的形态区域。
如下图所示,语言根据其 MoI 分数绘制,展示了形态依赖的梯度。
为了处理这些输入,模型使用两类主要特征。形态特征通过 SentencePiece tokenization 提取,使模型能够在没有显式监督的情况下学习与名词类别相关的子词模式。语义特征通过在训练时将每个班图语名词与其英文释义配对引入。这种方法通过预训练的英文嵌入将预测锚定在共享的语义空间中,补偿了大型语言模型对班图语言覆盖稀疏的问题。
基础模型基于 mT5-XL 构建,使用有监督的序列到序列目标进行微调。训练提示遵循以下结构:"给定班图语名词 [X],其英文含义为 [Y],预测其名词类别",其中 [Y] 包含扩展的定义。模型使用标准交叉熵损失进行优化:
LSFT(f(x),y;θ)=−k=1∑∣y∣logP(yk∣y<k,f(x);θ)为了确保在不同资源水平的语言之间实现稳健的泛化,训练过程中采用了均衡的语言采样。
核心架构创新是 MoI-MoE(Mixture of Experts,专家混合)框架,该框架根据输入语言的类型学特征调整模型。该架构采用轻量级、非参数化的路由器,根据输入的 MoI 分数将输入导向专门的专家。
参考展示路由机制的架构图。
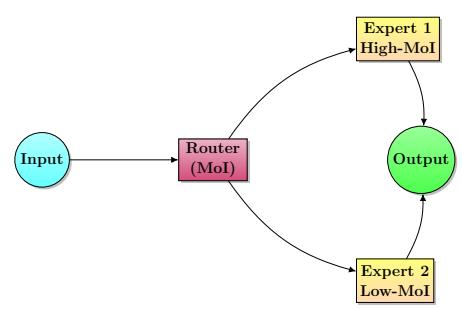
系统定义了两种不同的专家来处理不同的形态区域。高 MoI 专家针对子词 token 模式近似于前缀和词干且能提供强形态信号的语言进行优化。相反,低 MoI 专家面向前缀形式信息量较低的语言设计,这类语言需要模型更多地依赖英文释义提供的语义上下文。这种结构感知的路由使模型能够在类型学相似的语言之间进行泛化,即使这些语言在词汇上存在显著差异。
实验
在八种班图语言上的实验验证了 MoI 作为基于语言学的形态显著性度量:基于规则的分类器准确率与 MoI 相关(r = 0.75),而语义特征的增益与其负相关(r = -0.736),证实了低 MoI 语言依赖语义,而高 MoI 语言可以仅依赖形式。在专家混合模型(MoI-MoE)中,MoI 引导的路由实现了 92% 的准确率,优于 token 重叠基线(80%)和单体模型(89.9%)。消融实验证实了子词 tokenization 和名词类别前缀的必要性,探针实验表明 MoI 编码了超越增标(augment)存在的结构信息。错误分析显示,剩余的错误与结构歧义相关,例如高 MoI 语言中的前缀重叠和低 MoI 语言中含糊的鼻音前缀。在泛化方面,基于 MoI 的路由改善了对未见语言的零样本迁移,但跨数据集性能下降凸显了对词典风格输入的过拟合。将名词类别区分整合到词性标注中仅造成 1.0% 的准确率损失,影响较小。
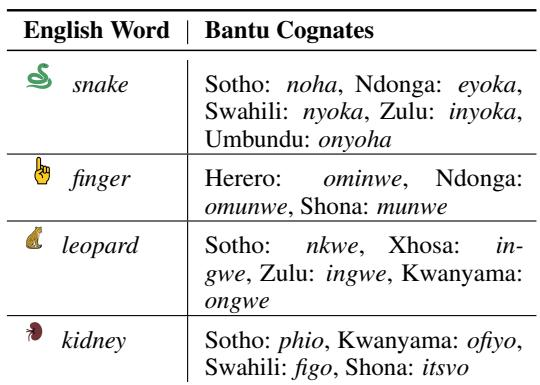
该表显示,班图语言在基本概念上共享同源词,但使用不同的名词类别前缀来实现,表明语音相似性并不保证结构相似性。这促使了形态学指数(MoI)的提出,该指数量化名词类别区分的标记明确程度。实验表明,MoI 引导的建模对这些结构变异敏感,影响错误模式和泛化能力。像"蛇"和"手指"这样的词的同源词共享词根,但在不同语言中名词类别前缀不同。高 MoI 语言使用更长、更具区分性的前缀,而低 MoI 语言由于前缀较短或存在重叠而更多地依赖语义。高 MoI 语言中的错误通常源于前缀重叠,而低 MoI 语言则表现为语义驱动的混淆。
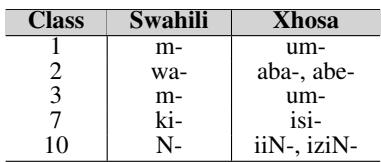
该表比较了斯瓦希里语和科萨语的名词类别前缀,揭示出虽然两种语言使用相似的类别系统,但其前缀形式在长度和多样性上存在显著差异。科萨语通常使用更长、更具区分性的前缀,而斯瓦希里语使用更短、常有重叠的形式,说明了形态标记在班图语言中的差异。科萨语的前缀(如 um-、aba-、isi-)普遍比斯瓦希里语(m-、wa-、ki-)更长,表明其形态区分度更高。斯瓦希里语对类别 1 和类别 3 使用相同的前缀 m-,科萨语对两者也使用相同的 um-,但科萨语还表现出更多的词缀变体,例如类别 2 的 aba-/abe- 和类别 10 的 iiN-/iziN-。
该表展示了两个数据集的统计信息:DictionaryNCR 是用于多种班图语言训练和开发的大型资源,而 WikiNCR 是面向其中部分语言的较小域外测试集。DictionaryNCR 为每种语言提供了充足的训练集和验证集划分,其中斯瓦希里语的样本量最大,而 WikiNCR 仅覆盖三种语言,规模小得多。两个数据集在范围和用途上有所不同,同时支持模型开发和泛化测试。DictionaryNCR 包含多种语言共计超过 60,000 个名词,其中斯瓦希里语和恩东加语的训练集划分最大。WikiNCR 仅限于斯瓦希里语、科萨语和祖鲁语,且规模远小于相应的 DictionaryNCR 划分。各语言的规模差异很大,反映了语言资源可用性的不均衡。
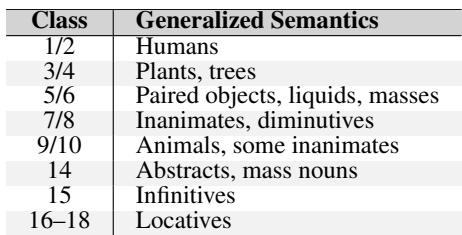
班图语名词类别映射到广泛的语义类别,例如人类属于类别 1/2,植物属于类别 3/4,动物属于类别 9/10,此外还有抽象名词和不定式等其他分组。这种语义规律性支持在名词类别识别建模中使用英文释义作为意义的代理。人类名词通常属于类别 1/2,而植物和树木出现在类别 3/4 中。类别 9/10 涵盖动物和一些无生命事物,类别 5/6 包括成对物体、液体和物质名词。其他类别涵盖抽象名词、物质名词和不定式,展示了类别系统中结构化的语义组织。
MoI-MoE 在班图语名词类别识别上取得了最高的总体准确率,优于基于 token 重叠的 MoE 和单体多语言模型。在斯瓦希里语等低 MoI 语言中,改进尤为显著,语义特征带来了实质性的价值提升;而在祖鲁语等高 MoI 语言中差异很小,表明仅依靠形态就足够了。错误分析显示,剩余错误源于结构歧义,前缀重叠和语义混淆因 MoI 水平而异。MoI-MoE 在八种班图语言上的表现均优于 token 重叠 MoE 和单体模型。语义特征在斯瓦希里语(低 MoI 语言)中带来了较大的准确率提升,但在祖鲁语(高 MoI 语言)中几乎没有增益。高 MoI 语言中的错误以前缀重叠为主,而低 MoI 语言则面临更多语义驱动的混淆。
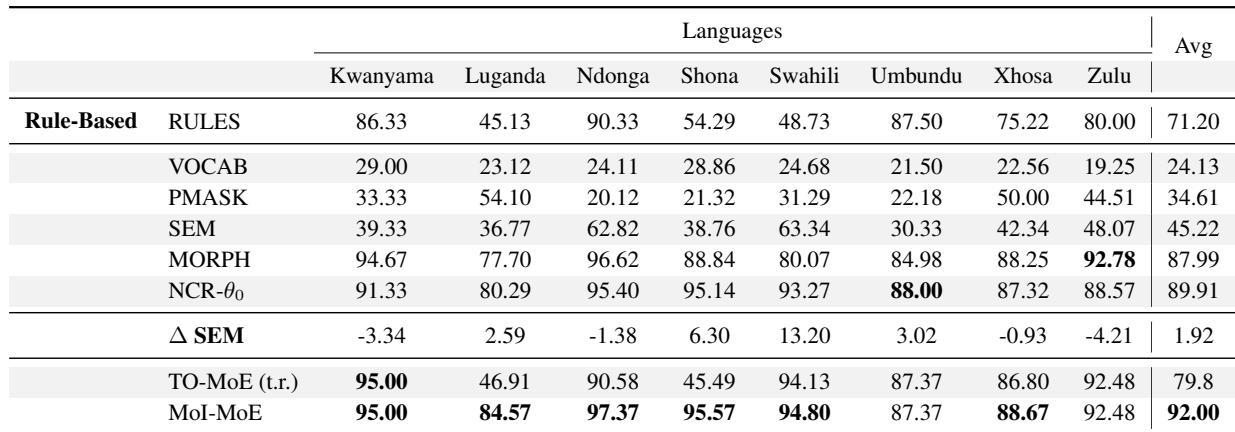
班图语名词类别识别实验使用形态学指数(MoI)量化形态明确性,并将 MoI 引导的专家混合(MoI-MoE)模型与基线进行了比较。该模型整体表现最佳,在斯瓦希里语等低 MoI 语言中的增益最大,其中语义特征弥补了前缀重叠的问题;而祖鲁语等高 MoI 语言则主要依赖形态。错误分析显示,高 MoI 语言的错误源于前缀重叠,而低 MoI 语言的错误由语义驱动。数据集在规模和领域上有所不同,并包含用于泛化测试的域外 WikiNCR 测试集。