Command Palette
Search for a command to run...
Getting Serious about Humor: Crafting Humor Datasets with Unfunny Large Language Models
Getting Serious about Humor: Crafting Humor Datasets with Unfunny Large Language Models
Zachary Horvitz Jingru Chen Rahul Aditya Harshvardhan Srivastava Robert West Zhou Yu Kathleen McKeown
摘要
Humor is a fundamental facet of human cognition and interaction. Yet, despite recent advances in natural language processing, humor detection remains a challenging task that is complicated by the scarcity of datasets that pair humorous texts with similar non-humorous counterparts. We investigate whether large language models (LLMs) can generate synthetic data for humor detection via editing texts. We benchmark LLMs on an existing human dataset and show that current LLMs display an impressive ability to “unfun” jokes, as judged by humans and as measured on the downstream task of humor detection. We extend our approach to a code-mixed English-Hindi humor dataset where we find that GPT-4’s synthetic data is highly rated by bilingual annotators and provides challenging adversarial examples for humor classifiers.
一句话总结
哥伦比亚大学和 EPFL 的研究者证明,大语言模型能够通过把笑话改得不幽默来生成用于幽默检测的合成数据,其中由 LLM 生成的非幽默对应文本可以作为分类器具有挑战性的对抗样本,并且他们将该方法扩展到英语和印地语混合的幽默数据集。
核心贡献
-
该论文在人工整理的 Unfun 任务上对大语言模型进行基准测试,发现 GPT-4 和 GPT-3.5 等模型在从文本中移除幽默方面可以胜过人工编辑。
-
该论文将模型生成的不幽默编辑结果重新用作幽默检测的合成配对数据,证明这些编辑结果可以支持训练幽默分类器,并扩展对齐的幽默与不幽默示例。
-
该论文将该方法扩展到英语和印地语混合的幽默数据集,在该数据集上,GPT-4 生成的不幽默变体获得双语标注者的高分评价,并为在原始语料上训练的分类器提供了具有挑战性的对抗样本。
引言
大语言模型在许多语言任务上表现良好,但仍然难以可靠地检测、解释和生成幽默,这一局限很重要,因为 AI 系统越来越多地用于社交、创作和安全敏感场景。先前的计算幽默研究高度依赖人工整理的数据集,例如 Unfun 语料,虽然这些资源有用,但规模和范围有限,因为高质量标注困难且成本高昂。作者利用创造幽默与移除幽默之间的不对称性,证明 GPT-4 和 GPT-3.5 等模型在把幽默标题编辑成不幽默版本方面可以胜过人类。作者利用这一能力来生成大规模合成配对数据集,用于训练幽默分类器,并将该方法扩展到英语和印地语混合数据集,在该数据集上,合成示例获得双语标注者的高分评价,并提供具有挑战性的测试数据。
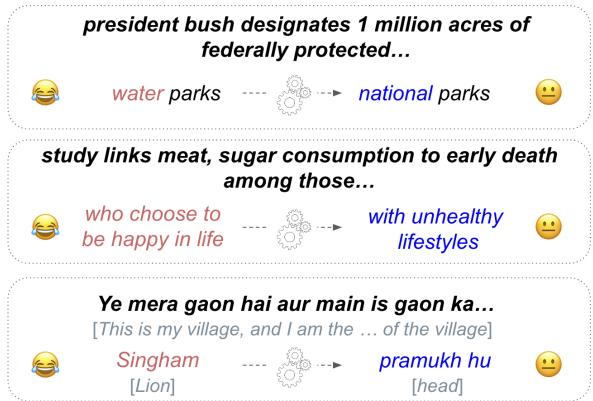
数据集
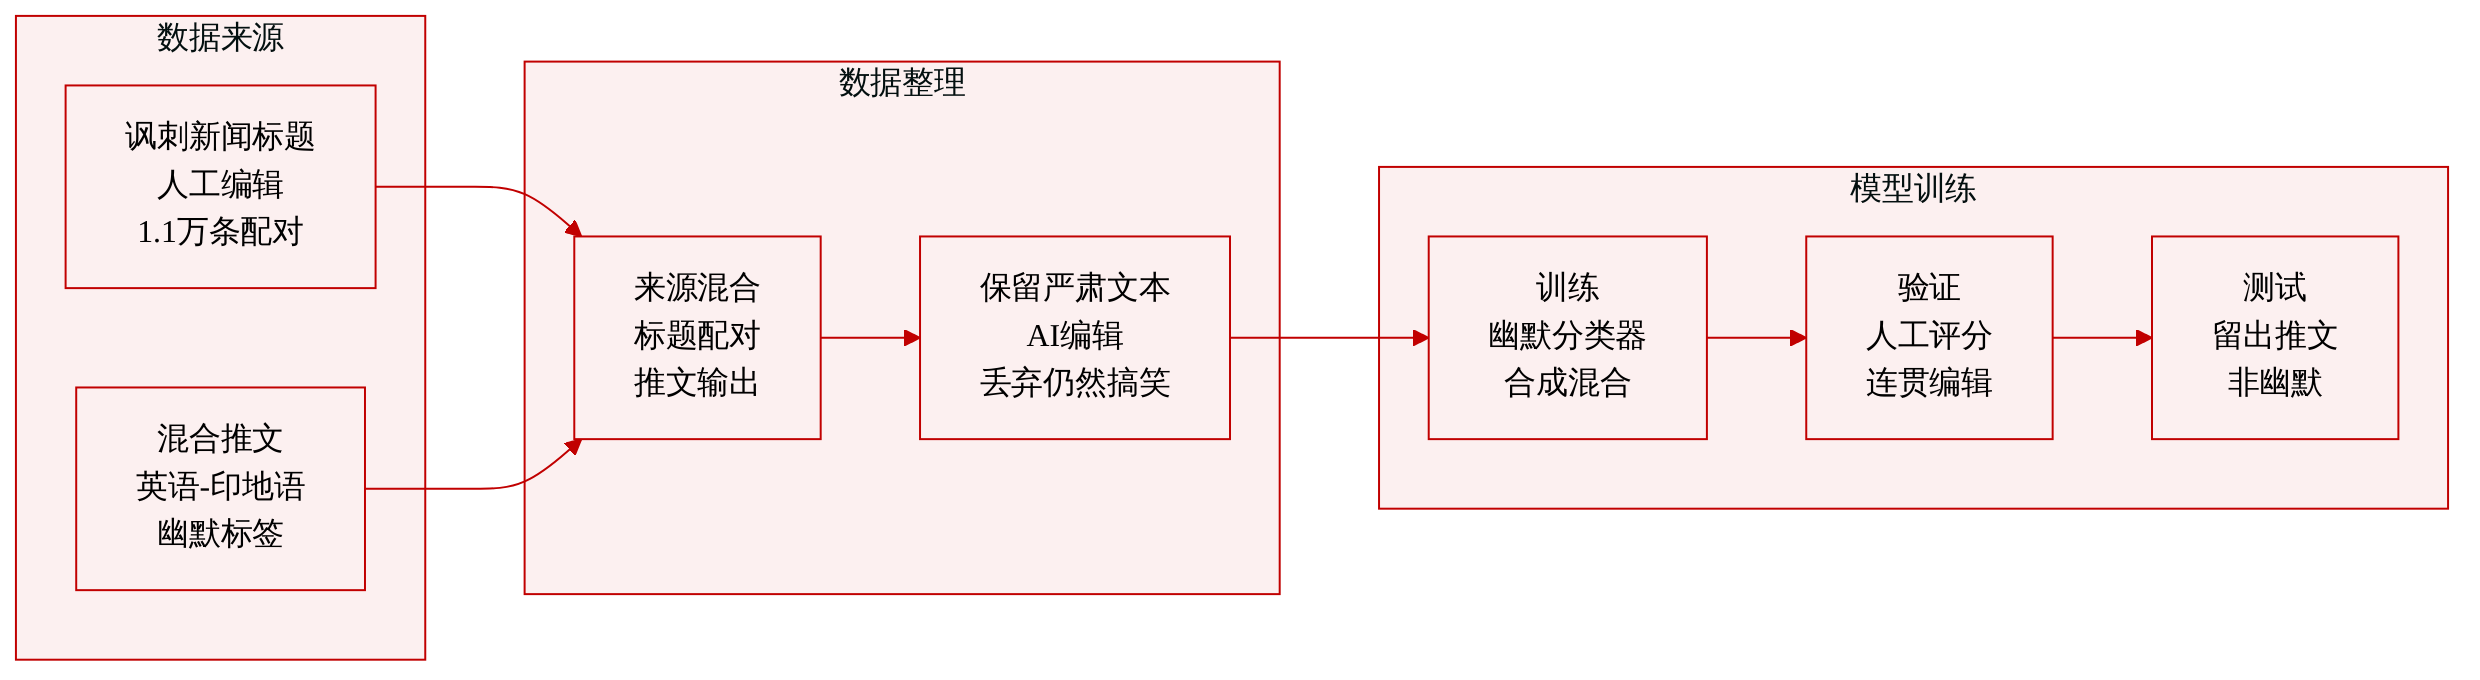
-
该论文建立在 Unfun 数据集之上,该数据集最初来自人类游戏玩法,其中玩家把讽刺性的 The Onion 标题编辑成看起来严肃的标题。
-
主要的 Unfun 子集包含约 11K 个讽刺标题到严肃标题的配对,其中还有一个由玩家评分的较小子集。
-
作者将这些讽刺标题与不幽默化标题的配对作为基准,用于比较 LLM 和人类玩家在保留原始文本结构的同时移除幽默的能力。
-
该数据集的构建依赖双向奖励信号:编辑后的标题应在 token 级别上与原讽刺文本保持相似,并被其他玩家判定为具有令人信服的严肃性。
-
作者还将数据集扩展到英语和印地语混合的 Twitter 数据,起点是此前已被标注为幽默或非幽默的推文。
-
对于该扩展子集,提示 GPT-4 将幽默推文改得不幽默,并通过移除 GPT-4 仍分类为幽默的示例来过滤生成的输出。
-
随后,双语人类标注者对 GPT-4 生成的不幽默推文以及原始样本进行评分,以评估质量和幽默移除效果。
-
作者还使用一个预留的、被判定为连贯且成功不幽默的合成推文集合,来测试在训练中使用不同比例合成非幽默数据的幽默分类器。
方法
不幽默生成流程旨在把幽默或讽刺文本转换为更字面、更严肃的文本。整体方法结合两种互补策略:少样本大语言模型提示和紧凑的概率 token 编辑模块。
在少样本生成设置中,每个输入幽默文本都与简短任务说明和少量示例配对一起提供给语言模型。每个示例由一个输入幽默文本和对应的输出严肃文本组成。这些示例并非任意选取;它们来自已被判定为高质量的人类评分示例子集。这一采样策略旨在鼓励生成的严肃改写具有多样性,同时保持各个示例之间的风格和任务格式一致。该流程使用多个指令跟随和非指令语言模型进行评估,包括大规模闭源模型和较小规模的开源模型。中心假设是,在给定足够的提示结构和代表性示例后,语言模型可以充当风格改写器,抑制讽刺或幽默信号。
第二个组件是基于掩码语言模型的轻量级 token 编辑方法。该方法的动机是观察到幽默通常与意外性相关,而幽默标题可能表现出更高的困惑度。该方法记为 ROBERTA-SWAP,它使用预训练的掩码语言模型来识别并替换在标题局部上下文中显得不太可能的 tokens。给定标题序列 x=(x1,x2,…,xn),模型通过掩码原始 token xi 并计算可能替换项上的概率分布来考察每个位置 i。设
piorig=pMLM(xi∣x−i)为掩码语言模型在位置 i 上赋予原始 token 的概率,并设
x^i=argvmaxpMLM(v∣x−i)为掩码语言模型预测的最可能替代 token。替换概率则为
pipred=pMLM(x^i∣x−i).根据原始 token 概率与预测替代概率之间的比率对位置进行排序,例如
ri=pipredpiorig.如果原始 token 与模型最可能替代 token 之间存在明显不匹配,这些位置会被视为编辑候选。流程从这些候选中选取 k 个位置,并迭代地将每个被选中的 token 替换为其最高概率的掩码语言模型预测结果。
从概念上说,ROBERTA-SWAP 在 token 层面对标题进行有针对性的平滑。它不是通过生成来改写整个文本,而是专注于引入意外性或异常概率质量的局部元素。通过用更可预测的替代项替换这些 tokens,该方法生成原始文本更字面的版本。这种设计在计算上比完整生成式编辑更轻量,因为它依赖掩码评分而不是自回归解码,并直接操作化了幽默、意外性和 token 级似然之间的联系。
实验
这些实验通过自动幽默分类和人类评分来评估合成 Unfun 数据,并将 LLM 生成的幽默文本和不幽默编辑结果与人类讽刺文本和众包工作者编辑结果进行比较。结果表明,LLM 在生成接近人类质量的幽默方面表现较弱,但能够可靠地编辑掉幽默,有时胜过众包工作者,并生成有帮助于检测器的对齐不幽默数据。对英语和印地语混合数据的额外评估表明,这种编辑能力可以泛化,但分类器仍然容易受表面线索影响,并且主观幽默判断使评估更加复杂。
在两个编辑方向上,使用语言模型移除幽默都比生成幽默更容易。合成不幽默数据,尤其是来自 GPT-4 的数据,帮助幽默分类器达到最强的留出集性能,并且接近人工编辑数据,而真实新闻标题表现较差。合成幽默仍然弱于人工编辑数据或不幽默基线,尽管编辑距离显示原始幽默内容大体上被保留。GPT-4 的不幽默示例在两个方向上都能实现最佳的分类器准确率。对齐的合成数据胜过真实新闻标题,但合成幽默落后于不幽默基线
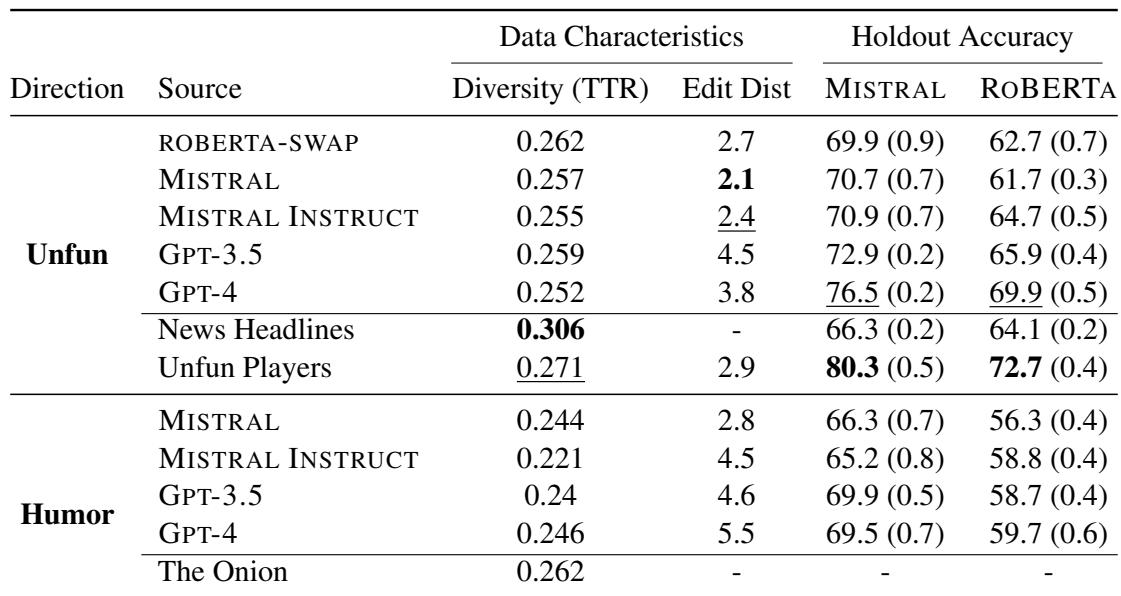
人类评估表明,模型生成的讽刺幽默仍然没有原始 The Onion 标题那么有趣,也没有那么令人信服。与此同时,生成的不幽默编辑结果通常被判定为真实新闻,并且仍然语法正确、连贯,在不幽默程度上也与人工编辑示例相近。GPT-3.5 和 GPT-4 都能生成幽默文本,二者之间没有明显的质量差距。与人工编辑的不幽默示例相比,合成不幽默示例更有可能被评价为真实新闻。ROBERTA-SWAP 在趣味性和真实标题评分上与人类玩家相当,但在连贯性上落后。
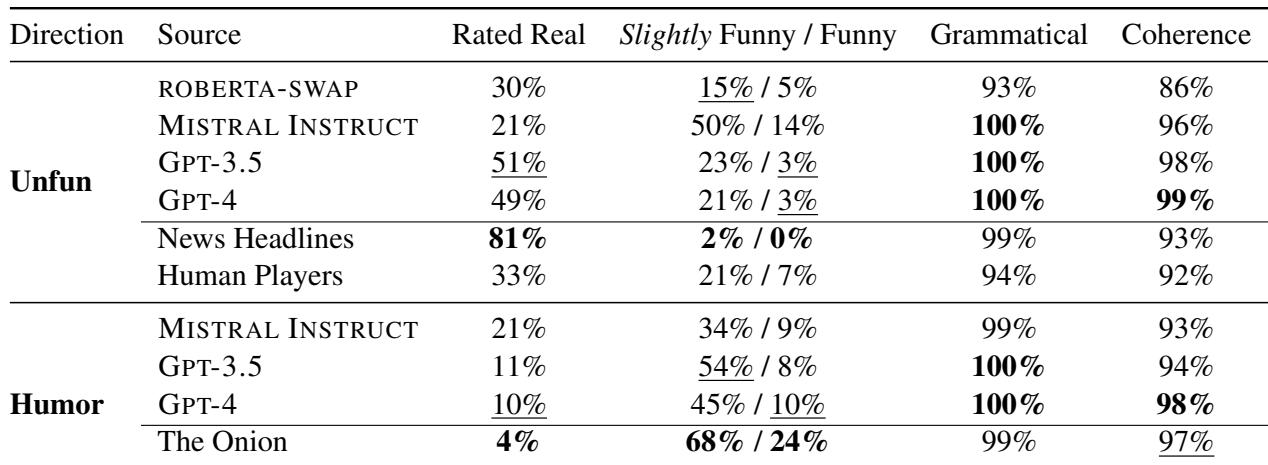
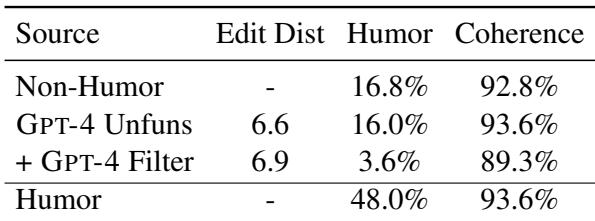
人类评估显示,GPT-4 编辑后的英语和印地语混合推文被评为没有原始幽默推文幽默,并与非幽默推文评分相近,同时保持较高连贯性。使用 GPT-4 过滤器会进一步降低幽默评分,但保留下来的样本更少,并且连贯性略低。这些结果支持 GPT-4 能够把幽默的混合语言推文转换为非幽默文本,尽管它需要的编辑比英语讽刺标题场景更多。GPT-4 编辑大幅降低原始幽默推文的幽默评分,同时保持较高连贯性。GPT-4 过滤生成一个更小的集合,这些样本被认为幽默程度明显更低,但只带来轻微的连贯性损失。人类非幽默推文和 GPT-4 不幽默推文获得相近的低幽默评分。
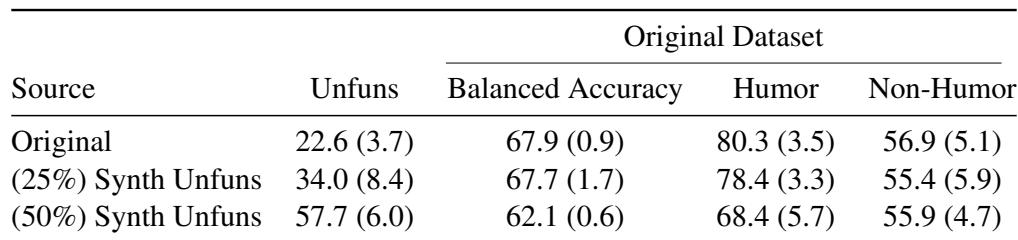
在原始英语和印地语混合推文上训练的幽默分类器对经过人工审核的不幽默样本泛化较差,这表明它们依赖表面线索,而不是稳健的幽默理解。在训练中加入合成不幽默示例会显著提高这些对抗样本上的准确率,但这种提升伴随着在幽默示例和平衡原始示例上的准确率下降。仅在原始数据上训练的模型在不幽默推文上表现较差。加入合成不幽默数据会在不幽默样本上产生最高准确率。使用更多合成不幽默数据进行训练会降低原始数据集上的平衡准确率和幽默准确率。
这些实验使用英语讽刺标题和英语和印地语混合推文的合成编辑,并结合分类器训练和人类判断,来评估幽默生成与移除。移除幽默比生成幽默更容易、更可靠:GPT-4 合成不幽默示例接近人工编辑,并增强分类器性能,而合成幽默没有人类原始文本那么有趣,也没有那么令人信服。人类评估还表明,生成的不幽默编辑可以类似于真实新闻并保持连贯性,但仅在原始数据上训练的分类器依赖表面线索;通过合成不幽默数据提升对抗鲁棒性会牺牲部分原始数据准确率。