Command Palette
Search for a command to run...
贪心足矣:分词器推理方法评估
贪心足矣:分词器推理方法评估
Omri Uzan Craig W. Schmidt Chris Tanner Yuval Pinter
摘要
尽管 BPE 和 WordPiece 等子词分词器通常被用于构建 NLP 模型的词表,但将这些词表中的文本解码为 token 序列的方法往往未被明确指定,或与其构建方式不匹配。我们在一个为英语精心构建的新型内在评估套件上,对四种分词算法和三种词表大小共七种分词器推理方法进行了受控分析,该套件综合了形态学、认知科学与信息论的度量指标。结果表明,对于最常用的分词器,贪心推理的表现出人意料地出色;而 SaGe——一种近期提出的上下文感知分词器——在形态学对齐方面优于所有其他方法。
一句话总结
内盖夫本-古里安大学、Kensho Technologies 和 MIT 对 BPE、WordPiece、Unigram 和 SentencePiece 中的七种切分推断方法进行了受控评估。结果显示,对于常见子词 tokenizer,贪婪推断表现意外地稳健,而上下文信息更充分的 SaGe 方法在形态对齐方面优于其他所有方法。
核心贡献
- 该工作将子词 tokenizer 的推断与词汇表构造分离,在四种 tokenizer 算法和三种词汇表大小下比较七种推断方法,以阐明解码选择如何影响英文 token 序列。
- 本文提出了一个用于英文子词切分的内在评估套件,它结合形态、认知和信息论指标,为切分质量评估提供基准。
- 结果显示,在测试词汇表上贪婪推断表现强劲,SaGe 取得了最先进的形态对齐效果,而最小化 token 数的方法在认知指标上得分最高。
引言
作者关注现代 NLP 系统(包括大语言模型)中的子词切分,其中推断方法将原始文本映射为 token 序列。这一步骤很重要,因为所选映射会影响下游模型如何表示和处理语言。先前工作主要研究词汇表构造、词汇表大小、多语言词汇表和词汇表效应,而推断方法缺少系统研究,并且常常被主流 tokenization 工具隐藏。作者通过受控实验在四种 tokenizer 上隔离推断方法,并提出了一个覆盖形态、信息论和认知指标的内在评估基准,以弥补这一缺口。结果显示,贪婪推断在不同词汇表上表现良好,SaGe 实现强形态对齐,而最小化 token 数的方法在认知指标下表现良好。
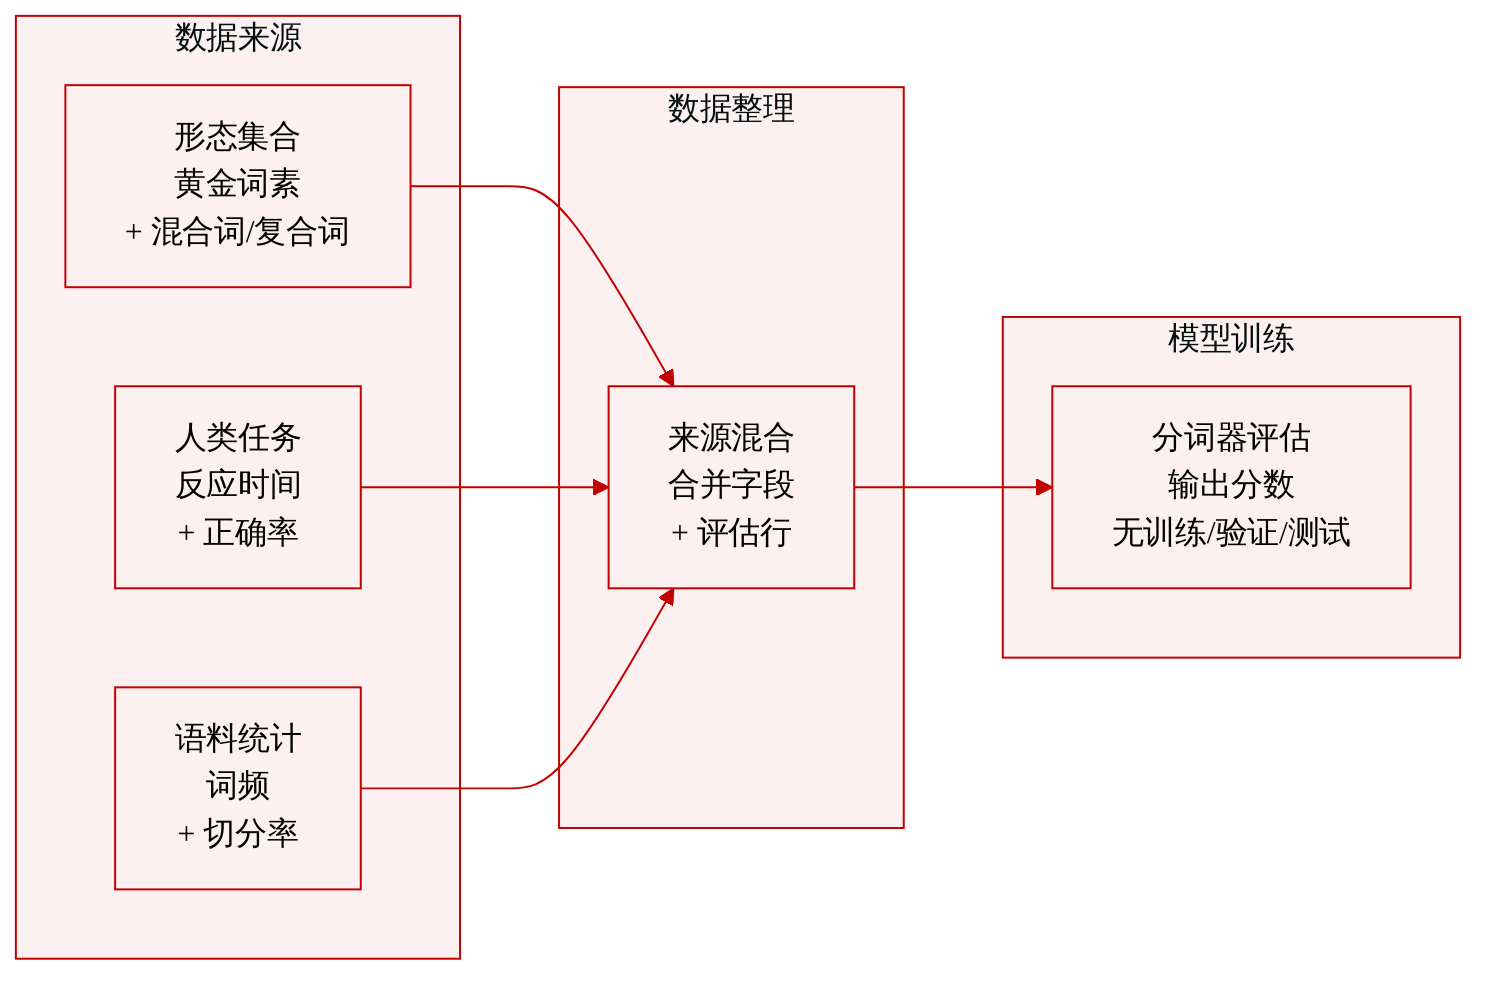
数据集
-
作者创建并发布了一个用于评估英文子词 tokenizers 的内在基准,它由词级数据集和预计与下游语言建模或机器翻译性能相关的信息指标构成。
-
该基准包含三个主要数据组件:
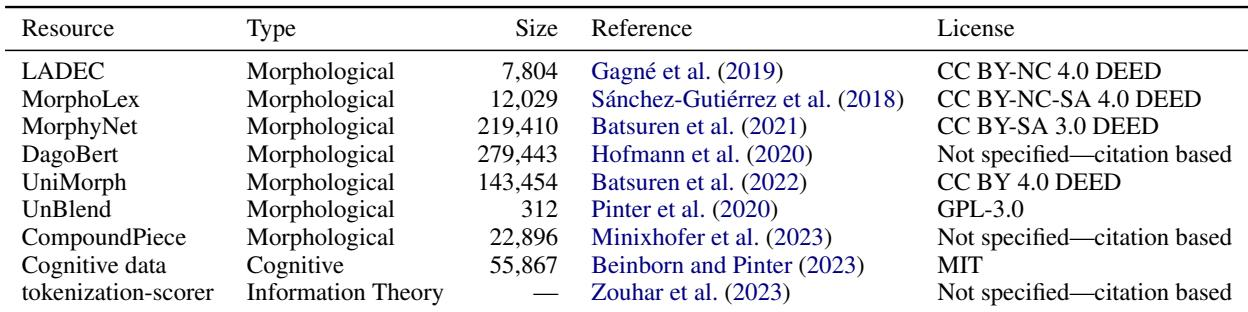
- 形态对齐数据:来源于 LADEC、MorphoLex、MorphyNet 和 DagoBert,并增加了语素切分、新型混成词结构检测和复合词分离数据。表 2 中给出了每个资源的词数。
- 认知合理性数据:取自 Beinborn 和 Pinter (2023),由人类词汇决策任务记录组成,包含四种语言设定下的反应时间和正确率。
- 语料库级切分统计:在参考语料库上计算,用于度量 token 分布属性和切分行为。
-
对于形态对齐,作者使用 Creutz 和 Linden (2004) 的指标比较 tokenizer 生成的词切分与金标准形态切分,并报告跨资源的宏平均 F1 分数。
-
对于认知合理性,作者度量 tokenizer 输出与人类反应时间和正确率之间的相关性,并报告四种设定下的平均绝对相关性。
-
对于分布和切分统计,作者报告 Rényi 效率、每个词的平均 tokens,以及与默认切分不同的 pretokens 比例。作者省略了 token 字符长度分布,因为它不会随切分策略改变。
-
这些数据用于 tokenizer 内在评估而非训练:除现有任务字段和金标准标注外,没有描述训练划分、混合比例、裁剪策略或额外元数据构造。
方法
作者将切分过程解耦为两个相对独立的组件:词汇表构造和推断。固定的子词词汇表 V 从预训练数据中学习得到,而推断方法决定一个词,即 pretoken w,应如何切分为子词 tokens。形式化地,切分定义为:
s(V,w)=(t1,…,tk)其中每个 ti∈V,并且所有 ti 的拼接重建 w。这种分离使作者能够保持词汇表不变,并使用内在指标比较不同推断策略。核心假设是,切分质量不仅取决于学习得到的词汇表,还取决于推断过程中应用该词汇表所使用的算法。
方法围绕三类推断算法展开:贪婪方法、基于合并规则的方法和基于似然的方法。每一类都定义了不同的优化策略来选择有效切分。
贪婪推断方法通过一次选择一个 token 来逐步生成切分。第一种变体是最长前缀,它从左侧扫描 pretoken,选择与当前前缀匹配的最长词汇表 token。然后移除该 token,并在剩余字符串上重复此过程。该策略与许多语言的形态切分方式天然一致,尤其是在后缀跟随前缀之后。
第二种贪婪变体是最长后缀,它从右侧扫描,选择与当前后缀匹配的最长词汇表 token。该方法主要作为诊断基线。由于英文单词通常以前缀开头,后缀优先策略可能产生语言学对齐度较低的切分。因此,比较长前缀和最长后缀有助于揭示语言结构在多大程度上影响推断方法的有效性。
第三种贪婪变体是最长 token,它在整个 pretoken 中搜索其中包含的最长词汇表子串。该子串被加入输出切分,剩余字符序列再递归切分。这种方法用最富信息的子词片段近似一个词,并倾向于比严格的从左到右前缀选择更灵活地保留形态结构。
基于合并规则的推断方法从词的字符序列开始,并反复应用词汇表构造期间学习到的合并规则。在确定性设定中,算法按照训练得到的合并列表中的顺序递归应用第一个适用合并规则。这是字节对编码使用的标准推断模式。切分完全由可用合并的顺序和有效性决定。
作者还测试了一种称为 Dropout 的随机变体。与在适用时总是应用合并规则不同,该策略以概率 p 应用每个有效合并。这在推断时引入正则化。稀有 tokens 在训练期间更可能暴露,从而让其 embeddings 有更多机会学习有用表示。该方法可以通过降低对非常频繁的子词 tokens 的过度依赖来改善下游行为,尤其是在面向生成的任务中。
基于似然的推断方法将切分视为概率优化问题。每个 token 都关联一个似然值,目标是找到总似然最大化的切分。在默认 Unigram 语言模型设定中,一个切分的似然是各个 token 似然的乘积。因此,切分通过最大化所选 token 序列的联合概率来选择。
一种更简单的基于似然的目标函数给每个 token 分配相同的常数似然。这会将推断过程推向包含更少 tokens 的切分,因为在常数似然模型下,较少的 token 选择会产生更高的总分数。该目标与 PathPiece 使用的最小切分偏好密切相关。虽然它没有直接使用学习到的似然值,但它通过将效率偏好转化为优化目标,仍然在基于似然的框架内运作。
这些模块共同构成模块化的切分流水线。作者首先构造或假定固定词汇表,然后应用不同推断算法从同一词汇表产生切分。该设计使作者能够将推断行为的影响与词汇表学习的影响隔离,从而系统分析切分策略如何影响 token 质量、形态对齐和下游 token 使用。
实验
实验建立了子词 tokenizers 的内在基准,使用形态对齐、认知合理性和 token 分布指标来验证切分如何影响语言结构、人类加工和效率。在 MiniPile 上训练的 BPE、UnigramLM、WordPiece 和 SaGe 中,结果显示推断策略会实质改变 tokenizer 行为,并且默认方法并非始终最优。总体结论揭示出权衡关系:SaGe 更有利于形态,紧凑切分提升 token 经济性以及一些认知信号,而基于似然的方法尽管有既定目标,常常表现不足。
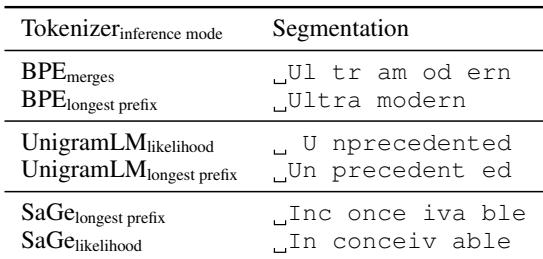
示例显示,即使底层词汇表固定,tokenizer 推断选择也会改变词切分。BPE、UnigramLM 和 SaGe 的默认模式可能产生跨越语素边界的片段,而其他推断模式可以产生形态对齐更好的切分。BPE 基于合并的推断可能过早合并类似 am 的片段,从而掩盖更大的词部件。UnigramLM 基于似然的推断可能偏向跨越语素的形式,例如 nprecedented。SaGe 推断可能模糊前缀和后缀边界,但替代切分模式可以给出更清晰的形态切分。
该表汇总了为英文子词 tokenizer 基准汇编的形态资源,显示集合既包含小型专门数据集,也包含大得多的词级词表。每条记录都记录大小、来源和许可证,说明这些资源来源不同,并且许可条款混合。所列资源通过阐明哪些词级数据构成该基准的基础,支持形态对齐和认知合理性评估。基准池由规模差异很大的英文形态资源组成。专门资源比纳入基准的广泛形态词表更小。许可条款混合,包括 Creative Commons 选项,以及在未指定许可证时基于引用的条款。
在 40k 词汇表内在基准上,默认解码策略至少在某一指标上经常被其他推断方法超越。最长 token 和最少 tokens 方法往往在强形态对齐、认知合理性或 token 效率方面表现较好,而基于合并规则的方法暴露出对跨越形态边界的早期合并的敏感性。Dropout 相对于基于似然的方法提升了 Rényi 效率,但代价是与默认解码产生更大的差异。默认解码并非在所有指标上一致最优;最少 tokens 在 token 数和认知指标上表现良好;Dropout 在 Rényi 效率上优于基于似然的推断。
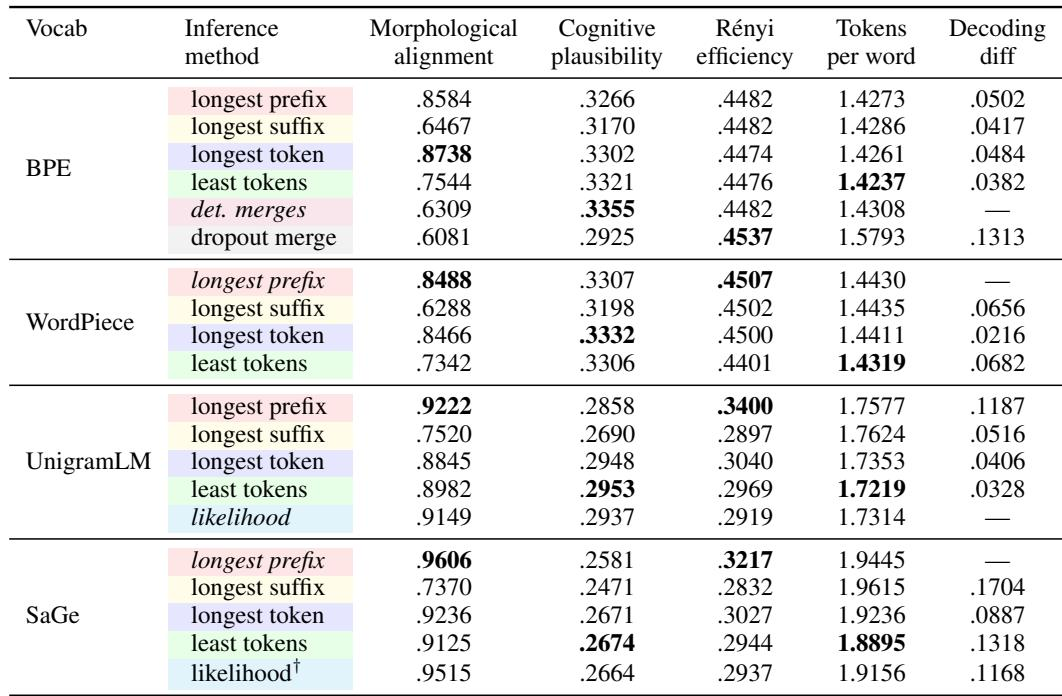
实验在由多样形态资源构建的固定英文基准上评估子词切分,关注不同解码策略如何影响词切分,而非词汇表大小。在各案例和内在基准中,默认推断常常产生跨越形态边界的片段,而替代模式可以产生更清晰的形态切分、更好的 token 效率和更强的认知合理性。基于合并的方法表现出对早期合并的敏感性,基于似然的方法可能偏向对齐较差的形式,Dropout 可以提升信息效率,但会增加与默认切分的偏差。总体而言,推断阶段的 tokenizer 选择会实质性影响形态对齐和切分质量。