Command Palette
Search for a command to run...
方言程度估计可预测多阿拉伯方言数据集中的标注者间一致性
方言程度估计可预测多阿拉伯方言数据集中的标注者间一致性
Amr Keleg Walid Magdy Sharon Goldwater
摘要
在对多阿拉伯方言数据集进行标注时,通常将样本随机分配给阿拉伯语母语标注者群体。近期研究建议将方言样本路由给各自对应方言的母语标注者,以构建更高质量的数据集。然而,自动识别样本的方言归属具有较大难度,且掌握特定阿拉伯方言的母语标注者资源可能十分稀缺。阿拉伯语方言程度(ALDi)是近期提出的一种量化指标,用于衡量句子偏离标准阿拉伯语的程度。在将样本随机分配给标注者的情况下,我们假设 ALDi 分数较高的样本更难被正确标注,尤其是当样本所用方言并非标注者所操方言时。为验证这一假设,我们分析了 15 个提供原始逐样本标注的公开数据集,涵盖多种句子分类任务,考察 ALDi 分数与标注者间一致性的关系。结果表明,其中 11 个数据集的证据有力支持了我们的假设。据此,我们建议优先将高 ALDi 分数的样本路由给对应对应方言的母语标注者,而此类样本的方言归属可通过自动方法以较高准确率加以识别。
一句话总结
爱丁堡大学的研究人员表明,阿拉伯语方言程度(ALDi)分数可以强烈预测 15 个多方言阿拉伯语句级分类数据集上的标注者间一致性,并建议将高 ALDi 样本优先路由给相应方言的母语者,以提高标注质量。
核心贡献
- Sentence-ALDi 模型被用于估计阿拉伯语方言程度(ALDi),并将其作为与标注者分歧相关的因素;该关系在包含六项阿拉伯语句级分类任务单独标注信息的 15 个公开数据集上进行了分析。
- 分析发现,在 12 个非方言识别数据集中,有 8 个数据集表现出更高的 ALDi 分数与更低的全员标注一致性相关;而 3 个方言识别数据集则显示,高 ALDi 样本的标注一致性更高。
- 结果支持一种路由工作流:先估计 ALDi,将低 ALDi 样本发送给任意阿拉伯语方言的使用者,并通过方言识别将高 ALDi 样本路由给相关方言的母语者。
引言
阿拉伯语自然语言处理需要同时处理现代标准阿拉伯语和方言阿拉伯语的混合情况,这一点很重要,因为用户生成文本经常混合使用标准化变体和地区变体。已有工作表明,将方言内容发送给非对应方言背景的标注者可能会损害准确性和公平性,但按方言路由数据具有挑战性,因为自动方言识别并不完美,而且某些方言的标注者可用性可能有限。作者利用阿拉伯语方言程度估计来优先分配工作:低方言性句子通常可由任意阿拉伯语使用者标注,而高方言性句子应路由给相关方言的母语者。
数据集
-
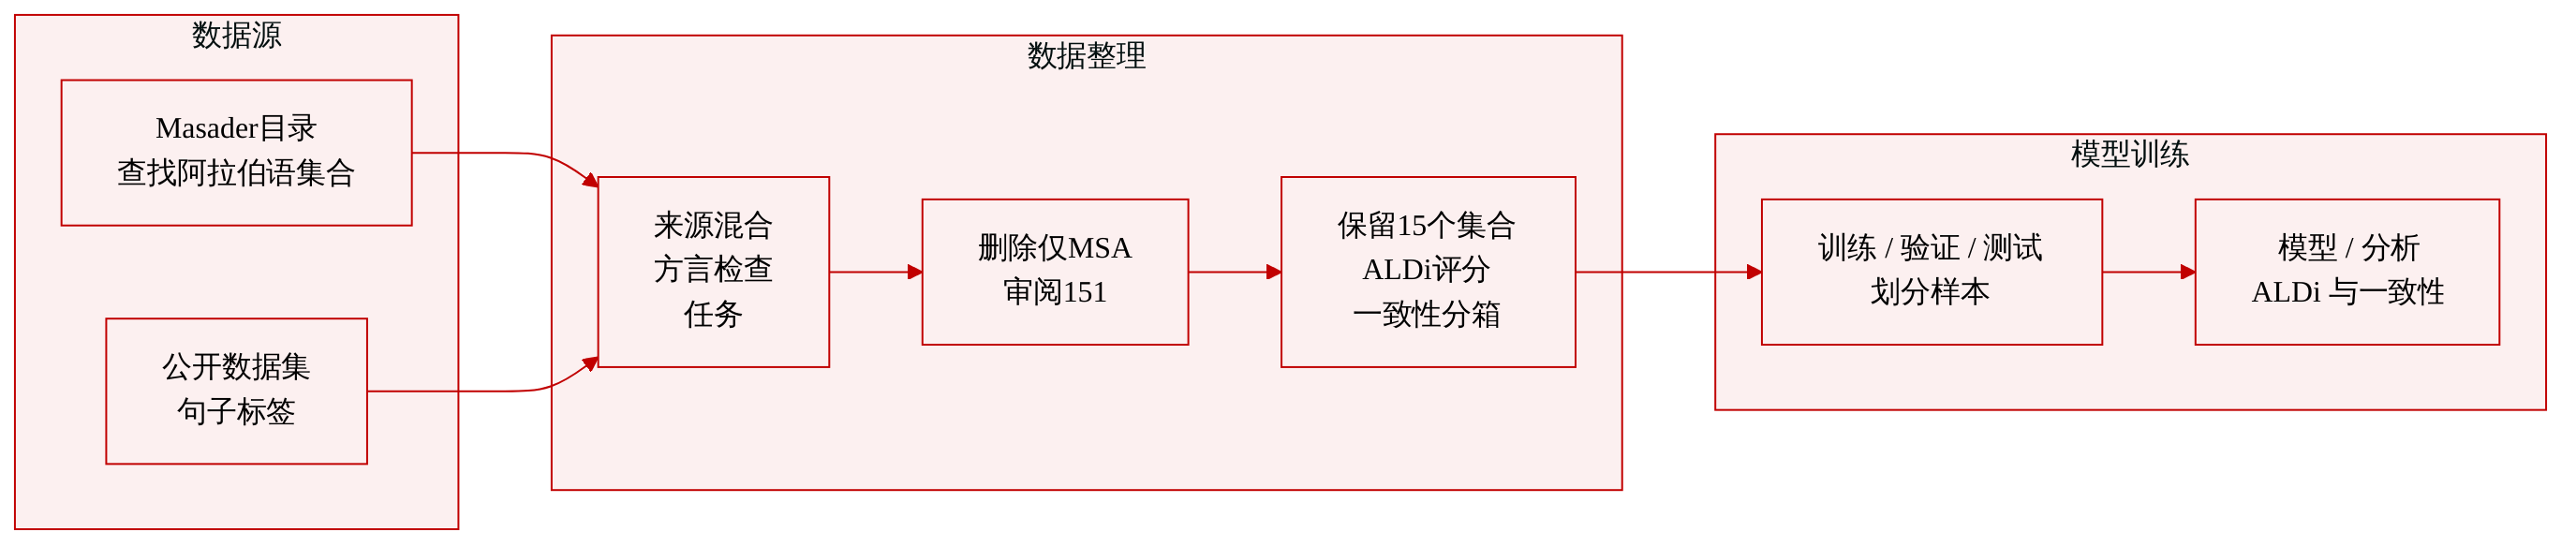
作者从公开发布的阿拉伯语数据集构建分析数据集,这些数据集混合了现代标准阿拉伯语和方言阿拉伯语,面向多种方言变体,使用句级分类任务,并包含单独标注者标签或标注者就多数标签达成一致的比例。
-
他们从 Masader 获取候选数据集,Masader 是一个由社区整理的阿拉伯语数据集目录,并使用每个数据集元数据中的阿拉伯语变体字段,过滤掉仅包含 MSA 样本的数据集。
-
他们人工检查剩余的 151 个候选数据集,识别出 28 个潜在匹配项,在单独标注信息未公开时联系数据集作者,最终保留 15 个数据集进行分析。
-
最终的 15 个数据集涵盖冒犯性文本分类、仇恨言论检测、反讽检测、情感分析、言语行为检测、立场检测和方言识别。
-
数据集由句级样本组成,每个句子都分配了标注者标签。标注者来自不同的阿拉伯语方言变体背景,并被随机分配到样本。
-
作者使用 Sentence-ALDi 模型计算阿拉伯语方言程度分数,为每个样本附加派生元数据。该分数范围为 0 到 1,其中 0 表示 MSA 或非方言性句子,1 表示强方言性句子。
-
他们使用派生的 ALDi 分数将样本分为宽度为 0.1 的十个区间。对于每个区间,计算所有标注者对单一标签达成一致的样本百分比。
-
处理后的数据随后用于检验更高的方言性分数是否与更低的全员标注一致性相关。
方法
作者利用一套过滤、评分和相关性分析流程,考察阿拉伯语方言程度(ALDi)与标注者间一致性之间的关系。工作流从候选句级分类数据集开始,这些数据集包含现代标准阿拉伯语和方言阿拉伯语的混合内容。合格资源必须面向多种方言变体,包含来自不同方言背景的标注者,并包含单独标签或多数标签一致性比例。该方法首先移除仅包含现代标准阿拉伯语材料的数据集,然后筛选剩余候选数据集的方言覆盖范围和标注格式。当可用标签不完整时,作者会从数据集作者处收集单独标注,以便进行一致性测量。
对每个保留样本,该方法通过 Sentence-ALDi 模型获得方言强度分数。该分数是区间 0 到 1 内的归一化标量,其中 0 表示被判断为非方言性或与现代标准阿拉伯语兼容的样本,1 表示强方言性样本。该分数在句子级别计算,与数据集的标注粒度一致。
一致性分析随后将连续 ALDi 分数离散化为宽度为 0.1 的十个区间。对于区间 b,该方法将 xb 定义为区间中点,并计算 yb,即该区间内所有标注者选择相同标签的样本百分比。由此得到一条跨越方言性谱系的配对序列,包含方言强度和全员一致性百分比。
最后,流程量化方言强度与一致性之间的关联。它在区间中点和相应全员一致性百分比上计算皮尔逊相关系数 rx,y。它还拟合如下形式的线性回归
yb=α+βxb+ϵb,其中 α 是截距,ϵb 是残差,β 是最佳拟合直线的斜率。报告的斜率用作关系方向的效应量,而相关系数概括其在 ALDi 分箱范围内的强度。
实验
实验考察标注者一致性如何随预测方言性在阿拉伯语数据集中变化,使用散点图、直方图和多数标签细分。对于非方言识别任务,更高的方言性通常会降低全员一致性,尤其对于需要理解整句的中性标签或负面标签;而显著线索可以使更明显的正面标签或冒犯性标签保持一致性。对于方言识别任务,当句子明显是标准阿拉伯语或强方言时,一致性最高;在中间范围,或当标准阿拉伯语不可用但低方言性信号仍然模糊时,一致性较低。总体而言,一致性通常反映识别难易程度或标签线索,而不是保证标注准确性。
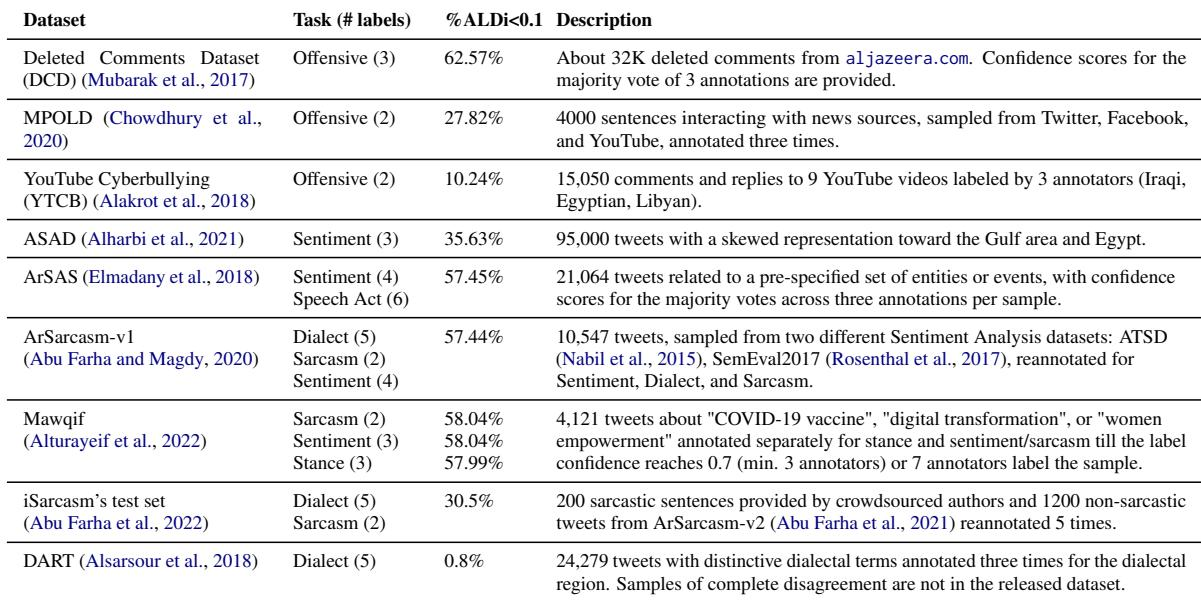
列出的数据集涵盖阿拉伯语冒犯性、情感、反讽、立场、言语行为和方言识别任务,具有不同的样本规模、标签集和标注次数。它们在方言性内容上也存在差异,一些数据集包含大量预期接近现代标准阿拉伯语的样本,而另一些则方言性更强。相关结果表明,对于非方言任务,方言性增加通常会降低全员一致性,而方言识别显示出更复杂的模式。这些数据集涵盖方言识别之外的多种阿拉伯语自然语言处理任务。不同数据集的方言性内容不同,低 ALDi 样本占比也不同。对于非方言任务,随着 ALDi 分数上升,标注者全员一致性通常下降。对于方言识别,一致性在非常低或非常高的 ALDi 水平上往往最强,在中等水平上较弱。
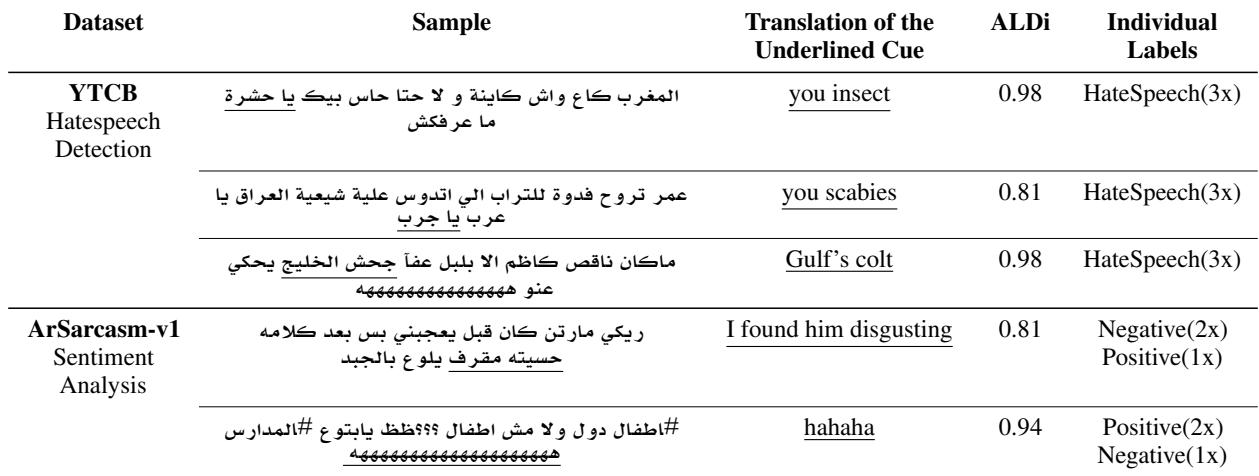
样本显示,显著词或线索可以帮助标注者为高 ALDi 句子分配标签,即使其他部分难以理解。这种基于线索的标签分配在正面或明显标记类别(如仇恨言论)中最为明显,但在情感样本上一致性仍有变化。该模式表明,一致性可能反映捷径线索,而不是完整理解。尽管其他部分可理解性较低,标注者有时仍能从简短词汇线索识别冒犯性或仇恨样本。高 ALDi 并不能保证一致性,因为一些情感样本仍会获得分歧标签。由线索带来的标签一致并不一定意味着标注正确或被完全理解。
实验在覆盖冒犯、情感、反讽、立场、言语行为和方言识别的多个阿拉伯语自然语言处理数据集上评估标注者一致性,这些数据集具有不同水平的方言性内容。对于非方言任务,更高的方言性通常会降低全员一致性;对于方言识别,则呈现出更不均匀的模式,在方言性两端的一致性更强。对高方言性样本的进一步分析表明,可见的词汇线索可以引导标注,尤其对于明显标记的类别,这表明一致性部分反映捷径线索,而非完全理解。