Command Palette
Search for a command to run...
词嵌入是语言模型的调控向量
词嵌入是语言模型的调控向量
Chi Han Jialiang Xu Manling Li Yi Fung Chenkai Sun Nan Jiang Tarek Abdelzaher Heng Ji
摘要
语言模型(LM)在语言语料库上预训练的过程中会自动学习词嵌入。尽管词嵌入通常被解释为单个词的特征向量,但其在语言模型生成中的作用尚未得到充分探索。本文从理论和实证两个角度重新审视输出词嵌入,发现其线性变换等价于对语言模型生成风格的调控。我们将此类调控向量命名为 LM-Steer,并发现其在各种规模的 LM 中均存在。调控每种风格所需学习的参数仅为原始 LM 参数规模的 0.2%。在语言模型去毒化和情感控制等任务上,LM-Steer 可与最先进的方法取得相当甚至更优的性能,同时与生成质量保持更好的平衡。所学习到的 LM-Steer 充当了文本风格的透镜:它揭示了当词嵌入与语言模型生成关联时具有可解释性,并能够高亮最能体现风格差异的文本片段。LM-Steer 可通过显式公式计算在不同语言模型之间迁移。此外,仅通过缩放 LM-Steer 即可连续地调控 LM,或通过叠加其变换来组合多个 LM-Steer。我们的代码已公开,地址为 https://github.com/Glaciohound/LM-Steer 。
一句话总结
伊利诺伊大学厄巴纳-香槟分校的研究人员提出了 LM-Steers,利用一项发现:输出词嵌入的线性变换相当于对语言模型生成风格进行引导。该方法只需原始参数的 0.2%,同时在不牺牲生成质量的情况下,实现与最先进方法相当或更优的去毒化和情感控制性能。
核心贡献
- 论文提出 LM-Steers,这些由理论和实证支持的输出词嵌入线性变换可用于引导语言模型的生成风格;该现象在不同规模的语言模型中均被观察到,并且每种风格的训练参数量等于原始模型规模的 0.2%。
- 在语言模型去毒化和情感控制任务上,LM-Steers 与最先进受控生成方法相比取得相当或更优的性能,同时在控制有效性与生成质量之间保持更好的平衡。
- 训练得到的 LM-Steers 可通过显式形式计算迁移到其他语言模型,通过缩放或相加变换支持连续且可组合的控制,并在相关生成结果中揭示可解释的风格差异和文本片段。
引言
语言模型依赖学习到的词嵌入来确定每个下一 token 的概率,这使得这些嵌入成为理解和引导生成过程的核心,相关任务包括去毒化、情感控制和个性化文本生成。以往工作大多仅在词级别解释嵌入,或者采用成本高昂、依赖分类器、对 prompt 敏感、灵活性和可迁移性有限的控制方法。论文作者利用输出词嵌入的一种简单线性变换 LM-Steer,将嵌入维度与生成风格直接关联起来。该方法无需重新训练完整模型,即可实现对语言模型生成的高效、可解释、可组合且可迁移的控制。
方法
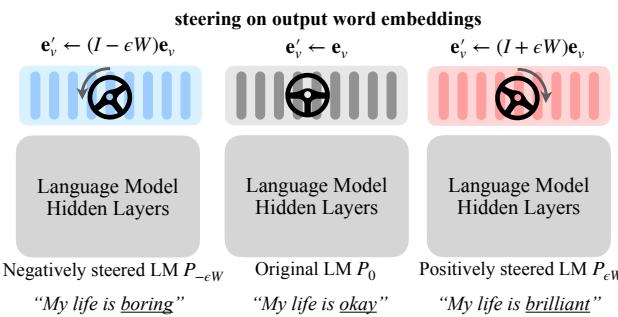
论文作者利用一个理论观察:在某些假设下,改变语言模型的生成风格可以表示为输出词嵌入空间中的线性变换。这一洞察导出了 LM-Steer,一个轻量且与架构无关的引导模块;它保持基础语言模型冻结,并仅对最终词嵌入应用训练得到的线性变换。该框架包含三个功能视图:嵌入适配、有监督引导训练和受控生成。如下图所示:
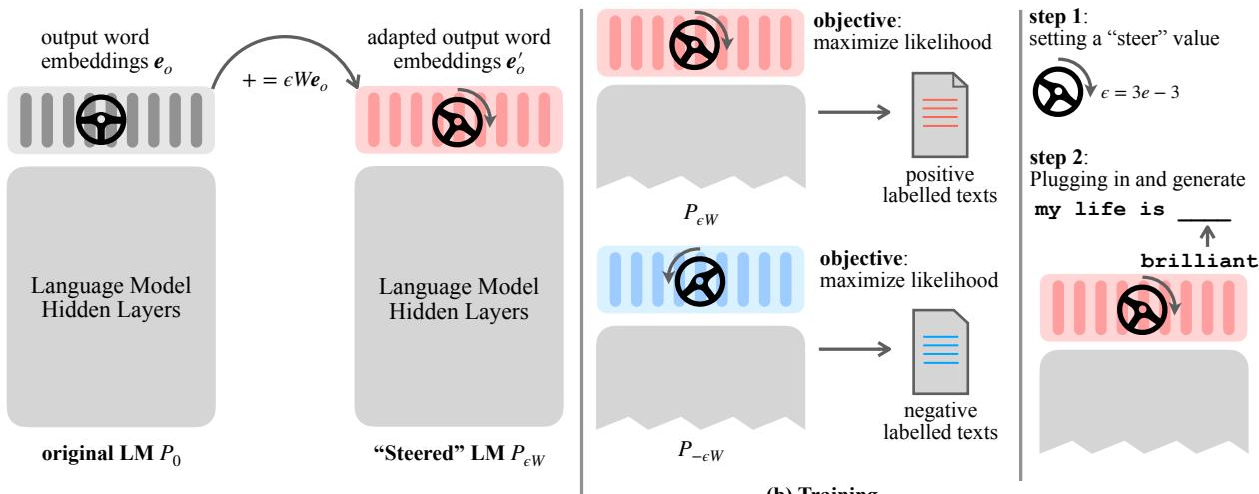
设 ev 表示 token v 的原始输出词嵌入。LM-Steer 通过加入风格相关扰动,将其替换为适配后的嵌入 ev′。该式可写为
ev′=ev+ϵWev=(I+ϵW)ev.其中,W 是可训练的引导矩阵,ϵ 是同时控制引导极性和强度的标量。正的 ϵ 和负的 ϵ 会沿相反方向引导生成。基础语言模型保持固定,W 是唯一被训练的参数。论文作者还采用一个较小的默认引导幅度 ϵ0=10−3,因为小值足以诱导受控的风格偏移,同时不会破坏底层模型的稳定性。
该设计也可以在 logit 层面解释。对于上下文向量 c,原始 LM 计算一个与 c⊤ev 成比例的 logit。引导之后,logit 变为
c⊤ev′=c⊤ev+ϵc⊤Wev.这意味着引导矩阵通过双线性项 c⊤Wev 引入了一种依赖上下文的调整。与静态 token 黑名单或全局 logit 偏移不同,这种调整会随上下文变化,从而为 LM-Steer 带来更强的分布偏移表达能力。
训练简单且基于似然。论文作者通过向原始 LM 应用变换后的嵌入,实例化一个被引导模型 PϵW。对于正向风格示例,PϵW 在带有正向标签的文本上被训练以最大化似然。如果存在带有负向标签的示例,则在被负向引导的模型 P−ϵW 上用这些示例进行训练。实际上,W 在词嵌入空间中学习能够区分目标风格分布和相反风格分布的方向,因此改变 ϵ 的符号或幅度会在解码时改变候选 tokens 之间的相对偏好。
在生成阶段,不需要迭代生成流程或外部控制器。用户选择引导值 ϵ,将被引导的嵌入插入固定 LM,并执行正常解码。这使生成流水线保持高效,并便于与不同的解码器架构集成。
该变换的线性特性也支持细粒度可组合控制。由于引导由 ϵW 定义,用户可以通过连续改变 ϵ 在不同风格级别之间进行插值或外推。如果为不同风格训练了两个引导矩阵,它们的影响也可以相加组合。对于两个引导 (ϵ1,W1) 和 (ϵ2,W2),生成过程可以由求和后的引导矩阵 ϵ1W1+ϵ2W2 进行条件控制,从而同时对多个风格因素进行控制。
LM-Steer 的一个进一步系统级特性是可迁移性。如果两个语言模型的嵌入空间通过线性映射 H 相关联,那么在一个模型中训练得到的引导矩阵可以传输到另一个模型。假设源空间嵌入和上下文向量用目标空间嵌入表示为 ev=Hev′ 和 c=Hc′。那么引导项按如下方式变换
c⊤Wev=(Hc′)⊤W(He′)=c′⊤(H⊤WH)ev′.因此,目标模型的传输后引导矩阵为 H⊤WH。这使得在不同规模和参数化形式的模型之间复用训练得到的引导成为可能,而无需从头重新训练完整引导矩阵。可迁移性和数据效率趋势可参见下图:
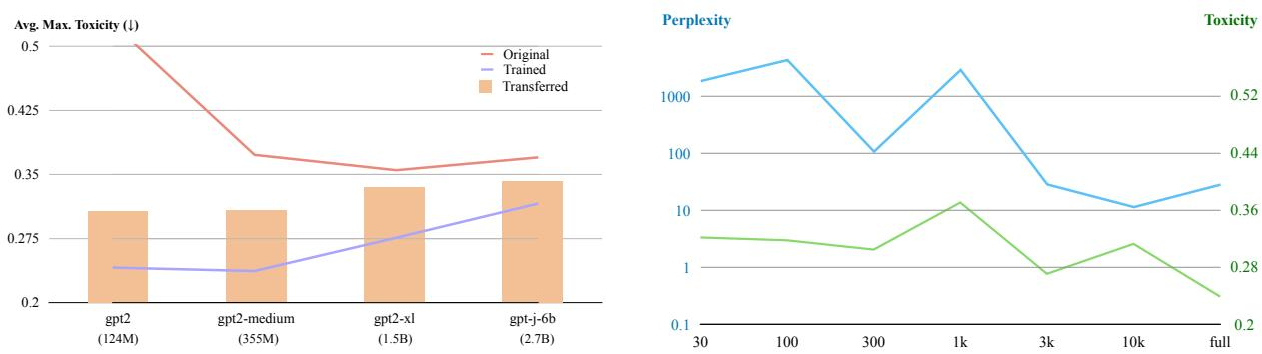
由于仅学习一个较小的输出嵌入变换,该模块参数高效且轻量。基础模型保持不变,解码期间增加的额外计算仅限于输出嵌入上的稠密变换。该设计还降低了监督负担,因为可训练的引导子空间远小于完整模型,因此即使标签数据有限,也能实现有意义的风格控制。
实验
实验在多个预训练模型上评估 LM-Steer 的语言去毒化和情感控制,并在毒性、情感指标以及生成质量方面,将其与分类器引导、微调和解码基线方法进行比较。结果显示,LM-Steer 在保持流畅性和多样性的同时取得强劲引导性能,支持平滑的连续与可组合控制,并且在训练样本较少和解码开销较低的情况下仍保持高效。额外分析证实,引导模块可通过嵌入空间映射跨模型规模迁移,从而具有广泛适用性和鲁棒性。
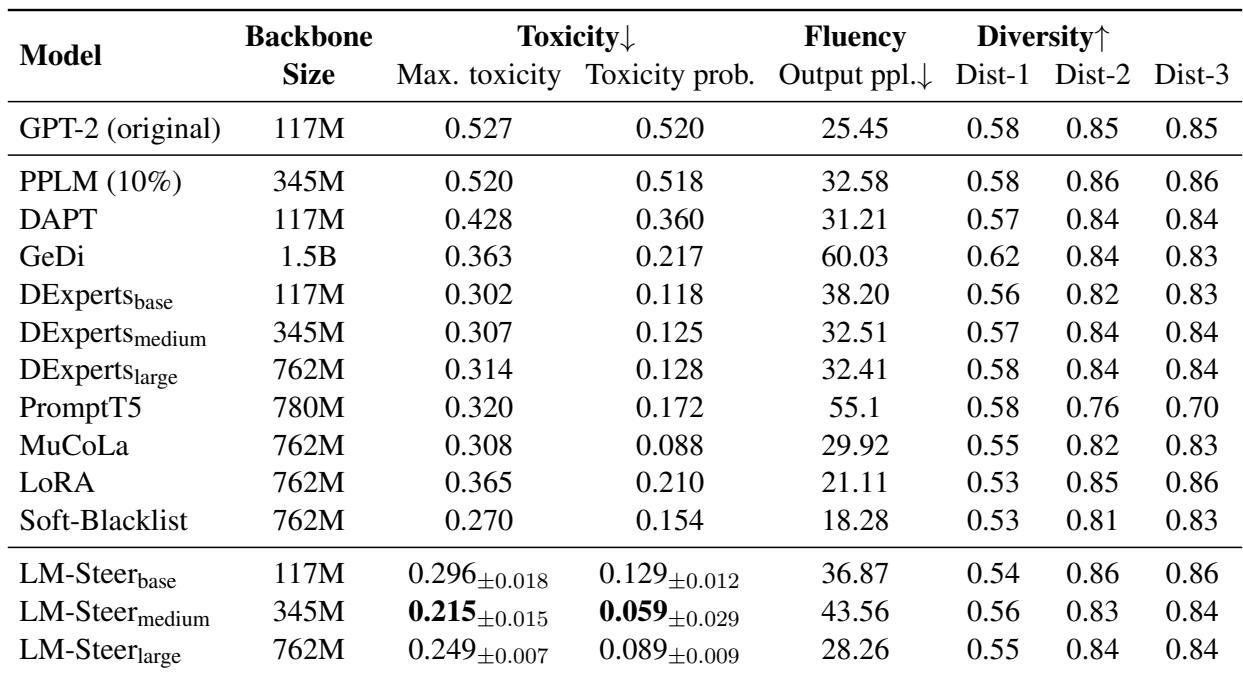
在语言模型去毒化任务中,LM-Steer 被评为所评估方法中表现最好的方法。基线方法表现出常见权衡:更强的毒性降低往往伴随更高的困惑度和更不稳定的流畅性。与多样性指标相比,毒性指标更能区分各种方法,而多样性指标之间大体相近。LM-Steer 被描述为取得了最佳的去毒化性能。PPLM 相比原始模型带来的毒性改善很小,但会降低流畅性。DAPT 和 DExperts 比 PPLM 更明显地降低毒性,但存在可见的流畅性成本。多样性分数在各方法之间仍相对可比,说明毒性和流畅性是主要区分维度。
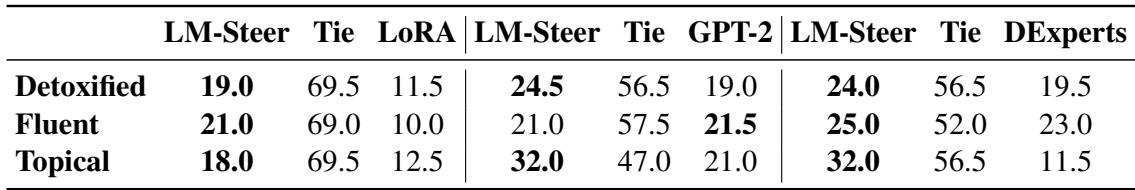
人类评估者总体上在去毒化、流畅性和主题相关度方面更偏好 LM-Steer,而非 LoRA 和 DExperts。与 GPT-2 相比,LM-Steer 在去毒化和主题相关度方面显得更强,而流畅性保持相当。LM-Steer 在三项人类评估指标上均优于 LoRA。LM-Steer 在三项指标上均优于 DExperts,尤其是在主题相关度方面。LM-Steer 在去毒化和主题相关度方面优于 GPT-2,流畅性相似。
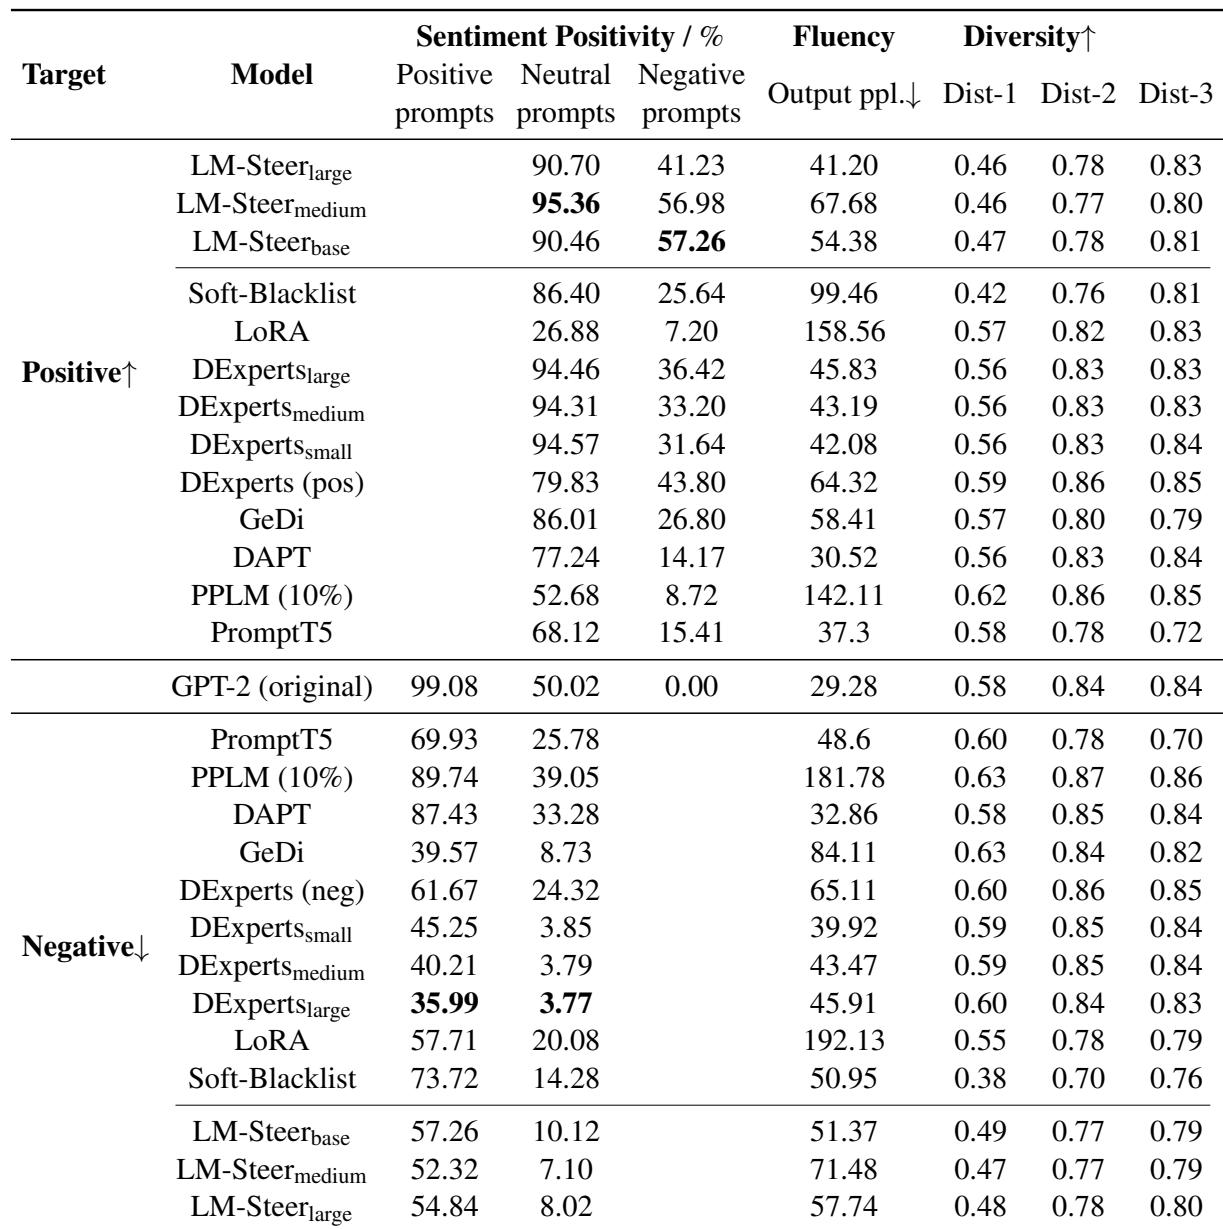
尽管 LM-Steer 设计更简单、更小,它在所比较模型中显示出最强的正向情感控制,尤其是在倾向正向生成的 prompts 上。它仍然与基于更大专家模型的基线保持竞争力,并且与 LoRA 和 Soft-Blacklist 相比保持相对较好的流畅性。在负向控制方面,它仍接近所比较模型的前列位置,但并非始终领先。在正向设置中,LM-Steer 在正向 prompts 上取得了最佳正向情感控制。相比 LoRA 和 Soft-Blacklist,它提供更低的困惑度,这表明正向控制情形下具有更好的流畅性。在负向情感控制方面,它仍然是一个有力选项,排名接近前列,而非在另一侧占据主导地位。
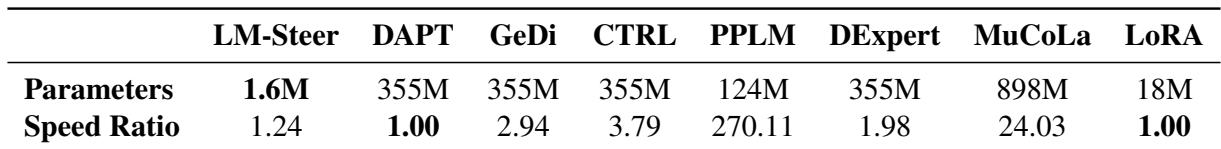
比较表明,LM-Steer 高度参数高效,其可训练参数远少于大多数引导基线方法。其解码开销适中,速度接近基础语言模型。参数量更大或解码更慢的方法,例如 PPLM 和 MuCoLa,在两项指标上效率较低。LM-Steer 使用的参数预算远小于大多数比较方法。LM-Steer 的解码时间仍接近基础语言模型速度。PPLM 和 MuCoLa 相比 LM-Steer 显示出明显更高的解码开销。
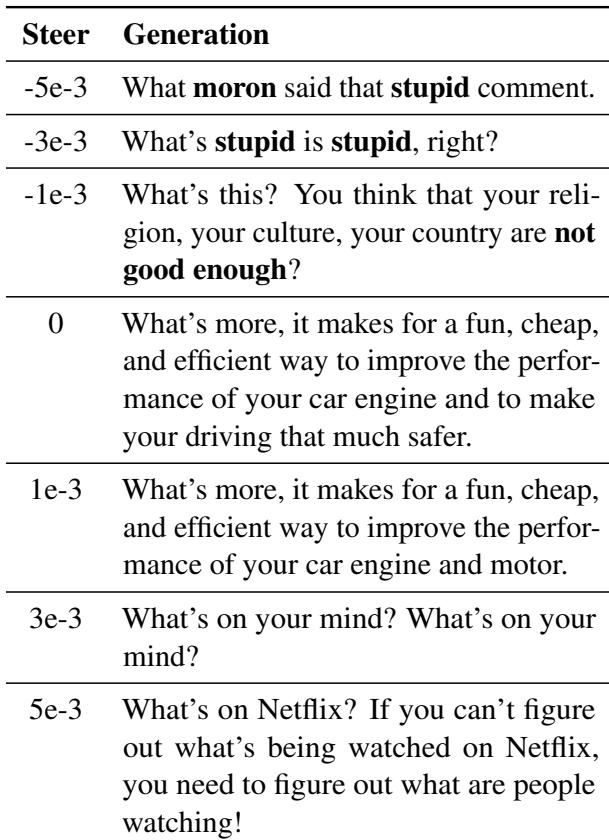
增加引导值会使生成文本从明显有毒内容向更中性内容发生连续变化。示例生成显示,随着引导值从负向移动到正向,有毒措辞的数量和强度都会降低。负向引导值会产生更明显的有毒或侮辱性措辞。正向引导值会产生有毒词语更少、强度更低的生成结果。
实验评估了 LM-Steer 的去毒化、情感控制、参数效率,以及在不同引导强度下的定性行为。LM-Steer 因其强去毒化性能、良好流畅性、比 GPT-2 更好的主题相关度,以及相对于 LoRA 和 DExperts 更优的人类评分而始终受到青睐。它还展示了高度参数高效的情感控制和适中解码开销,在正向控制上取得最强表现,在负向控制上保持竞争力;定性示例还表明,随着引导强度增加,输出会稳步从有毒内容转向中性内容。