Command Palette
Search for a command to run...
来场真实对话:面向面对面交流的语音对话模型
来场真实对话:面向面对面交流的语音对话模型
Se Jin Park Chae Won Kim Hyeongseop Rha Minsu Kim Joanna Hong Jeong Hun Yeo Yong Man Ro
摘要
本文提出了一种新颖的面对面语音对话模型。该模型处理来自用户输入的音视频语音,并生成音视频语音作为回复,标志着构建不依赖中间文本的虚拟形象聊天机器人系统的第一步。为此,我们首次提出了 MultiDialog,这是首个大规模多模态(即音频和视觉)语音对话语料库,包含 340 小时、约 9,000 段对话,基于开放域对话数据集 TopicalChat 录制。MultiDialog 包含对话双方按照给定剧本表演时的平行音视频录制,并附有情感标注,我们期望该数据集能够开启多模态合成的研究机遇。我们的面对面语音对话模型融合了文本预训练的大语言模型,并通过引入语音-文本联合预训练将其适配到音视频语音对话领域。通过大量实验,我们验证了该模型在促进面对面交流方面的有效性。演示和数据分别可在 https://multidialog.github.io 和 https://huggingface.co/datasets/IVLLab/MultiDialog 获取。
一句话总结
KAIST 提出了 Face-to-Face 语音对话模型以及 MultiDialog,这是首个包含 340 小时的大型多模态音视频对话语料库。该模型通过 speech-text 联合预训练适配预训练 LLM,无需中间文本即可直接处理和生成音视频语音,从而推动端到端数字人聊天机器人系统的发展。
核心贡献
- MultiDialog 被引入为一个大规模多模态语音对话语料库,包含 340 小时和约 9,000 段基于 TopicalChat 的音视频对话,并包括情绪标注。该数据集支持音视频语音对话合成研究。
- 一种直接的 Face-to-Face 语音对话模型可处理用户音视频语音并生成音视频语音回复,生成过程中不依赖中间文本。
- 实验表明,基于文本预训练大型语言模型构建的 speech-text 联合预训练比直接初始化保留了更多原始模型知识,并支持有效的面对面对话。
引言
语音对话系统对语音助手和客户服务很重要,但自然人类对话也依赖面部表情和手势等视觉线索,这些线索可以提升理解和参与度。以往的数据集和模型大多只覆盖文本或纯音频对话,音视频语音对话语料库规模有限,而且现有多模态 LLM 通常将视觉用于辅助任务,而不是生成同步的说话人脸语音。作者引入 MultiDialog,这是一个 340 小时、由约 9,000 段真实对话衍生对话组成的音视频语料库,并利用它训练一个直接的 Face-to-Face 语音对话模型,该模型处理音视频语音输入并生成音视频语音输出。量化后的音视频语音 tokens 来自自监督特征,被用作伪文本单元;大型语言模型与语音和文本联合预训练后,与直接初始化相比,更好地保留了原始 LLM 知识。
数据集
-
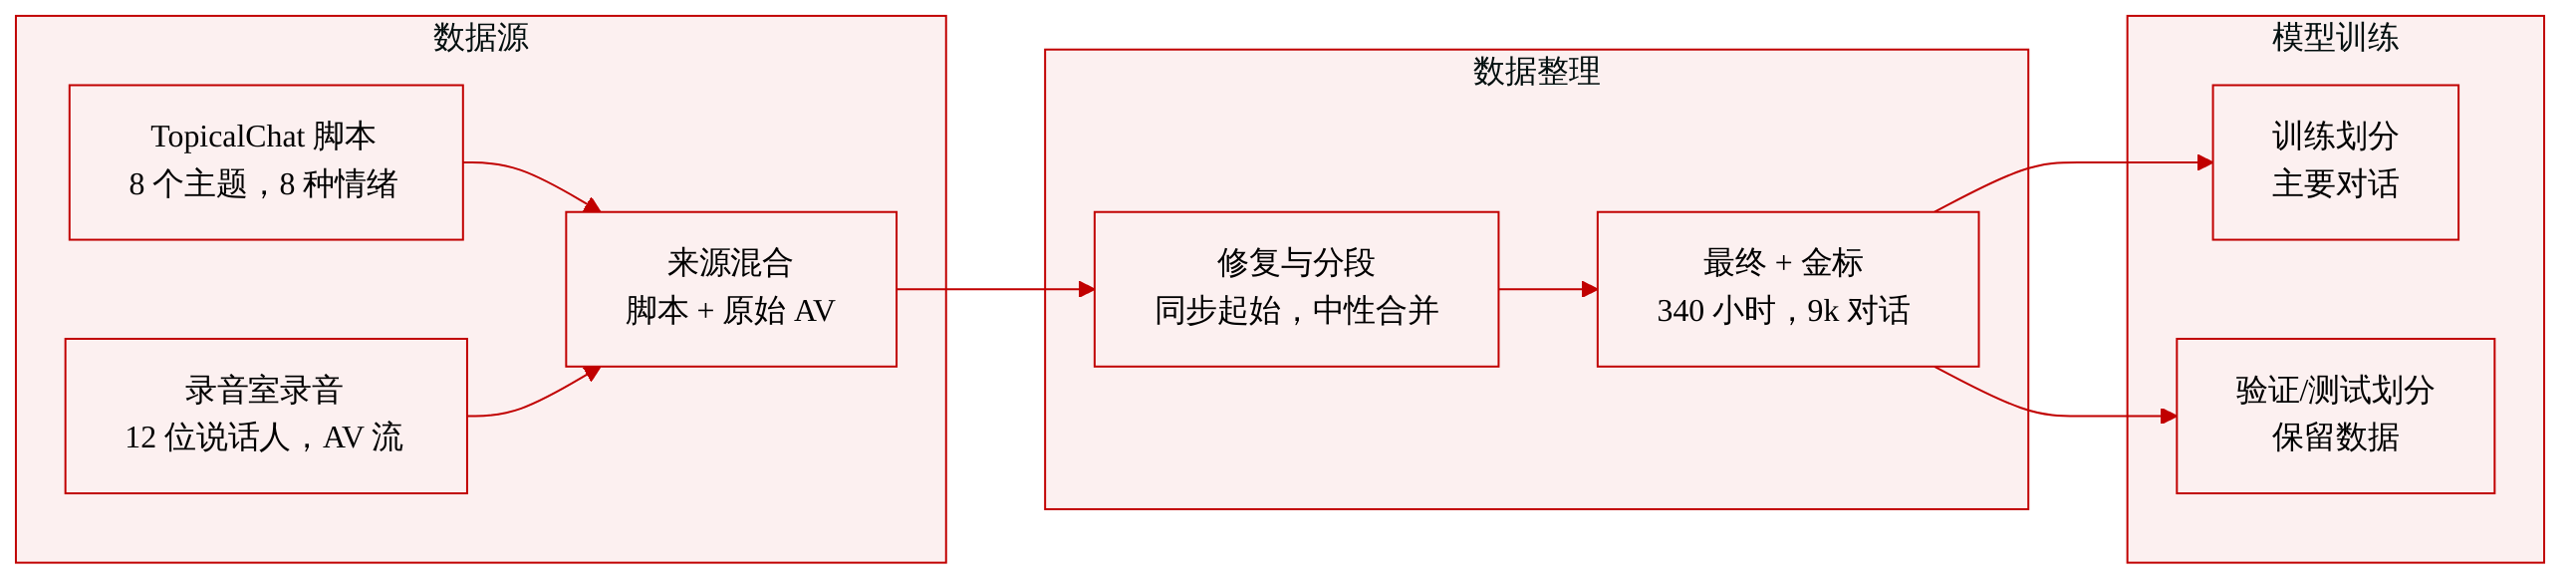
数据集组成与来源:
- 作者基于来自 TopicalChat 的对话脚本构建 MultiDialog,TopicalChat 是一个开放域、知识引导的对话数据集,收集自真实人类之间对话。
- 源数据覆盖八个广泛主题:时尚、政治、图书、体育、综合娱乐、音乐、科学与技术、电影。
- 源对话数据包含八种情绪标注:厌恶、愤怒、恐惧、快乐、悲伤、惊讶、Neutral(中性),以及 curious to dive deeper(好奇地深入探究)。
-
录制设置与参与者细节:
- 作者录制了 12 名英语流利者,包括 6 名男性和 6 名女性,年龄为 20 到 30 岁,来自六个国家。
- 录音在专业录音棚内完成,带绿幕且背景噪声很小。
- 两位对话者并排而坐,并使用独立相机和麦克风分别采集。
- 相机取景根据每位参与者的身高调整,记录肩部以上的上半身,提供聚焦于面部和上半身行为的裁剪画面。
-
音视频数据模式与轮次元数据:
- 音频以单声道 WAV 格式录制,采样率为 48 kHz。
- 视频以全高清录制,帧率为 30 fps。
- 参与者按下按钮进入下一句话,从而记录每轮话语的起止时间。
- 轮次级时间戳在后期处理中用于将录音分割为对话和话语。
-
情绪与说话人构建细节:
- 演员按照指定每句话所需情绪的脚本表演。
- 作者基于 Facial Action Coding System 提供视觉和声音指导,并为每种情绪提供示例图片。
- 参与者还被要求在倾听时自然反应,从而在对话中加入非说话者行为。
- 作者发现 Neutral 与 Curious to dive deeper 之间视觉差异很小,因此将原始 Neutral 和 Curious to dive deeper 情绪标签合并为单一 Neutral 标签。
-
过滤、对齐与子集选择:
- 标注者审查录音,通过调整轮次开始时间修正音视频不同步问题。
- 缺少音频流或视频流的录音被过滤掉。
- 作者使用录制的轮次边界将数据分割为结构化对话。
- 最终 MultiDialog 数据集包含约 340 小时音视频对话,涵盖约 9,000 段对话,涉及 6 对对话参与者。
- 作者还发布了经过严格标注评估筛选出的金标情绪对话子集。
方法
作者构建了一个音视频语音对话系统,接收用户的人脸视频和音频流作为输入,并生成带有同步音频的说话人脸视频作为回复。整体流程将该任务分解为三个相互耦合的模块:音视频语音 tokenizer、多模态语音对话语言模型,以及音视频回复生成器。tokenizer 将语音转换为紧凑的离散符号,语言模型将这些符号视为伪文本进行对话建模,生成器则把预测符号重新投影为可听语音和视觉面部动作。如框架图所示:
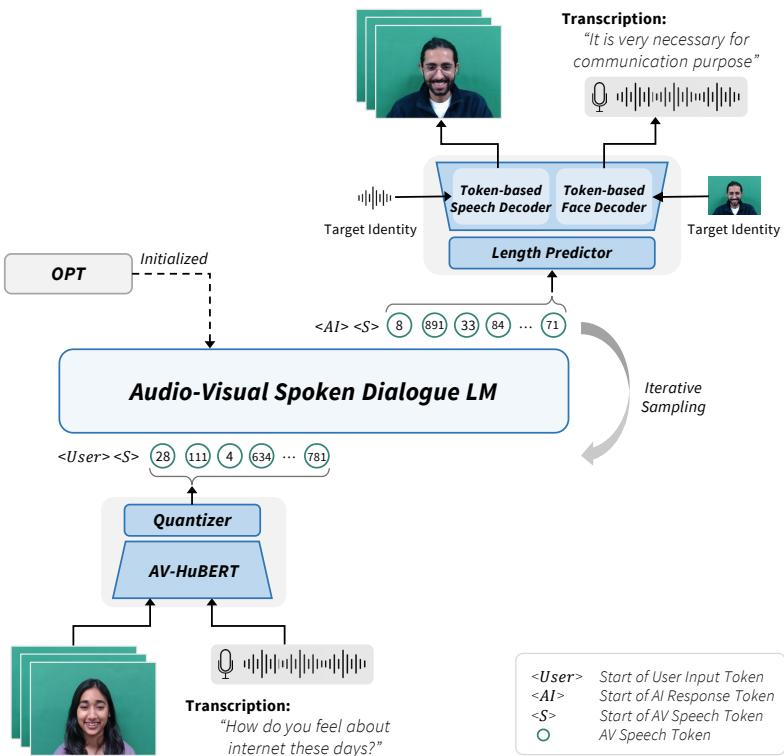
第一个模块是音视频语音编码器,它将用户原始人脸视频和语音信号转换为离散 AV speech tokens。作者利用 AV-HuBERT,这是一个联合观察唇部运动和音频特征的自监督音视频语音模型。实际中,编码器聚焦于嘴部区域,同时使用同步音轨,提取音视频表示,并将其量化为离散聚类序列。这些 AV speech tokens 被设计为同时保留语言内容和语音学内容,而视觉嘴部运动提供互补线索,从而提升噪声条件下的鲁棒性。由于得到的 token 序列可被视为语音的符号化表示,语言模型能够像处理 text tokens 一样处理它。
核心推理组件是音视频语音对话语言模型。它从预训练大型语言模型 OPT-1.3B 初始化,并将其词汇表扩展为同时包含 AV speech tokens 和原始 text tokens。统一词汇表允许模型学习覆盖 text tokens 和 AV speech tokens 的单一下一个 token 分布。如果完整 token 序列长度为 N,通用语言建模目标为:
L=−i=1∑Nlogp(ti∣t1,…,ti−1)其中 ti 表示文本或 AV speech 中的第 i 个 token。目标是让原始纯文本 LLM 学习理解 AV speech tokens,并生成相关的 AV speech 回复。
为了在保留语言知识的同时使基于文本的 LLM 适应 AV speech tokens,作者引入了 speech-text 联合预训练方案。训练对话被组织为 User 和 AI 轮次组成的序列,每个 utterance 以两种同步形式表示:text-token 序列和 AV speech-token 序列。模态标记用于指示 AV speech 流或 text 流的开始。随后,说话人标记区分 User 和 AI。这些带标记序列定义了 token 理解和对话生成的训练目标。如训练数据图所示:
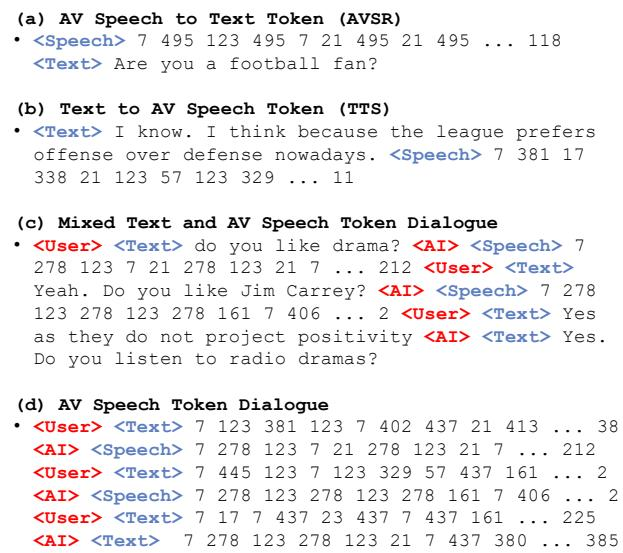
第一个预训练阶段通过配对的轮次示例,教会 LLM 解释和生成 AV speech tokens。对于每个对话轮次,模型会看到由模态前缀引入的一个 text 流和一个 AV speech 流。两个互补的 next-token 目标被构建。一个 AV speech-text 目标定义为:
LAVSR=i=1∑N−logp(TAVi∣TAV<i,TText)并且配对的 text-AV 目标定义为:
LTTS=i=1∑N−logp(TTexti∣TText<i,TAV)其中 TAV 表示 AV speech-token 序列,TText 表示 text-token 序列。在该阶段,作者冻结大部分预训练 LLM,仅训练嵌入层和投影层。该设计允许新的 AV speech tokens 进入模型表示空间,同时保留编码广泛语言和对话知识的原始 LLM 参数。
第二个预训练阶段从配对话语建模转向完整对话建模。训练序列包含交替的 User 和 AI 轮次,并带有额外的说话人前缀 tokens,例如 <User> 和 <AI>,随后是模态前缀 tokens,例如 <Speech> 和 <Text>。这会创建一个对话上下文,使模型必须根据先前的用户和 AI 轮次预测 AI 回复。如果对话包含 K 轮,且第 k 个 AI 回复包含 Nk 个 tokens,则对话语言建模损失为:
其中 Tkai,n 是第 k 轮中的第 n 个 AI token,Tkai,<n 表示同一回复中较早的 AI tokens,T<k 包含所有先前的对话上下文。在该阶段,模型在基于 text 和基于 AV speech-tokens 的对话的均衡混合数据上训练。这种渐进式转变帮助模型学习使用 AV speech tokens,同时维持继承自 text LLM 的对话质量。混合预训练后,系统进一步使用 AV speech tokens 对话序列适配,从而仅使用离散音视频语音表示即可实现实时面对面交互。
最后一个模块将生成的 AV speech tokens 投影回音频和视觉模态。由于语言模型在紧凑且去除重复的 AV speech token 序列上运行,生成器首先使用长度预测器恢复准确语音合成所需的时间长度。恢复后的 token 序列随后传给基于 token 的语音 decoder,将 AV speech tokens 转换为可听波形。并行地,基于 token 的人脸 decoder 从相同 AV speech tokens 生成面部动作和外观。这些 decoder 改编自预训练音频和说话人脸生成器,但训练它们消费 AV speech tokens 而不是原始音频。
为控制说话人身份和视觉一致性,生成器引入目标身份信息。从目标身份音频样本提取的说话人 embedding 对合成语音进行条件调制,而目标身份的人脸和姿态先验引导人脸生成器。在人脸 decoder 路径中,可以通过 adapter 或 reprogramming bridge 将 AV speech tokens 映射为与预训练说话人脸生成器兼容的特征表示,使系统能够复用强大的视觉生成能力,同时不需要修改整个生成器。随后,最终的人脸增强器可对生成的人脸帧进行上采样,以提高视觉质量。结果是完整的闭环音视频语音对话流程:用户人脸视频被 token 化,对话 LM 生成 token 化的 AI 回复,并将回复渲染为音频和说话人脸视频。
实验
实验从语义内容和生成质量两方面评估生成的音视频对话回复,其中使用转录文本评估对话连贯性,并评估视觉质量、音视频同步性和说话人相似度;实验还将结果与纯音频语音对话系统和级联 pipeline 进行比较。主模型能够生成上下文连贯、多样化的回复,且无需生成中间文本;预训练研究表明,从文本语言模型初始化并逐步将其与音视频语音 tokens 对齐可提升语义性能。结果还表明,所提出的语音和人脸生成 pipeline 能很好地保留说话人身份,并将音频与视频有效对齐;同时加入视觉输入能提升系统对声学噪声的鲁棒性。
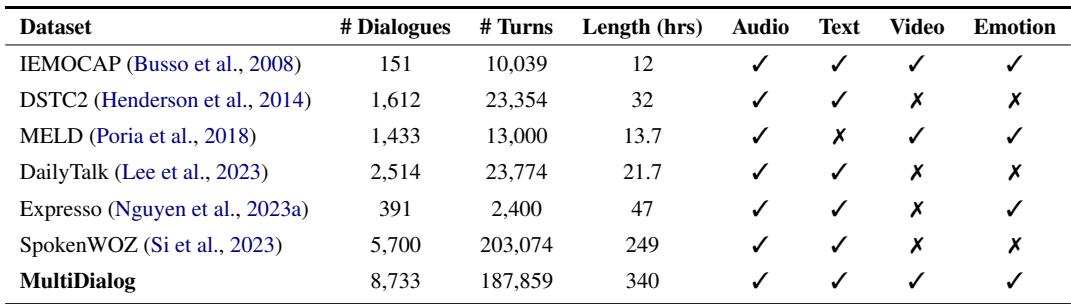
MultiDialog 被与以往的语音和多模态对话数据集按规模和可用信号类型进行比较。它在所比较数据集中提供了最大规模的对话数量、轮次数量和总小时数,同时包含音频、文本、视频和情绪标注。这一组合支持大规模三模态对话系统以及富表现力多模态对话建模的研究。MultiDialog 在对话数量、轮次数量和总时长方面都大于其他列出的数据集。它支持音频、文本、视频和情绪标签,因此比仅包含一两种模态或没有情绪标注的数据集更广泛。
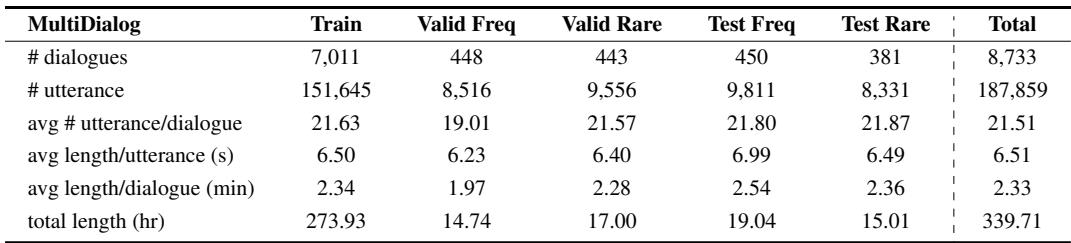
MultiDialog 数据集包含约 340 小时音视频语音对话,组织为一个较大的训练部分,以及较小的验证和测试部分,用于常见和少见样本评估。各划分中的对话具有大致相似的轮次数量和时长,平均每段对话约 21 句话,时长为几分钟。这些统计信息支持在常见和少见情况下评估多模态对话模型,同时保持一致的对话长度分布。训练划分占多数对话、话语和总视频时长。验证和测试划分的对话数量相近,可在常见和少见条件下进行评估。各划分的平均对话和话语时长保持相似,表明后期处理分割一致。
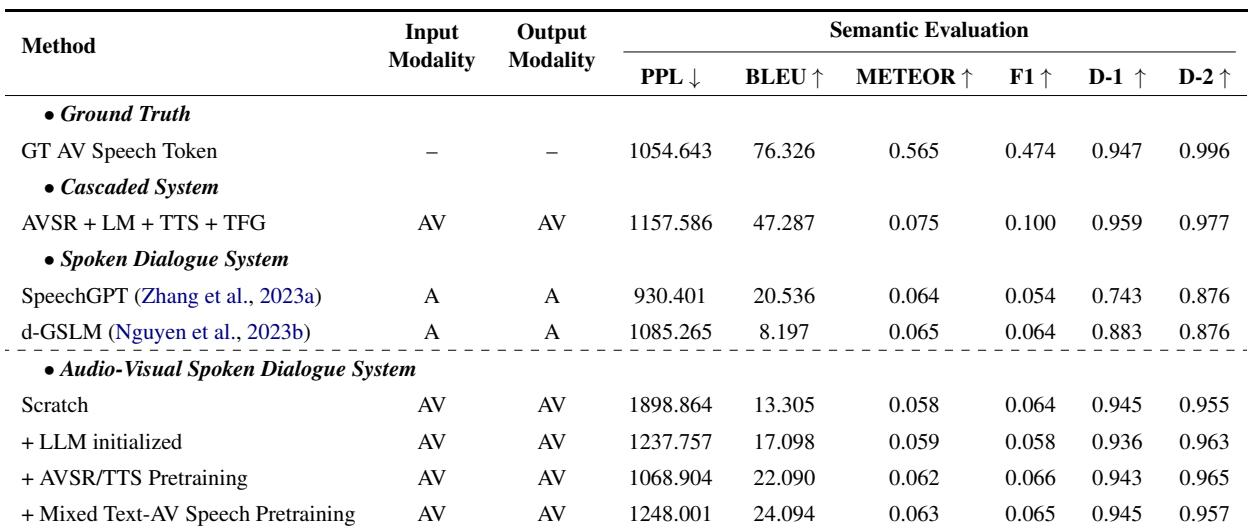
在所比较的语音对话系统中,该方法在语义连贯性和多样性方面表现最佳,尤其是在 BLEU、unigram 和 bigram 多样性上。它也因接受音视频输入并生成音视频输出且不使用中间文本而具有区别。预训练分析表明,文本语言模型初始化和音视频语音 tokens 的逐步适配能提升语义质量,尽管困惑度略差,但 text 和音视频 tokens 混合预训练带来了整体提升。相对于其他语音对话系统,该方法在 BLEU 和多样性指标上排名第一。它是唯一支持音频和视觉输入输出且无需中间文本的方法。逐步进行 text 和音视频 tokens 预训练可提升语义质量,但会略微增加困惑度。
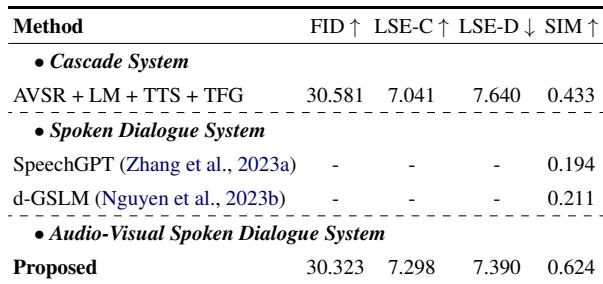
所提出的音视频语音对话系统在所比较方法中表现出最强的说话人语音相似度,优于级联系统和纯音频对话系统。其视觉质量接近使用同一说话人脸生成器的级联系统,同时音视频同步更强,更好的唇形同步指标也支持这一点。这些结果表明,使用离散音视频 tokens 有助于保留说话人信息,并使语音与面部动作对齐比原始音频级联生成更有效。该方法在评估系统中取得最高说话人相似度分数。其人脸生成质量与使用同一视觉生成器的级联基线相当。它比级联系统产生更好的音视频同步,这与其更高的置信度和更低错误率的唇形同步分数一致。
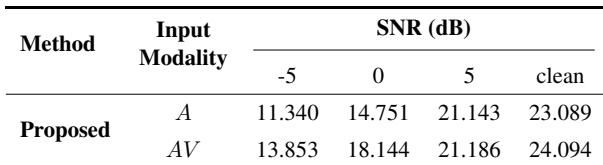
比较表明,在音频输入中加入视觉信息能提升以 BLEU 衡量的对话回复生成效果。音视频设置在噪声和干净条件下均优于纯音频输入,这支持语音被声学噪声破坏时具有更强鲁棒性。这说明视觉线索有助于恢复因音频质量下降而丢失的信息。音视频输入在所有测试 SNR 水平下都取得比纯音频输入更高的 BLEU 分数。视觉输入的优势在噪声条件下比干净条件下更明显。视觉信息有助于补偿因声学破坏而损失的语音内容。
实验将 MultiDialog 数据集与现有语音和多模态对话数据集进行比较,并评估所提出的音视频对话系统。数据集分析表明,MultiDialog 在规模、模态和标注方面具有更广覆盖,同时在训练、验证和测试划分之间保持一致的对话分布。系统评估表明,与以往语音对话系统相比,直接音视频建模提升了语义连贯性和回复多样性;与级联生成相比,它更好地保留了说话人身份和唇形同步质量;并利用视觉输入提升噪声条件下的鲁棒性。