Command Palette
Search for a command to run...
NounAtlas:填补名词语义角色标注的空白
NounAtlas:填补名词语义角色标注的空白
Roberto Navigli Dennis Rotondi Marco Lo Pinto Simone Ciciliano Pasquale Silvestri Alessandro Scirè
摘要
尽管语义角色标注(SRL)领域已取得显著进展,但该领域的大量工作集中于动词谓词,名词谓词的 SRL 研究相对滞后。然而,在许多语境中,名词谓词往往与动词谓词同样具有信息量,因此需要得到妥善对待。本文旨在填补这一空白,使名词 SRL 成为该领域的一等公民。我们提出了一种新颖方法,用以构建首个大规模、高质量的名词谓词清单,并将其组织为语义连贯的框架。尽管 NounAtlas——我们的名词框架清单——是自动生成的,但随后经过了完整的验证。我们进而提出了一种为名词 SRL 生成银标训练数据的技术,并证明最先进的 SRL 模型能够取得良好的性能。值得注意的是,得益于我们的设计选择——使我们所构建的名词谓词清单能够与其对应的动词谓词清单(即 VerbAtlas)无缝集成——我们能够将动词数据与名词数据混合使用,并在两种谓词上执行鲁棒的 SRL。
一句话总结
罗马萨皮恩扎大学、斯图加特大学和博尔扎诺自由大学提出了 NounAtlas,这是首个大规模、完全验证的名词谓词清单,这些名词谓词被组织成语义连贯的框架,并与 VerbAtlas 无缝集成,从而通过 silver 训练数据生成,在动词谓词和名词谓词上实现稳健的语义角色标注。
核心贡献
- NounAtlas 是一个经过验证、自动创建的名词谓词清单,包含 10,000 多个名词谓词,通过把 WordNet 名词连接到 VerbAtlas 框架,将其组织成语义连贯的框架。
- 一个 silver 数据生成流程使用 NounAtlas 和大型语言模型来传播谓词标签和语义角色标签,创建一个大规模、宽覆盖的名词语义角色标注数据集。
- 在动词数据和名词数据上训练的统一 SRL 模型在两类谓词上都达到最优性能,表明名词与动词框架资源的整合能够支持跨谓词类别的稳健 SRL。
引言
语义角色标注通过识别谓词及其论元来支持事件理解,回答谁对谁做了什么、何时发生等问题。这对问答、机器翻译、文本推理和摘要等应用很重要。然而,大多数现有资源和模型高度关注动词,但许多重要谓词是名词,尤其是在标题和短文本中。现有名词资源覆盖有限、角色清单不一致,或与动词谓词框架对齐较差,使得广泛且统一的 SRL 难以实现。作者通过提出 NounAtlas 填补这一空白,NounAtlas 是与 VerbAtlas 框架相连的大规模名词谓词清单,并创建了一个用于名词 SRL 的大规模标注数据集。他们还评估了若干现代 SRL 基线,并表明在名词和动词数据上训练的统一方法能够在两类设定中达到最优性能。
数据集
-
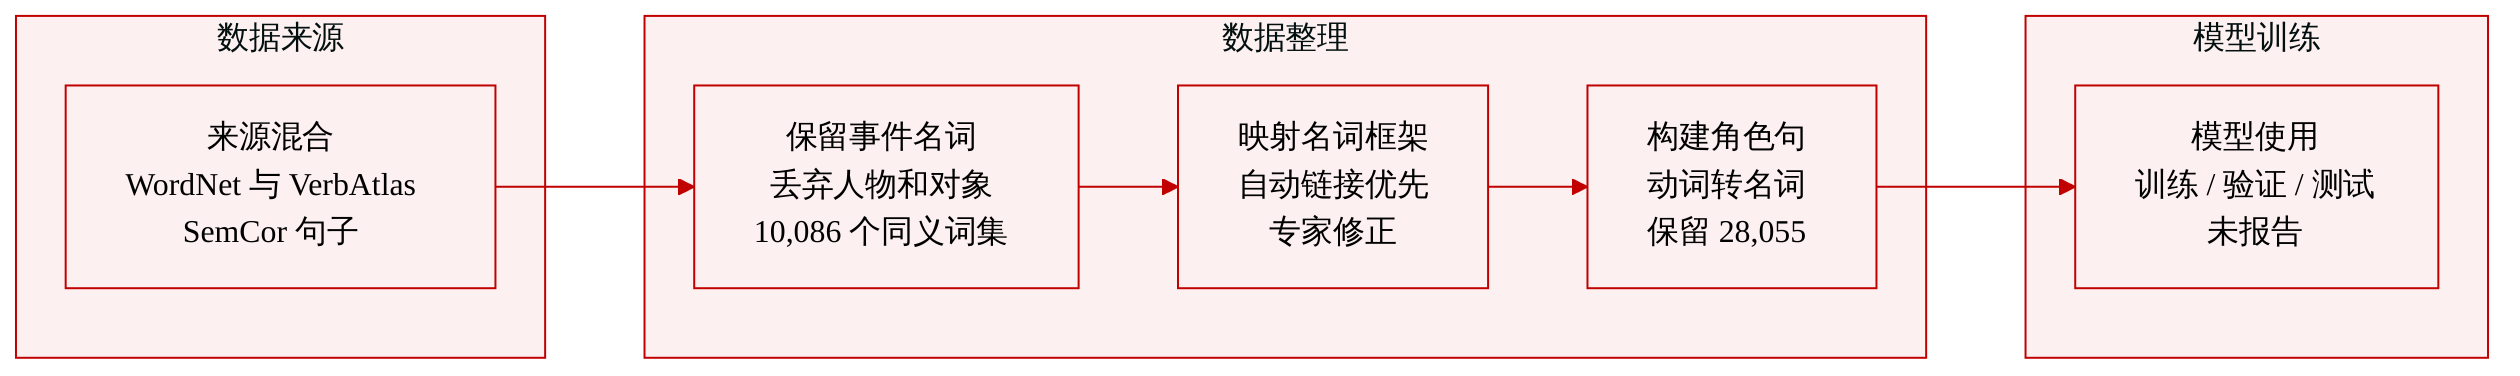
作者构建两个相关文本数据集:
- NounAtlas,一个大规模名词谓词清单。
- 一个由 SemCor 句子和 NounAtlas 框架构建的名词语义角色标注数据集。
-
来源:
- VerbAtlas 是起始框架资源,由被分组为 400 多个语义框架的 WordNet 动词 synset 构建。
- NounAtlas 由 WordNet 3.0 的名词 synset 构建。
- SRL 语料从 SemCor 收集,SemCor 是最大的人工标注 WordNet sense 语料库。
-
NounAtlas 组成与过滤:
- 名词谓词被定义为描述事件、动作或状态并且允许识别语义角色的 WordNet 名词 synset。
- 排除非事件名词 synset,例如指称人或对象的 synset。
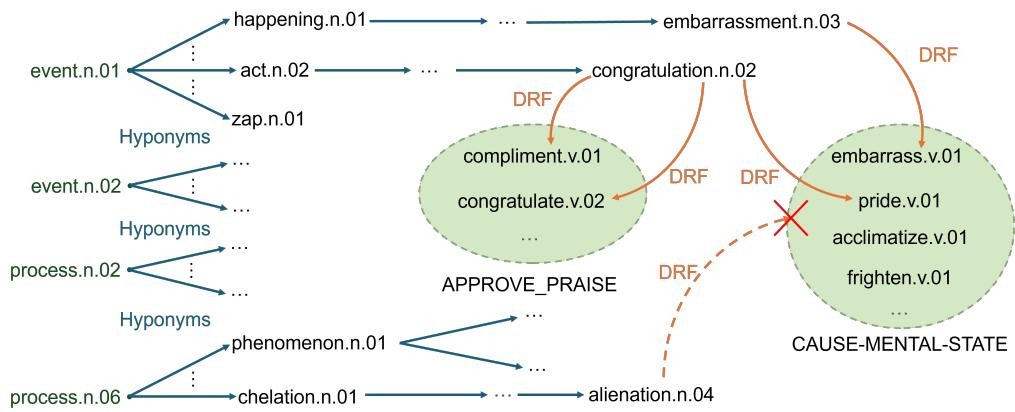
- 作者按照 WordNet 名词 synset 的下位词数量进行排序,并选择最泛化的事件 synset。
- 在移除被包含的 synset 后,保留四个种子 synset:EVENT.N.01、EVENT.N.02、PROCESS.N.02 和 PROCESS.N.06。
- 然后包含这些种子的所有后代名词 synset。
- 最终的 NounAtlas 清单包含 10,086 个表征事件的名词 synset。
-
将名词 synset 映射到 VerbAtlas 框架:
- 映射利用 WordNet 中名词 synset 与动词 synset 之间的派生相关形式链接启动。
- 如果一个名词 synset 只有一个动词对应项,或在同一个 VerbAtlas 框架内有多个动词对应项,则自动分配为 Unambiguous 链接。
- 如果链接到的动词 synset 属于不同框架,标注者会手动选择最合适的框架。
- 如果没有动词链接,专家标注者会使用相似度排序将该 synset 映射到框架。
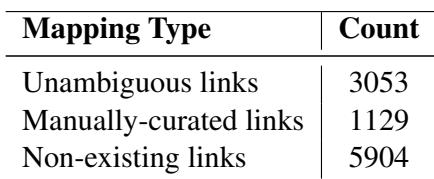
- 基于 DRF 的 Unambiguous 链接覆盖约 31% 的表征事件的名词 synset。
- 对于人工整理链接,标注者一致性为中等,Cohen’s kappa 为 0.57。
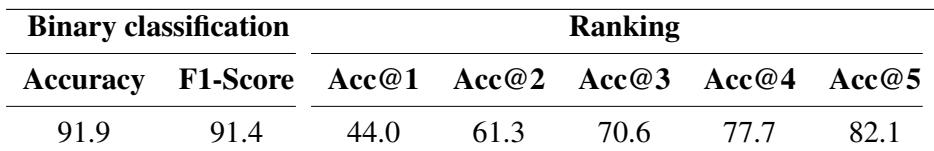
- 在 5,904 个没有 DRF 链接的 synset 中,5,876 个被人工链接,88.2% 从前 5 个框架中选择,49.3% 选择排名第一的框架。
- NounAtlas 复用 VerbAtlas 框架标签,因此名词谓词和动词谓词共享一个统一框架模式。
-
SRL 数据集构建:
- 作者选择 SemCor 中至少包含一个动词的句子,该动词具有通往名词 synset 的 DRF 链接,以及通往 VerbAtlas 框架的 Unambiguous 链接。
- 初始过滤池包含 36,295 个动词谓词出现实例。
- 通过提示大型语言模型,将每个句子改写为用相关名词 synset 中对应的去动词名词替换动词的版本。
- 输出必须遵循固定格式,标记所选名词谓词。
- 自动验证生成句子的名词词性、正确词形和候选成员资格。
- 29,221 个生成名词句子通过验证。
-
角色标注与最终规模:
- 角色标签从原始动词谓词标注中迁移。
- 作者使用 span embedding 对齐原始动词句子和名词化句子中的角色。
- 最终 SRL 数据集包含 28,055 个句子。
- 如果任何动词角色未能成功传播到名词句子,则丢弃该句子。
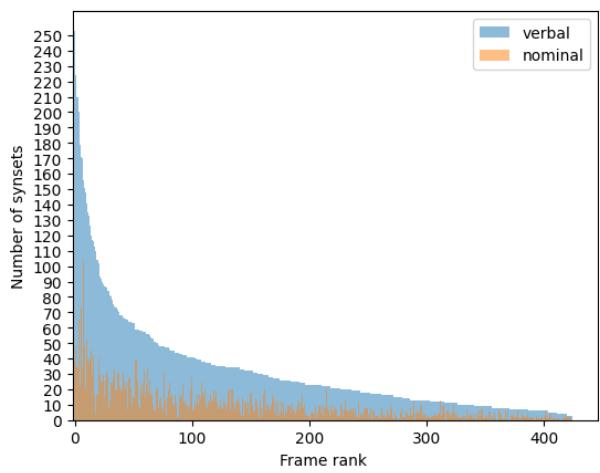
- 各框架中的句子数量严重不均,有些框架句子很多,有些极少;中位排名的框架包含 32 个句子。
-
元数据与模式:
- 每个 SRL 样本包含一个名词谓词、分配的 NounAtlas 框架标签、论元 span 和语义角色标签。
- 角色遵循 VerbAtlas 风格的语义角色,例如 Agent、Theme 和 Topic。
- 框架标签在 VerbAtlas 和 NounAtlas 之间共享,形成统一的名词和动词框架清单。
-
数据集质量评估:
- 作者人工检查 500 个句子。
- 92.11% 的被检查句子被判定为语法正确。
- 专家审查后,95.56% 的自动框架分配未发生变化。
- 77.11% 的角色 span 未发生变化。
- 95.27% 的角色标签未发生变化。
-
训练划分与使用:
- 所提供文本未报告特定训练、验证或测试划分。
- 也未报告在模型训练中使用这些数据时的混合比例。
- 该数据被描述为自动标注的名词 SRL 资源,以及用于基于框架的名词谓词标注的评估或构建产物。
-
裁剪与额外处理:
- 因为数据集基于文本,没有描述图像裁剪策略。
- 主要处理细节包括基于 sense 的过滤、名词化、格式验证、词性与词目检查,以及角色 span 对齐。
方法
作者将 VerbAtlas 用作构建 NounAtlas 的结构基础,NounAtlas 是一个大规模名词谓词清单。VerbAtlas 将 WordNet 动词 synset 组织成语义连贯的框架,每个框架都关联稳定的论元结构和 AGENT、PATIENT、TOPIC 等语义角色。因为每个动词 synset 被精确分配到一个框架,所以相关框架语义可以转移到表达类似事件含义的名词谓词。该转移是构建 NounAtlas 和创建带框架标注的名词语义角色标注数据集的核心。
第一阶段识别行为类似事件谓词的名词 synset。如果名词谓词能支持清晰论元角色,则被视为表征事件的概念。非事件名词,例如指代人、对象或静态实体的名词,被排除。作者按 WordNet 名词分类体系中后代节点的数量对 WordNet 名词 synset 排序,然后将所选的一般类别缩减为四个根事件或过程相关 synset。保留这些根 synset 的所有直接和间接下位 synset,作为名词谓词映射的候选集。
为了将这些名词候选映射到 VerbAtlas 框架,作者利用 WordNet 派生相关形式关系,简称 DRF。这些关系把名词 sense 与相应动词 sense 连接起来。如果某个名词 synset s 通过 DRF 关系链接到动词 synset v,且 v 属于 VerbAtlas 框架,则该名词 synset 可以继承该框架。这会产生三种主要映射情况。如果 s 链接到单个动词 synset v,映射是明确的,并遵循 frame(s)=frame(v)。如果 s 链接到一组动词 synset V,当 V 中的所有 synset 都属于同一个框架时,映射仍然明确。否则,人工标注者会在链接到的候选框架中选择最合适的框架。最后,一些名词 synset 没有通往 VerbAtlas 动词 synset 的 DRF 连接,因此需要单独的排序和标注流程。
映射类别如下所示。
在这一结构中,连接到单个动词框架的名词 synset 可以自动分配。连接到来自不同框架的动词 synset 的名词 synset 需要人工整理,因为其含义与多个框架语义重叠。没有 DRF 链接到任何 VerbAtlas 动词 synset 的名词 synset 在此阶段不会被自动映射,而是交给学习排序组件。
由此得到的动词和名词 synset 在框架上的分布并不均匀。一些框架包含大量词条,另一些只包含少量词条。拥有更多动词 synset 的框架往往也会获得更多名词 synset,这反映动词清单中更广泛的语义生产力。这种偏斜分布如下所示。
为了扩大没有 DRF 链接的名词 synset 的覆盖范围,作者构建一个有监督排序模块。他们收集已经通过明确链接或人工整理链接映射到 VerbAtlas 框架的名词 synset。对于每个映射到框架 f 的此类名词 synset s,他们把 s 的定义与一个 DRF 链接到 s 且属于 v∈f 的动词 synset 的定义配对。该配对被标记为正样本对。正样本池通过将 s 的定义与从同一框架 f 中随机采样的 K 个额外动词 synset 定义进行配对来扩展。负样本对通过将同一名词 synset 定义与从不同于 f 的 K+1 个随机框架中采样的动词 synset 定义配对来生成。每个定义通过将相应 synset 的词目前置来扩展。
排序任务被表述为二元分类。正标签表示名词 synset 定义和动词 synset 定义属于同一个 VerbAtlas 框架,而负标签表示它们属于不同框架。作者使用这种构造训练一个 Cross-Encoder 模型。架构由预训练编码器,具体为 mpnet-v2,以及一个线性二元分类头组成。训练目标是二元交叉熵,优化器为 Adam,初始学习率为 3×10⁻⁵。超参数通过验证集选择,性能由二元分类任务的 F1 score 指导。
在推理阶段,训练好的模型用于为未链接的名词 synset 对 VerbAtlas 框架进行排序。对于每个框架,随机选择最多十个动词 synset 定义,并与目标名词 synset 定义配对。每对由 Cross-Encoder 打分,框架的最终得分通过其关联对的平均得分计算。随后框架按得分从高到低排序。这会生成一个相似度排序,其中排名靠前的框架代表该名词 synset 最可能的框架分配。
排名靠前的框架随后用于半自动标注步骤。专家标注者从模型产生的前五名候选中选择最合适的框架。如果所有候选都不合适,标注者可以查阅完整 VerbAtlas 清单并直接选择框架。该流程允许作者映射很大一部分未链接的名词 synset,同时使人工精力集中在模型提出的合理候选上,而不是整个框架空间。
在名词谓词清单构建完成后,作者通过把现有动词谓词标注转换为名词标注来创建名词语义角色标注数据集。流程始于 SemCor 中的句子,当这些句子包含一个 sense 标注的动词谓词,且该动词谓词的动词 synset 具有通往名词 synset 的明确 DRF 链接时被选中。这一选择保持了原始动词谓词与目标名词谓词之间的框架一致性。
下一阶段对动词谓词进行名词化。作者提示大型语言模型把句子转换为一个版本,其中指定动词被替换为相关名词 synset 中的一个派生名词。如果原句是 w1,…,wn,目标动词 token 是 wi,则指示模型从与相应名词 synset 关联的集合 {n1,…,nm} 中恰好选择一个名词替代项。所选名词会在输出句子中被标记。为了稳定输出格式和名词化行为,作者提供系统级指令和人工构造的 few-shot 示例,使模型接触不同名词化模式。
每个生成句子随后通过规则检查验证。系统检查是否按请求格式明确标记名词项,词性标注确认被标记项是名词,以及所选名词的词形属于可接受的名词 synset。如果所有检查通过,句子被接受,且名词谓词被标记为继承的框架,其中对于所选名词形式 nj 和原始动词 synset v,有 frame(nj)=frame(v)。
最后阶段把语义角色标注从动词句子迁移到名词化句子。原始句子 σv 由 InVeRo-XL 处理,生成动词谓词的 span 级论元角色。原始句子 σv 和名词化句子 σn 都使用 bi-encoder 编码。对于 σv 中的每个动词角色 span,作者计算 span embedding Er,方法是平均池化该 span 内各 token embedding 并应用 L2 归一化。然后他们在 σn 上滑动与 span 长度相同的窗口,为每个候选 span 计算 embedding Esp,并选择最大化余弦相似度的名词 span:
sp∗=argspmaxcos(Er,Esp)随后把动词 span 的角色标签分配给所选名词 span。该流程生成这样的句子:名词谓词被标记为 VerbAtlas/NounAtlas 框架,其论元 span 被标注为相应语义角色。
实验
评估包括为未链接名词 synset 分配 VerbAtlas 框架的 Cross-Encoder 排序模型、对自动生成的名词 SRL 语料的人工审计,以及在动词、名词和混合数据上训练的 SRL 基线。排序结果表明,定义配对打分能够领先候选中识别合理框架,使缺失链接的人工标注更高效。语料审计表明,大多数生成句子语法正确并保留正确框架和角色标签,尽管论元 span 可靠性较低;基线结果则表明,仅动词模型对名词谓词的泛化较差,而名词训练或混合训练能够形成有竞争力的统一动词与名词 SRL 系统。
基于 WordNet 的映射主要派生关系将名词 synset 连接到动词框架,其中 Unambiguous 链接构成最大的自动映射组。人工整理链接是必要的,用于相关动词 sense 指向不同框架的额外 synset。最大类别是不直接获得 WordNet 框架链接的名词 synset。Unambiguous 派生链接比人工整理的框架分配更频繁。相当一部分名词 synset 没有通过直接 WordNet 动词框架链接完成映射。
Cross-Encoder 用于通过分类名词和动词定义是否属于同一框架,为未链接名词 synset 对候选框架排序。其二元分类准确率和 F1 score 都很强,并且当考虑更多候选框架时,top-k 准确率稳步提升。当允许前五名候选时,正确框架最常被恢复,这表明即使首位准确率较低,排序仍然有用。高二元分类准确率和 F1 score 表明模型能够可靠区分同框架与不同框架的定义对。top-k 准确率随着 k 增大单调上升,这意味着更准确的排序有助于恢复正确动词框架。
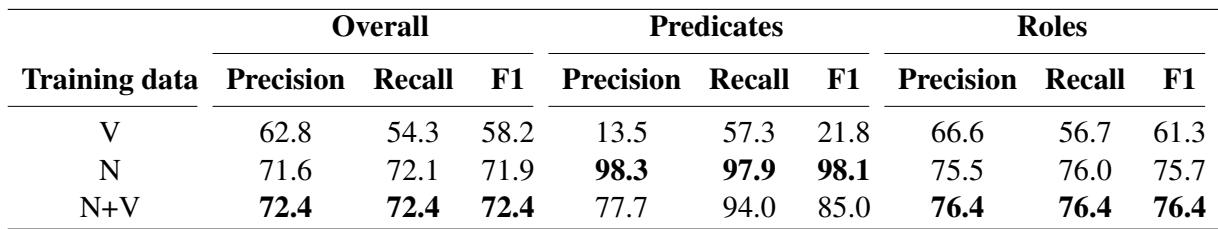
仅在动词语义角色标注数据上训练的模型向名词测试集迁移时只有有限效果,而在名词数据上训练带来更强的结果。混合动词和名词训练整体表现最佳,其中谓词召回率特别高,角色级分数也略高于仅名词训练。这些趋势支持使用名词数据,尤其是与动词数据结合使用,以改善名词语义角色标注。仅动词训练在名词数据上谓词识别能力较弱。仅名词训练大幅提升相对仅动词训练的整体性能。同时在动词和名词数据上训练在名词结果上最强。
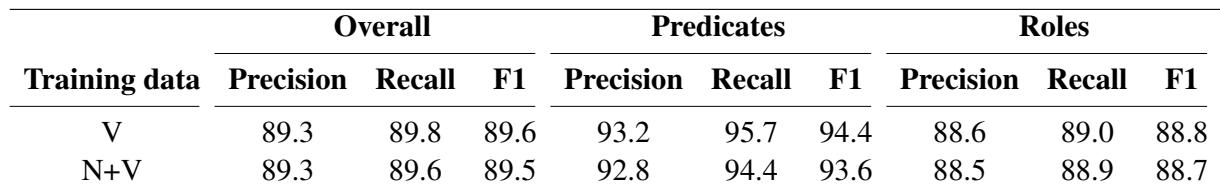
在 OntoNotes 动词语义角色标注数据上训练,以及在动词和名词数据并集上训练,在 OntoNotes 上产生总体相近的性能。混合模型在谓词和角色检测上保持有竞争力,而仅动词基线在动词谓词召回率上略强。这些结果支持将混合基线用作动词与名词 SRL 的统一系统。加入名词训练数据几乎不改变动词 OntoNotes 性能。混合动词与名词模型在 OntoNotes 上仍与仅动词基线保持竞争力。
实验考察 WordNet 派生关系如何把名词 synset 连接到动词框架,使用 Cross-Encoder 为未映射情况排序候选,并评估语义角色标注在动词与名词谓词之间的迁移。WordNet 提供了有用的起点,但留下了很多未映射 synset 并需要人工整理,而排序模型能够可靠识别同框架配对,并在较小候选列表中更频繁地恢复正确框架。对于语义角色标注,名词训练相比仅动词迁移显著改善,联合动词和名词训练在名词性能上最强,同时不牺牲动词 OntoNotes 结果,这支持统一建模方法。