Command Palette
Search for a command to run...
MAP 尚未消亡:通过条件化手段消除退化以揭示语言模型的真实模式
MAP 尚未消亡:通过条件化手段消除退化以揭示语言模型的真实模式
Davis Yoshida Kartik Goyal Kevin Gimpel
摘要
人们已广泛观察到,从自然语言生成(NLG)模型中进行精确或近似的 MAP(模式搜索)解码始终导致退化输出(Holtzman et al., 2019; Stahlberg and Byrne, 2019)。已有工作将此行为归因于概率模型中模式的根本性且不可避免的缺陷,或语言建模的薄弱环节。与此不同,我们认为即使不存在任何建模误差,退化模式也可能因训练数据的污染而发生。具体而言,我们指出即使仅将极少量低熵噪声混入群体文本分布,也可能导致该数据分布的模式发生退化。因此,我们提出将 MAP 解码应用于模型的真实条件分布,其中条件变量明确规避了特定的退化行为。通过精确搜索,我们实证验证了机器翻译模型和语言模型中长度条件模式的确比其无条件模式更流畅且更切合主题。我们首次分享了来自这些模型以及 LLaMA-7B 多个变体的大量精确模式序列示例。值得注意的是,我们观察到即使在 LLaMA-7B 的规模下,各种退化模式依然存在。尽管我们无法通过精确搜索来有效处理这些退化问题,但我们在 LLaMA-7B(一个并非为指令遵循而训练的模型)上进行了基于分类器的近似搜索,发现无需任何微调即可获得合理的输出。
一句话总结
芝加哥丰田技术研究院和佐治亚理工的研究者认为,语言模型中 MAP 解码退化的根源在于训练数据污染,而不是模型能力不足;他们提出长度条件化 MAP 搜索,以恢复流畅的众数序列,并通过基于分类器的近似搜索证明,无需微调即可从 LLaMA-7B 中引出合理输出。
核心贡献
-
对退化 MAP 输出的理论解释表明,即使向文本分布中混入极少量低熵噪声,全局众数也会退化,即便模型本身没有误差。该解释也澄清了 MAP 搜索和采样对噪声具有不同响应。
-
提出属性条件化 MAP 解码,用于在给定显式属性(例如输出长度)的条件下搜索条件分布的众数。在机器翻译和语言模型上进行的精确长度条件化搜索表明,这些众数比无条件众数更流畅、更贴合主题。
-
展示了来自多个自回归模型的精确众数序列,包括 LLaMA-7B 的变体,表明即使在该规模上,退化众数也可能持续存在。在 LLaMA-7B 上,基于分类器的近似条件化搜索无需指令微调即可引出合理输出。
引言
在神经语言生成中,尤其是机器翻译和故事生成,解码过程直接控制最终文本质量。采样方法占据主导地位,因为近似 MAP 解码通常会产生空输出或重复文本等退化结果;以往工作大多将原因归咎于模型偏差,或认为众数在统计上不重要。作者认为,训练数据中的低熵干扰项甚至可能在完美训练的模型中产生这类糟糕众数,因此问题并非纯粹的模型缺陷。他们提出属性条件化搜索,利用长度或基于分类器的质量等属性定位更干净的条件众数。作者的贡献包括对退化众数的理论解释、一种使 7B 模型上精确搜索成为可能的缓存启发式方法、在 MT 和故事生成中长度条件化众数往往高质量的证据,以及一种近似分类器引导的 beam search 方法,能够找到比普通 beam search 具有更高似然和更高质量的输出。
方法
作者利用解码侧框架来应对 MAP 类生成中的坏众数问题。他们的一项关键观察是,采样方法通过抑制低概率长尾并降低熵来减少输出退化,但众数搜索缺少类似保障,因为即使模型成功拟合数据,全局众数仍可能退化。提出的解决方案是属性条件化搜索。该方法不搜索输出分布的全局众数,而是搜索条件分布的众数:
ycond∗=yargmaxPmodel(y∣x,A(y)=a)这里,x 表示输入上下文,y 表示候选输出,A(y)=a 指定一个属性约束,例如输出长度。这种表述将众数解码转化为约束搜索问题。例如,当主导的退化众数是短截断序列时,可以将属性设为 A(y)=∣y∣,使搜索返回指定长度的最高分序列。
精确搜索组件通过深度优先搜索和激进剪枝探索自回归输出序列。这使得在原本具有指数级搜索空间的模型中也能恢复精确的无条件或长度条件化众数。作者通过引入一种缓存策略,将这一精确搜索过程扩展至大型自回归语言模型,以在类 beam 遍历部分前缀时降低内存压力。该精确搜索阶段充当诊断和验证模块:它确认短输出可能是某些模型的确切众数,也确认在一些场景下施加简单长度条件即可恢复高质量序列。
由于精确条件化搜索在现实输出长度上计算量难以承受,作者通过条件化 beam search 实现属性条件化解码的近似版本。标准 beam search 通过维护部分假设 x1:t 并按模型累计对数似然排序来逐步构建序列:
S(x1:t)=i=1∑tlogPmodel(xi∣x<i)为了搜索条件众数,需要将分数适配到目标属性:
S′(x1:t,a)=i=1∑tlog(Pmodel(xi∣x<i,A(x)=a))直接计算该表达式是不可行的,因为模型无法提供给定全局属性后每个下一个 token 的 token 级条件概率。因此作者应用贝叶斯规则,并利用许多项在时间步之间可望远镜式抵消这一事实。丢弃不影响排序的常数项后,所需分数可表达为普通 beam 分数加上属性分数:
S′(x1:t,a)=S(x1:t)+logPmodel(a∣x1:t)实践中,第二项由学习得到的前缀分类器估计。该分类器经过训练,用于预测某个部分前缀是否可能扩展为满足目标属性的完整输出。近似条件分数变为:
S′(x1:t,a)≈S(x1:t)+logPclf(a∣x1:t)这得到一个模块化解码流程。首先,语言模型生成部分假设并计算其标准 token 级对数概率。其次,前缀分类器评估排名靠前的候选前缀对于目标属性的适用性。第三,将两个分数相加形成条件 beam 分数。第四,使用该调整后的分数对 beam 进行剪枝和扩展。该流程与普通 beam search 几乎相同,只是在排序阶段加入了分类器输出。这种设计避免在每个时间步累积分类器不确定性,因为分类器作为序列级前缀分数应用,而不是作为贯穿整个生成过程累加的 token 级修正项。
为了提高计算效率,前缀分类器在每个解码步骤只应用于有限的高排名候选 token,而不是完整词表。这使近似搜索负担可控,同时仍让解码器更偏好更可能满足目标属性的部分序列。结果是一种面向条件众数的属性引导 beam search,适用于现实翻译长度,并能缓解仅靠精确无条件众数搜索无法处理输出退化问题。
实验
在机器翻译、故事补全和指令跟随模型中,精确众数搜索表明,无约束的最高分输出经常为空或出现其他退化,尤其是面对更长和更开放输入时;而非空众数通常较为流畅。案例研究和基于长度的近似条件化搜索表明,将搜索约束到合理的输出长度可消除许多退化,并产生语法正确、高质量的序列。对学到的质量属性进行额外条件化也能提升 LLaMA 指令跟随输出,这表明退化众数更多反映搜索伪影,而非糟糕模型表示。
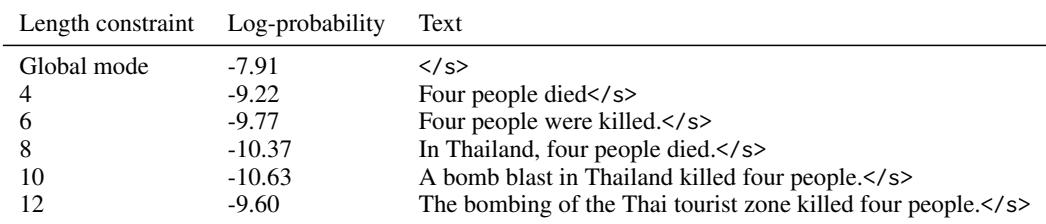
表格比较模型的全局众数与在显式长度约束下产生的输出。无约束众数为空,而长度约束输出形成有效翻译,并随着目标长度增加变得更信息丰富。较短约束输出较简短,较长约束输出增加上下文细节,并显得更完整。长度条件化在该翻译示例中消除了空全局众数。较长长度约束翻译比较短约束众数包含更多细节。在拥有足够长度后,约束输出看起来语法正确。
以更长目标长度为条件的众数输出比以更短长度为条件的输出或全局众数获得更好的 BLEU 和 BLEURT 分数。随着长度约束增加,BLEU 上升;BLEURT 在全局众数和最短条件之间不变,之后随长度增加而稳定提升。这支持如下观察,即当目标长度足够时,长度条件化翻译变得更流畅、质量更高。更长的长度约束对应更高翻译分数。最短的和全局众数输出得分较低,尤其在 BLEU 上。
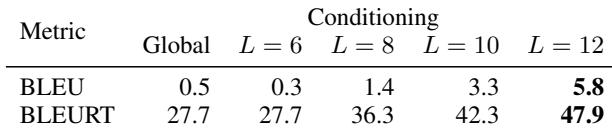
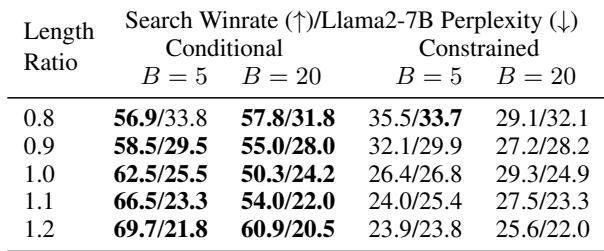
在大多数长度目标和 beam 大小下,分类器引导的 beam search 通常比直接约束搜索找到更高似然的翻译,并且在 Llama2-7B 估计下也倾向于获得更好的流畅性。约束搜索在困惑度上具有竞争力,但其搜索胜率明显更低,尤其对于较小 beam 和较长目标。更大的 beam 缩小两种方法之间的差距,但分类器引导搜索仍保持更高似然和更高 BLEURT 质量。在所报告长度比例上,分类器引导搜索在搜索胜率上一致优于约束搜索。条件化输出更可能具有语法正确性,而普通约束 beam search 可能无法产生有效输出。对于条件化输出,Llama2-7B 困惑度相近或更好,表明流畅性相当或有所改善。增加 beam 大小会让两种方法更接近,但条件化搜索仍给出更好似然和 BLEURT 分数。
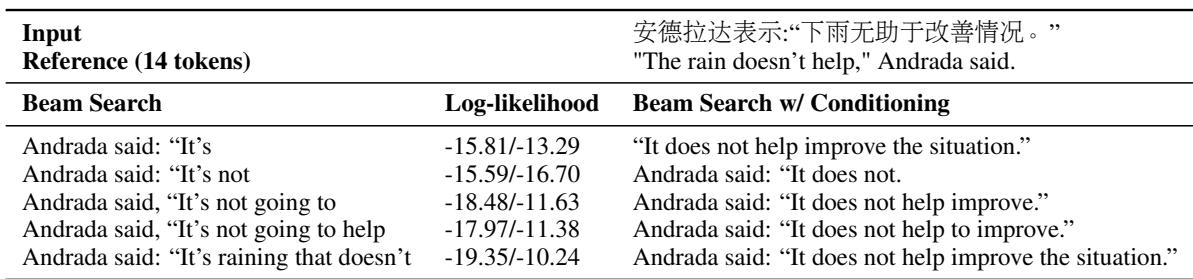
前缀分类器引导改变了中文到英文的解码结果,产生比普通 beam search 输出更完整、语法更正确的译文。示例显示,无引导的 beam search 可能截断或输出片段,而引导解码常常返回更接近参考译文的更完整句子。引导解码比 beam search 片段产生更完整翻译。无引导 beam search 可能偏好不完整或流畅度较低输出。
在受评测的指令跟随子集上,人类评分者、GPT-4 和奖励模型都更偏好条件化 beam search 而非普通 beam search。即使排除空输出,这种优势仍然存在,表明条件化提升的不只是空白响应情况。定性来看,条件化输出也更经常语法正确,而普通 beam search 更可能产生退化或低质量失败。人类评分者、GPT-4 和奖励模型平均而言都更偏好条件化输出而非普通 beam search 输出。即使普通 beam search 产生非空输出,条件化生成仍然更频繁地获得更高奖励结果。条件化输出在定性上比普通 beam search 输出更可能语法正确。
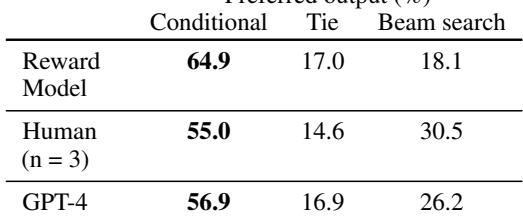
实验在翻译和指令跟随任务上比较无约束、长度约束和分类器引导的解码。它们表明,长度条件化消除空全局众数,并产生更完整、语法更正确和更高质量的输出,且随着目标长度增加分数提高。分类器引导和条件化 beam search 也优于普通搜索,因为它们产生更有效、更流畅的输出,并获得更强的自动、人类和模型评判,尤其是在无约束搜索容易发生截断或退化失败时。