Command Palette
Search for a command to run...
MMToM-QA:多模态心智理论问答
MMToM-QA:多模态心智理论问答
Chuanyang Jin Yutong Wu Jing Cao Jiannan Xiang Yen-Ling Kuo Zhiting Hu Tomer D. Ullman Antonio Torralba Joshua B. Tenenbaum Tianmin Shu
摘要
心智理论(Theory of Mind, ToM),即理解他人心理状态的能力,是开发具备人类水平社会智能的机器所不可或缺的关键要素。近期的机器学习模型,尤其是大语言模型,似乎在心智理论理解的某些方面展现出了能力。然而,现有的心智理论基准测试仅使用单模态数据集——视频或文本。相比之下,人类的心智理论能力远不止于对视频或文本的理解。人们能够基于从任何可用数据中提取的概念表征(如目标、信念、计划),灵活地对他人的心智进行推理。针对这一问题,我们提出了多模态心智理论问答基准(MMToM-QA)。MMToM-QA 在多模态数据以及关于人物在家庭环境中活动轨迹的不同类型单模态数据上,全面评估机器的心智理论能力。为构建多模态心智理论能力,我们提出了一种新方法 BIP-ALM(语言模型加速的贝叶斯逆向规划)。BIP-ALM 从多模态数据中提取统一表征,并利用语言模型实现可扩展的贝叶斯逆向规划。我们对人类表现、BIP-ALM 以及包括 GPT-4 在内的最先进模型进行了系统性对比。实验表明,大语言模型和多模态大模型仍然缺乏稳健的心智理论能力。相比之下,BIP-ALM 通过结合基于模型的心智推理和语言模型的优势,展现出了令人期待的结果。
一句话总结
纽约大学、哈佛大学、MIT 等机构提出 MMToM-QA,这是一个多模态心智理论问答基准,用于在来自家庭环境的多模态与单模态数据上评估机器;同时提出 BIP-ALM,该方法从多模态数据中提取统一表示,并借助语言模型进行可扩展的贝叶斯逆向规划。结果表明,大型语言模型和多模态模型仍然缺乏稳健的心智理论能力,而 BIP-ALM 通过将基于模型的心智推理与语言模型相结合,取得了有前景的结果。
核心贡献
- 论文提出 MMToM-QA,这是一个面向家庭活动的心智理论多模态问答基准,用于根据视频、文本以及组合多模态输入来推理一个人的目标和信念,并通过人类实验提供基线。
- 论文提出 BIP-ALM,该方法从多模态数据中提取符号表示,并将贝叶斯逆向规划扩展为使用在人类活动数据上微调的语言模型,以评估关于一个人信念和目标的假设。
- 论文系统比较了人类表现、BIP-ALM 和包括 GPT-4(V) 在内的最先进模型,表明现有大型语言模型和多模态模型会产生系统性的心智理论错误,而 BIP-ALM 显著优于这些模型。
引言
心智理论使系统能够从行为中推断人的目标、信念和欲望,从而支持更安全、更有效的人工智能应用,例如辅助机器人、AI 教师和自动驾驶车辆。作者指出,先前大多数心智理论基准仅使用文本或视频,这限制了模型在人类所使用的因果性、多模态心智推理上的测试程度。作者还认为,对大规模训练数据的依赖可能鼓励模式匹配,而不是真正类人的推理。为解决这一问题,作者提出 MMToM-QA,这是一个结合视频、文本以及关于目标和信念问题的多模态心智理论基准。作者还提出 BIP-ALM,该方法将贝叶斯逆向规划与语言模型相结合,以进行高效、可解释的多模态心智状态推理。
数据集
-
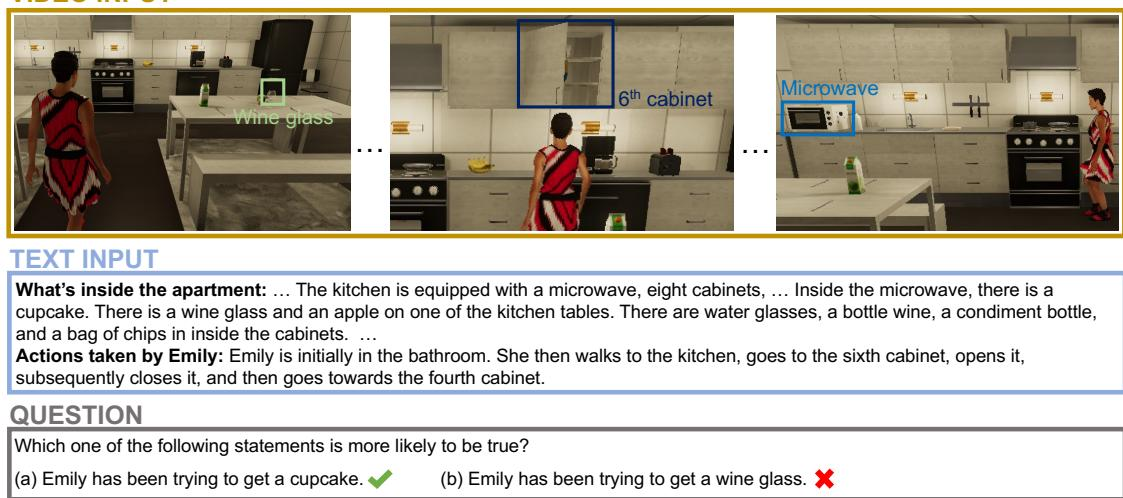
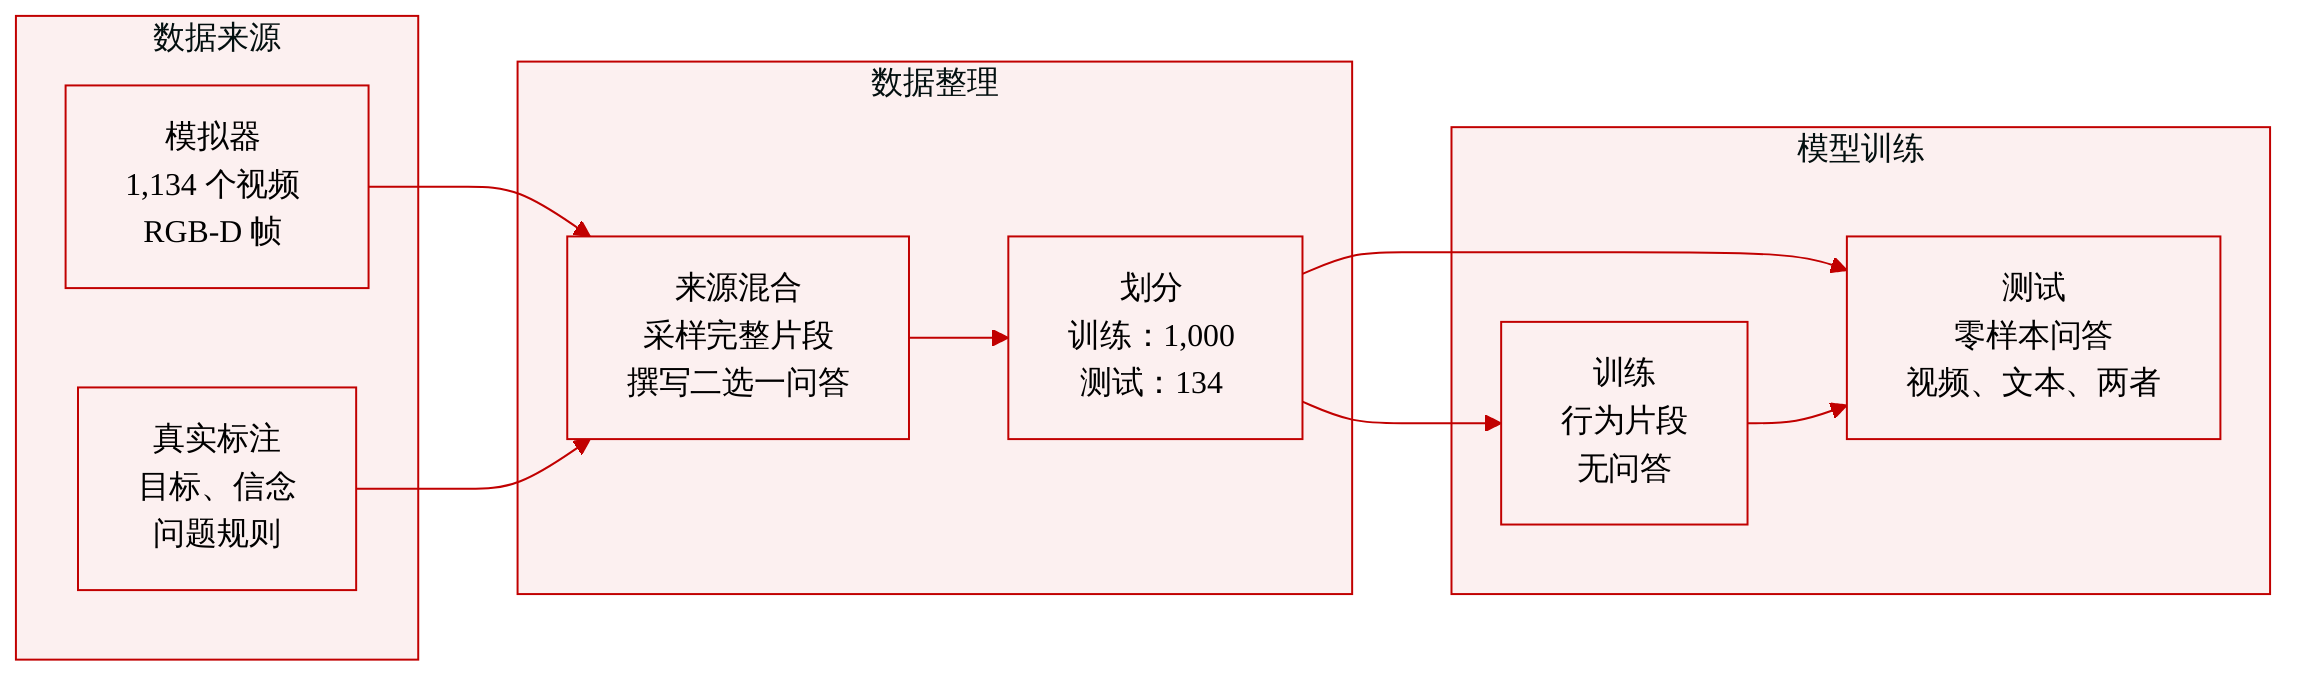
作者基于模拟家庭视频构建 MMToM-QA 基准。该基准包含 134 段视频,展示一个人在家庭环境中寻找日常物品。平均而言,每段视频包含 1,462 帧,并描绘 36 个动作。
-
该基准包含 600 个关于一个人目标和信念的二选一问题。每个问题都配有完整活动视频片段,视频片段以 RGB-D 帧形式提供,并配有场景和该人所执行动作的文本描述。
-
问题分为七种问题类型。三种信念推断类型各包含 100 个问题,共 300 个信念问题。四种目标推断类型各包含 75 个问题,共 300 个目标问题。
-
问题类型涵盖真实信念、错误信念、长期信念跟踪、真实信念下的目标推断、错误信念下的目标推断、更新信念下的目标推断,以及需要推理可能未来动作和空间关系的目标推断。
-
这些视频和问题由程序化生成流程在 VirtualHome-Social 具身家庭模拟器中生成。该模拟器生成类人活动,并提供场景、物体、动作、目标和信念的真实标注。
-
对每个问题,作者会采样一种问题类型以及根据该问题类型定义选择的两个对立假设。然后,文本描述和问题会由真实状态、动作以及采样假设借助 GPT-4 生成。
-
数据不会被裁剪到局部时间窗口。评估片段覆盖对应视频中的完整活动,随附文本描述场景和该人观察到的动作。
-
对于训练,作者使用一个独立的合成人类行为数据集,该数据集包含 1,000 段程序化生成的家庭视频。这些训练视频包含场景、物体、目标和信念的真实标注。
-
作者使用训练集,使模型学习人们如何在物理环境中行动时更新信念和目标。训练期间不提供示例问答对。
-
该基准用于三种设置下的零样本评估:同时包含视频和文本的多模态问答、仅文本问答和仅视频问答。除程序化生成规则、预定义问题类型和完整活动片段外,未描述其他显式过滤或裁剪策略。
方法
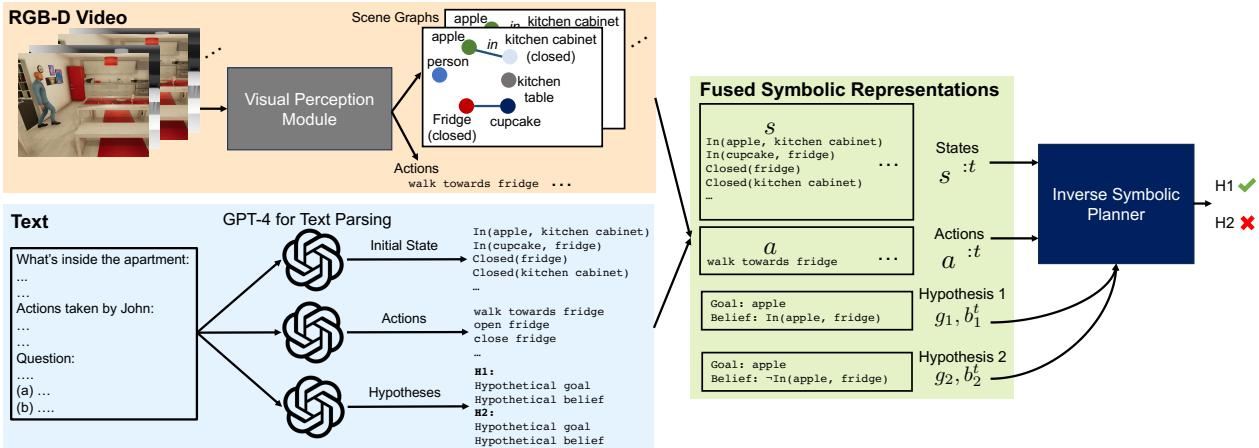
作者围绕一个多模态逆向规划流程构建模型。模型不直接将视频和文本映射到心智状态标签,而是先将两种模态转换为共享符号表示,然后使用规划器评估关于一个人目标和信念的竞争解释。总体架构包括视觉感知、文本解析、符号融合和逆向符号规划,如下图所示:
在模型处理真实测试数据之前,基准测试数据和训练示例通过程序化生成创建。作者在具身模拟器中合成家庭活动视频,每个活动都关联真实状态、动作、目标和信念。在视频的每一步,模型会采样一种问题类型和两个对立假设。随后,语言模型会将真实状态序列、动作序列和采样假设转换为自然语言描述和问答条目。同一程序化流程也用于生成训练数据,为模型提供符号状态跟踪、动作预测、信念表示和心智状态比较的监督信号。
对于给定推断实例,BIP-ALM 包含四个主要模块。视觉感知模块逐帧处理 RGB-D 视频。它构建场景的体素地图,并提取一个能够捕捉实体、物体状态和空间关系的场景图。从场景图中,模型推导符号谓词,例如某个物体的位置或某个容器是否关闭,并提取高级动作指示,例如一个人走向某个特定区域。
文本解析模块处理随附的语言输入。大语言模型被提示将文本拆分为三个部分:初始环境描述、该人的动作序列以及问题。环境描述会被转换为编码物体位置和容器状态的谓词。动作序列会被转换为离散动作命令。问题会被转换为该人心智状态的两个竞争假设。每个假设包含一个目标物体和一个信念谓词,该信念谓词可以为肯定或否定。例如,一个假设可能指出该人认为某个物体在某个位置,而另一个假设指出该人不认为该物体在。
融合模块将不同模态的符号输出对齐为统一的状态和动作历史。来自视频的场景图会被翻译为与文本派生谓词兼容的谓词。初始符号状态由来自视频和文本的谓词合并形成。随后,模型将文本动作与视频中检测到的动作对齐,并将视频划分为区间,其中每个区间对应一个动作并定义一个时间步。模型从初始状态开始,使用与当前动作区间关联的视频帧,逐步更新状态谓词。这会生成符号状态序列 s1:t 和符号动作序列 a1:t。同时,两个解析出的心智状态假设会被准备为候选目标信念对。
逆向符号规划器在理性动作生成模型下比较这两个假设。作者将该人建模为一个部分可观测 agent,其行为由一个由元组 S,A,T,G,R,Ω,O,γ 定义的 POMDP 生成。这里,st∈S 是时间 t 的真实状态,at∈A 是动作,T(st∣s,a) 是状态转移模型,g∈G 是目标,rt=R(st,at,g) 是由目标诱导的奖励,ot∈Ω 是观测,ot=O(st) 将状态映射为观测,而 γ∈(0,1] 是折扣因子。agent 的信念 b(s) 是状态上的概率分布。在这项工作中,信念按物体分解,因此模型会维护关于各个目标物体可能位置的信念。
在该模型下,理性 agent 从最优策略 π(at∣g,bt) 中选择动作,以最大化期望折扣回报。因此,作者将逆向推断定义为从观测状态和动作中恢复目标与信念的任务。在确定性转移假设下,关于一个目标和信念的后验可写为
P(g,bt∣s1:t,a1:t−1)∝τ=1∏tπ(aτ∣g,bτ)P(bτ∣bτ−1,sτ)P(b0)P(g).给定两个假设 H1=⟨g1,b1t⟩ 和 H2=⟨g2,b2t⟩,规划器通过以下比值评估哪个假设更好地解释观测历史:
P(g2,b2t∣s1:t,a1:t)P(g1,b1t∣s1:t,a1:t)=π(at∣g2,b2t)P(b2t∣b^t−1,st)π(at∣g1,b1t)P(b1t∣b^t−1,st)⋅∏τ=1t−1π(aτ∣g2,b^τ)∏τ=1t−1π(aτ∣g1,b^τ).相对似然较高的假设会被选为答案。项 b^τ 表示较早步骤的估计信念。由于问题指定了关于当前步骤的信念,模型会通过随时间传播 agent 的观测来估计过去信念。初始信念被初始化为均匀分布,每一步的观测由 agent 可见的状态谓词子集表示。随后,这些观测被用于更新估计信念序列。
该表述中的计算瓶颈是策略似然 π(at∣g,bt)。作者不通过显式符号搜索或强化学习来学习传统规划器,而是使用语言模型对策略进行摊销。每一步的状态、目标和估计信念会被渲染为符号提示。信念被表达为目标物体可能位置的列表。语言模型接收当前符号状态、假设目标和假设信念,然后基于其输出 logits,为观测动作生成分数或概率分布。在训练过程中,语言模型在包含真实状态序列、信念序列、目标序列和动作序列的程序化数据上进行微调,从而学习从符号上下文中近似动作似然。
实验
实验在多模态、仅文本和仅视频零样本设置下评估 MMToM-QA 基准,以测试来自家庭视频的信念推理和目标推理。人类被试表现很强,证实了问题有效性,而通用语言模型和多模态模型仍接近随机水平,主要在简单真实信念检索上成功,但无法跟踪错误信念、信念更新和面向未来的目标推断。BIP-ALM 方法通过使用基于可能动作和心智状态的模型化推理超越了这些基线,并能够泛化到真实人类行为和未见环境,不过仍会受到视觉状态缺失和连续空间推理的制约。
在多模态评估中,人类被试在信念推断和目标推断上均表现很强,而基线模型通常接近随机水平,其中 GPT-4V 和与 GPT-4 结合的 SymbolicToM 在某些任务上展现出选择性优势。GPT-4V 在真实信念问题和一些相关信念任务上表现良好,但在错误信念和目标推断上遇到困难,特别是在需要推断 agent 更新信念或未见目标的更困难案例中。使用 GPT-J 的 BIP-ALM 在信念推断和目标推断两方面均大幅超过这些基线,支持了基于模型推理相对于直接多模态预测的优势。人类在多模态心智理论推断上表现最强,并验证了问题设计。大多数基线在信念和目标推断类型上均接近随机水平。GPT-4V 在真实信念推理上表现出选择性成功,但在错误信念和目标推断上存在系统性弱点。BIP-ALM 在信念和目标推断中均取得了显著高于基线方法的准确率。
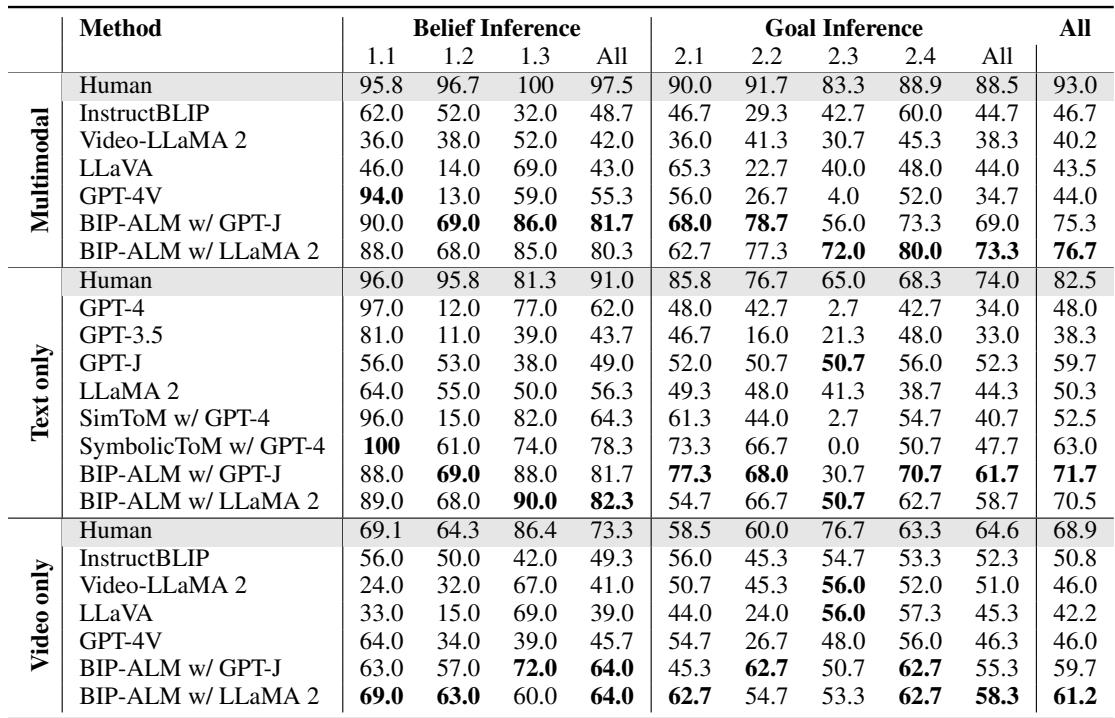
在多模态评估中,人类被试能够有效推断信念和目标,支持任务设计的有效性。大多数基线模型表现接近随机水平,而 GPT-4V 仅在真实信念推理上具有选择性优势,并在错误信念和目标推断上遇到困难。BIP-ALM 在信念和目标任务上均大幅超过这些基线,凸显了基于模型推理相对于直接多模态预测的优势。