Command Palette
Search for a command to run...
MultiPICo: Multilingual Perspectivist Irony Corpus
MultiPICo: Multilingual Perspectivist Irony Corpus
摘要
Recently, several scholars have contributed to the growth of a new theoretical framework in NLP called perspectivism. This approach aims to leverage data annotated by different individuals to model diverse perspectives that affect their opinions on subjective phenomena such as irony. In this context, we propose MultiPICo, a multilingual perspectivist corpus of ironic short conversations in different languages and linguistic varieties extracted from Twitter and Reddit. The corpus includes sociodemographic information about its annotators. Our analysis of the annotated corpus shows how different demographic cohorts may significantly disagree on their annotation of irony and how certain cultural factors influence the perception of the phenomenon and the agreement on the annotation. Moreover, we show how disaggregated annotations and rich annotator metadata can be exploited to benchmark the ability of large language models to recognize irony, their positionality with respect to sociodemographic groups, and the efficacy of perspective-taking prompting for irony detection in multiple languages.
一句话总结
亚马逊和 Aequa-Tech 推出 MultiPICo,一个来自 Twitter 和 Reddit 的多语言视角主义讽刺短对话语料库,包含细分标注和社会人口统计元数据,证明文化因素影响讽刺感知,并为评测大语言模型在讽刺识别、相对于不同人口群体的立场以及视角采择提示有效性等方面的表现提供基准。
核心贡献
-
介绍 MultiPICo,一个来自 Twitter 和 Reddit 的多语言视角主义讽刺短对话语料库,覆盖 9 种语言和 25 种高资源与低资源语言变体,包含 Post-Reply 对、细分的讽刺标注以及标注者的社会人口统计元数据。
-
分析不同社会人口群体之间的讽刺标注分歧,揭示感知差异较高、与年龄和学生身份相关的强极化,以及在德语、英语和西班牙语中,标注者国籍与跨语言变体一致性之间的关联。
-
在无社会人口统计信息的提示、基于特征视角的提示以及数据驱动视角示例提示之间进行比较,以基准评测大语言模型在视角主义设置下的讽刺检测,同时立场分析表明 ChatGPT 与最年轻标注者的判断更接近。
引言
作者利用 AI 在理解社交媒体交流方面日益增长的作用;讽刺检测支持内容审核、包容性以及大语言模型评测,同时研究表明数据集设计和标注者人口统计特征会塑造模型行为。以往研究通常将主观语言判断视为单一标签,而现有细分的讽刺数据集稀缺、范围狭窄且大多为英语,因此多语言变异和社会人口统计分歧覆盖不足。其主要贡献是 MultiPICo,一个包含九种语言和 25 种变体的 Post-Reply 对多语言视角主义语料库,发布时附带细分的讽刺标注和标注者元数据,用于分析人口统计特征如何影响讽刺感知,并用于在带有社会人口统计提示的设置下评测大语言模型立场。
数据集
-
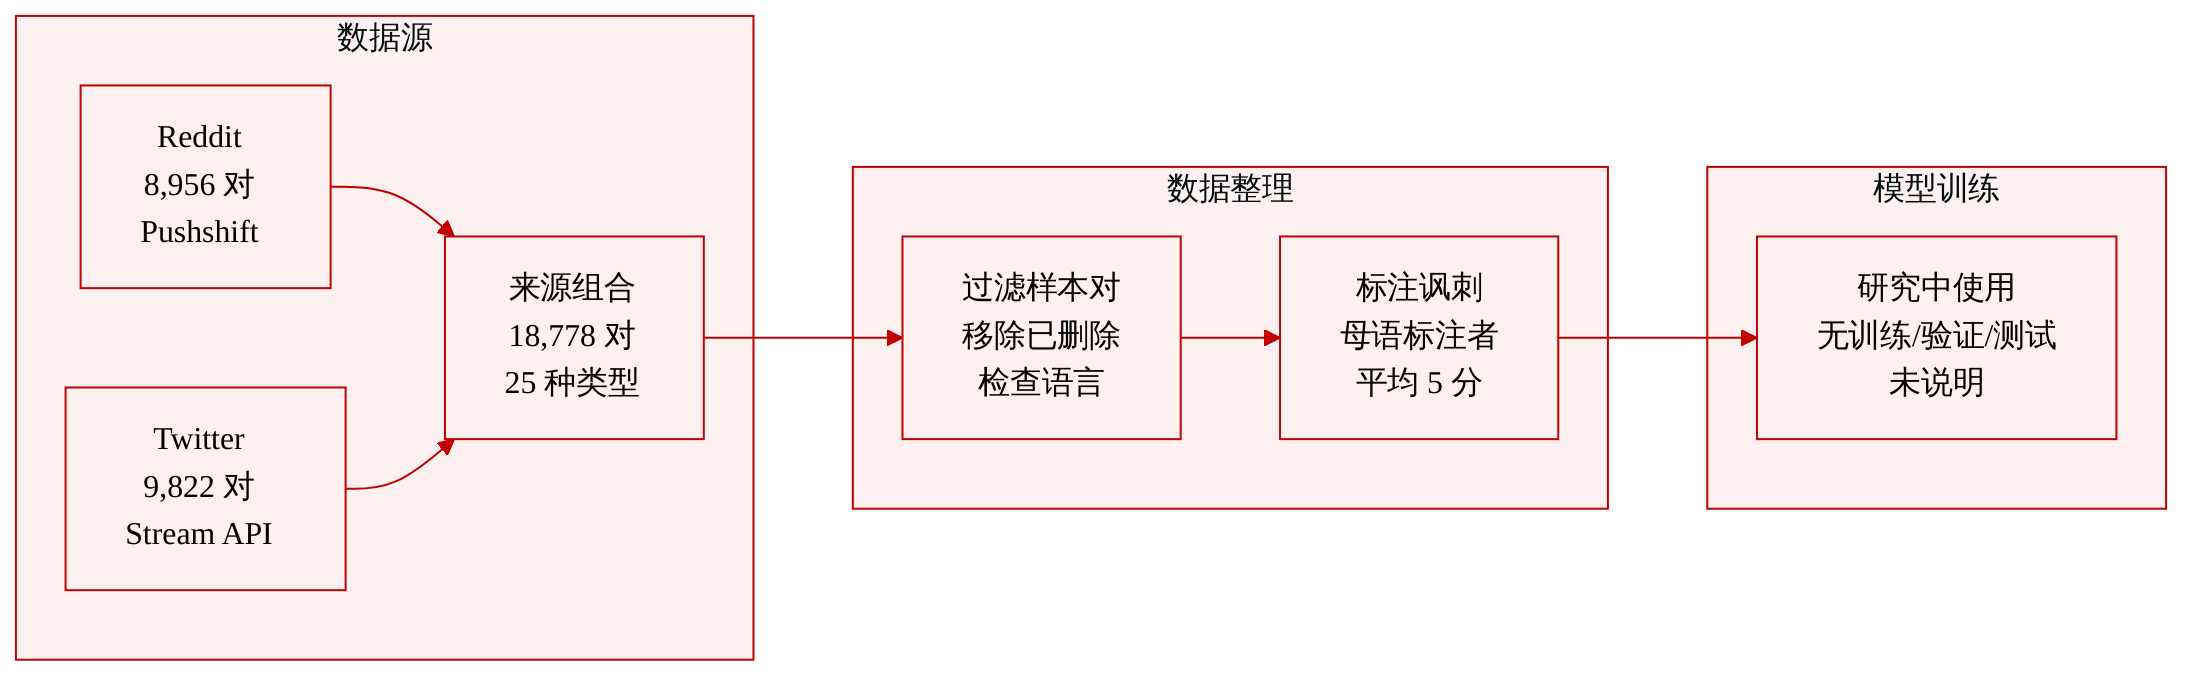
作者使用 MultiPICo,这是一个包含 18,778 个简短 Post 与 Reply 对话对的语料库,其中来自 Reddit 的有 8,956 对,来自 Twitter 的有 9,822 对,覆盖 9 种语言和 25 种语言变体。
-
Reddit 部分使用 Pushshift 仓库在 2020 年 1 月至 2021 年 6 月期间收集。作者选择了 26 个 subreddit,并根据 subreddit 成员身份推断语言变体。他们保留了对话起始消息和直接回复,主要是一级评论,并包含少量二级评论。
-
Twitter 部分通过 Twitter Stream API 收集。作者使用地理位置信息,排除引用推文和转推,检索完整对话,并保留直接回复起始帖子的推文。
-
作者应用过滤规则移除包含已删除或被移除评论的对,并使用语言识别库 LangID 验证目标语言。他们尝试平衡 Reddit 和 Twitter 的配对数量,但 Reddit 缺少足够的数据用于美国西班牙语、瑞士德语、伊拉克阿拉伯语和也门阿拉伯语。
-
每个示例都是一个 Post 与 Reply 对及关联元数据,包括原始 Post 和 Reply ID、subreddit 名称以及地理位置信息。最终标注元数据还记录标注者性别、国籍、年龄组、族裔、学生身份和就业状态。
-
作者在众包平台 Prolific 上收集讽刺标签,使用定制界面将 Post 作为上下文呈现,并询问 Reply 是“有讽刺”还是“无讽刺”。每个实例平均获得 5.02 条标注,并限制单个实例可被标注的次数。
-
标注者必须达到至少 99% 完成率,必须为目标语言母语者,并尽可能在性别和国籍上保持均衡。作者为每种语言变体招聘约 24 名标注者,英语除外,约为 15 名;由于标注者稀缺,无法保持阿拉伯语的均衡。
-
通过以 1% 概率嵌入注意力问题来检查标注质量。注意力问题正确率低于 50% 的标注者被排除,最终标注池保留 506 名标注者。
-
本文使用 MultiPICo 作为人工标注的讽刺语料库,并以此为基础对社会人口维度上的标注极化进行探索性分析。所提供文本未描述模型训练划分、混合比例或裁剪策略。
方法
作者将 MultiPICo 设计为短对话语料库和标注流程,而不是模型架构。核心目标是构建具有上下文意识的 Post-Reply 对,并收集关于 Reply 是否包含讽刺的人工判断。该流程结合针对特定来源的数据采集、语言和质量过滤、基于界面的标注、标注者筛选以及人口统计信息收集。
语料库来自两个社交媒体来源:Reddit 和 Twitter。对于 Reddit,作者抓取评论线程,并在多数情况下保留第一条评论,适当情况下包含少量二级评论。Reddit 数据通过 Pushshift 在 2020 年 1 月至 2021 年 6 月的固定时间窗口内收集。为了覆盖多种语言变体,作者选择与特定语言社区相关的 subreddit,并根据 subreddit 上下文推断 Reddit 用户的语言变体。在过滤阶段,包含已删除或被移除内容的 Post-Reply 对被排除。目标语言识别则使用 LangID 进一步完成。
对于 Twitter,作者通过 Twitter Stream API 收集数据,并使用地理位置信息支持语言变体覆盖。引用推文和转推被排除,作者检索选定推文周围的完整对话,然后保留直接回复原始起始消息的推文。其设计目标是获得来自 Reddit 和 Twitter 数量可比的 Post-Reply 对,但某些语言变体缺少足够的 Reddit 数据,导致不同变体间的来源覆盖不均衡。
标注流程通过 Prolific 上定制界面实现。该界面将 Post 作为对话上下文呈现,并要求标注者将 Reply 分类为“有讽刺”或“无讽刺”。这种设计将标注任务简化为二元判断,同时保留讽刺解读所需的短对话结构。作者还为每个实例存储元数据,包括 Post 和 Reply 标识符、Reddit 数据的 subreddit 信息以及 Twitter 数据的地理位置数据。
为了确保标注可靠,作者对每个实例设置标注预算,每个实例平均约为 5.02 条标注。标注者选择基于严格标准。每位标注者必须至少有 99% 的完成率,并且必须是目标语言母语者。招募的标注者池还须在性别和国籍上保持均衡,在多数情况下每种语言变体约为 24 名标注者,英语子集约为 15 名标注者。对于某些阿拉伯语变体,作者报告由于可用标注者有限,无法保持均衡。
质量控制被整合到标注任务本身。作者以 1% 的概率插入注意力检查问题,并将其格式化为显式的指令遵循提示,例如要求标注者回答指定数值。标注者必须在这些检查中至少达到 50% 的正确率。未达到阈值的标注者的标注会被移除,最终得到 506 名标注者组成的标注池。除了二元讽刺标签外,作者还收集年龄组、族裔、学生身份和就业状态等人口统计属性,以支持后续标注者差异分析。
实验
实验使用 MultiPICo 的极化分析,比较不同社会人口群体之间以及基于国籍划分的实例级差异,并与随机基线对比,表明讽刺解读通常在语言层面共享,但在特定语言变体中变得文化敏感。随后,实验在汇总评价和视角主义评价上对零样本大语言模型进行基准测试,发现当前模型难以检测讽刺,尤其在开放和非主流语言环境中。对模型立场和视角采择提示的进一步分析表明,大语言模型可能继承标注者偏差,而在某些语言中,数据驱动的少样本示例能够比固定的人口统计提示更可靠地提升视角敏感的讽刺检测。
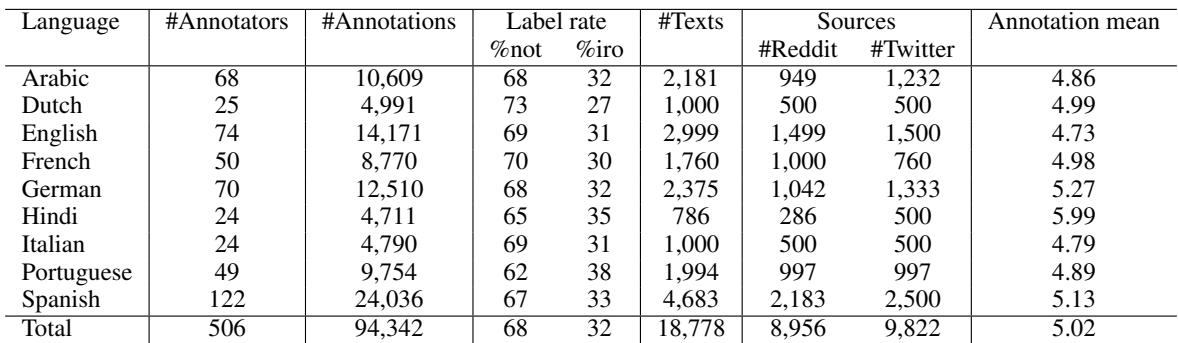
表格总结了短 Post 与 Reply 对话的多语言标注覆盖情况,展示不同语言之间标注者池、标注总数、文本数量和来源构成的变化。大多数列出的语言中,每篇文本的平均标注数接近五条,而标签比例一贯偏向“无讽刺”而非“有讽刺”。在所列出语言中,印地语的平均标注数最高,且“有讽刺”和“无讽刺”的分布最均衡。语言覆盖不均衡,某些语言的文本和标注量远高于其他语言。Reddit 和 Twitter 为所列语言划分提供了贡献,但相对占比因语言而异。
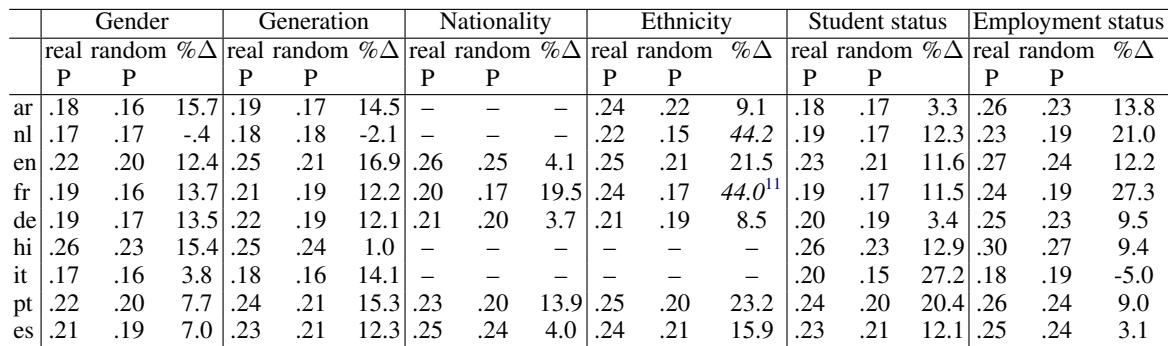
在不同语言中,观察到的标注者一致性在大多数人口统计维度上通常超过随机一致性,仅有个别维度出现负向差距。相对极化最明显的是代际和学生身份,表明这些特征在讽刺判断中最清晰地区分标注者。族裔也在若干语言中显示出显著极化,但某些比较缺失或定义较弱。大多数实际 P-index 值高于随机基线。代际和学生身份是最稳定的极化维度。少数语言与维度组合显示接近零或负的差值。族裔在部分语言中产生特别大的相对差距。
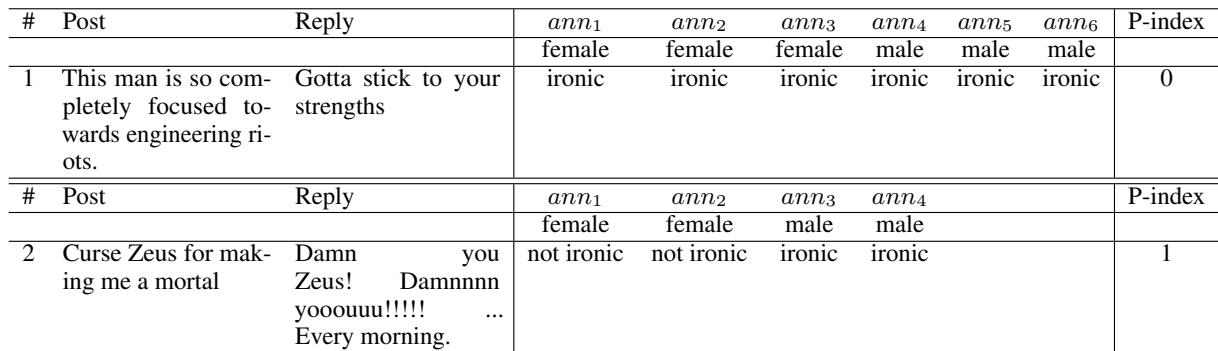
这些示例展示讽刺标注如何按性别等社会人口群体被划分。在一个示例中,女性和男性标注者具有相同解读,因此不存在跨组极化。在另一个示例中,各群体内部一致,但对同一 post-reply 对赋予不同标签,表明强极化和感知的歧义。性别群体内部的一致可以与群体之间的分歧并存。高极化标记出可能从视角采择提示中受益的实例。基于性别的标注分组揭示了存在歧义的讽刺示例。
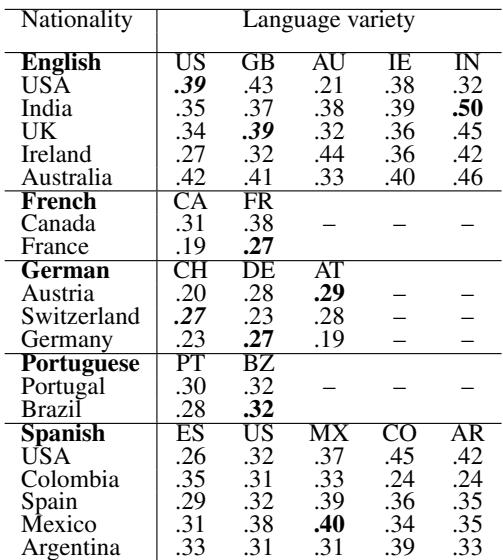
P-index 趋势表明,讽刺解读往往以国家为基础;当标注者评判属于自身语言和文化体系的变体时,一致性更强。这一模式在德语和英语变体中最为明显,在墨西哥西班牙语中也有观察到。法语和葡萄牙语显示出更弱或更不具体的对齐关系,某些变体对极化的影响大于标注者来源。德语和奥地利式讽刺表现出最清晰的国家与语言匹配。印度英语在印度标注者中产生更强一致性,美国英语和英国英语也出现类似的对应国家模式。墨西哥标注者在墨西哥西班牙语中报告更高的讽刺一致性。法语和葡萄牙语讽刺判断不够清晰,并且可能由特定变体驱动,而与标注者来源无关。
零样本讽刺检测在不同模型和语言之间显示出较大差异。ChatGPT 在大多数语言中获得最佳结果,而开源模型通常得分更弱、可靠性更低,尤其在阿拉伯语和法语场景中。输出还显示,许多模型并未严格遵循所要求的“有讽刺”或“无讽刺”标签,这增加了另一层不确定性。ChatGPT 在正类别上通常强于开源模型,但在荷兰语上表现不佳。PolyLM 和其他开源模型往往接近随机或无法识别讽刺,尤其在阿拉伯语和法语中。语言提示和标签映射很重要,因为模型有时会输出非标准结果,需要归一化处理或计为错误。
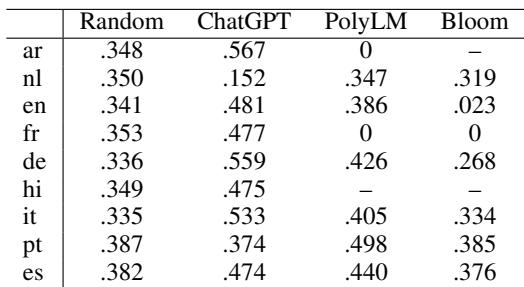
实验评估多语言讽刺标注、社会人口统计分歧、语言文化对齐以及零样本模型检测。结果显示,标注覆盖率和标签分布在不同语言间存在差异,而某些人口统计维度,尤其是代际、学生身份、族裔和性别,可能产生不同的讽刺判断。P-index 趋势表明,当标注者共享相关语言和文化语境时,讽刺往往更容易被识别,尽管这一效应在某些语言中比其他语言更明显。ChatGPT 通常优于开源模型,但结果仍不均衡,并且不一致的标签输出会降低模型可靠性。