Command Palette
Search for a command to run...
Aya 模型:一个指令微调的开放访问多语言语言模型
Aya 模型:一个指令微调的开放访问多语言语言模型
摘要
大型语言模型(LLM)的近期突破集中在少数数据丰富的语言上。要将这些突破的受益范围扩展到第一类语言之外,需要什么?我们的工作提出了 Aya,一个大规模多语言生成语言模型,能够在 101 种语言中遵循指令,其中超过 50% 被认为是低资源语言。Aya 在大多数任务上的表现优于 mT0 和 BLOOMZ,同时覆盖的语言数量是其两倍。我们引入了 extensive 的新评估套件,将多语言评估的最先进水平扩展到 99 种语言——包括判别式和生成式任务、人工评估以及模拟胜率,涵盖留出任务和分布内性能。此外,我们对微调混合数据的最佳组成、数据剪枝以及模型的毒性、偏见和安全性进行了详细调查。
一句话总结
Cohere For AI、布朗大学和卡内基梅隆大学等机构提出了 Aya,这是一个开放获取的指令微调多语言语言模型,覆盖 101 种语言,在语言覆盖范围扩大一倍的同时优于 mT0 和 BLOOMZ,并发布了覆盖 99 种语言的新评估套件,同时提供了关于微调数据混合构成、数据剪枝和安全性的详细分析。
核心贡献
-
本文提出了 Aya,这是一个开源的指令微调多语言语言模型,能够遵循 101 种语言的指令,其中包含 51 种资源较少语言;其训练数据由 2.03 亿样本的混合数据构成,其中英语占 21.5%;相比之下,xP3 覆盖 46 种语言、8100 万样本,其中英语占 39%。
-
本文构建了覆盖 99 种语言的多语言评估套件,涵盖判别式任务、生成式任务、基于 LLM-as-judge 的模拟胜率、人类评估和安全性测试。Aya 在判别式任务和生成式任务上分别比 mT0x 取得 13.1% 和 11.7% 的相对提升,并在七种语言上取得 77% 的人类偏好胜率。
-
本文研究数据加权和剪枝,以重新平衡许可宽松的学术风格多语言数据,基于人工标注移除 19.66% 的英语样本和 18.25% 的多语言样本,并为翻译数据、模板化数据和人工标注数据设置不同权重。本文还应用多语言安全上下文蒸馏,由人类专家判断,该方法可将对抗性提示下的有害生成减少 78% 到 89%,并在 18 种语言上评估毒性、社会偏见和性别偏见。
引言
作者聚焦于大语言模型的多语言指令微调。该能力使系统能够以不同语言响应用户请求,并且是让 AI 助手在全球范围内更易用和可及的关键。现有的开源指令遵循模型仍然高度英语中心化;73% 的流行指令微调数据集以英语为主,而现有多语言方法要么语言覆盖不足,要么仍然要求使用者使用英语提示。作者贡献了 Aya,一个开源指令微调模型。它将训练和评估扩展到 101 种语言,采用更均衡的 2.03 亿样本混合数据,其中英语仅占 21.5%,将多语言评估扩展到 99 种语言,并加入了面向安全的剪枝和蒸馏。
数据集
-
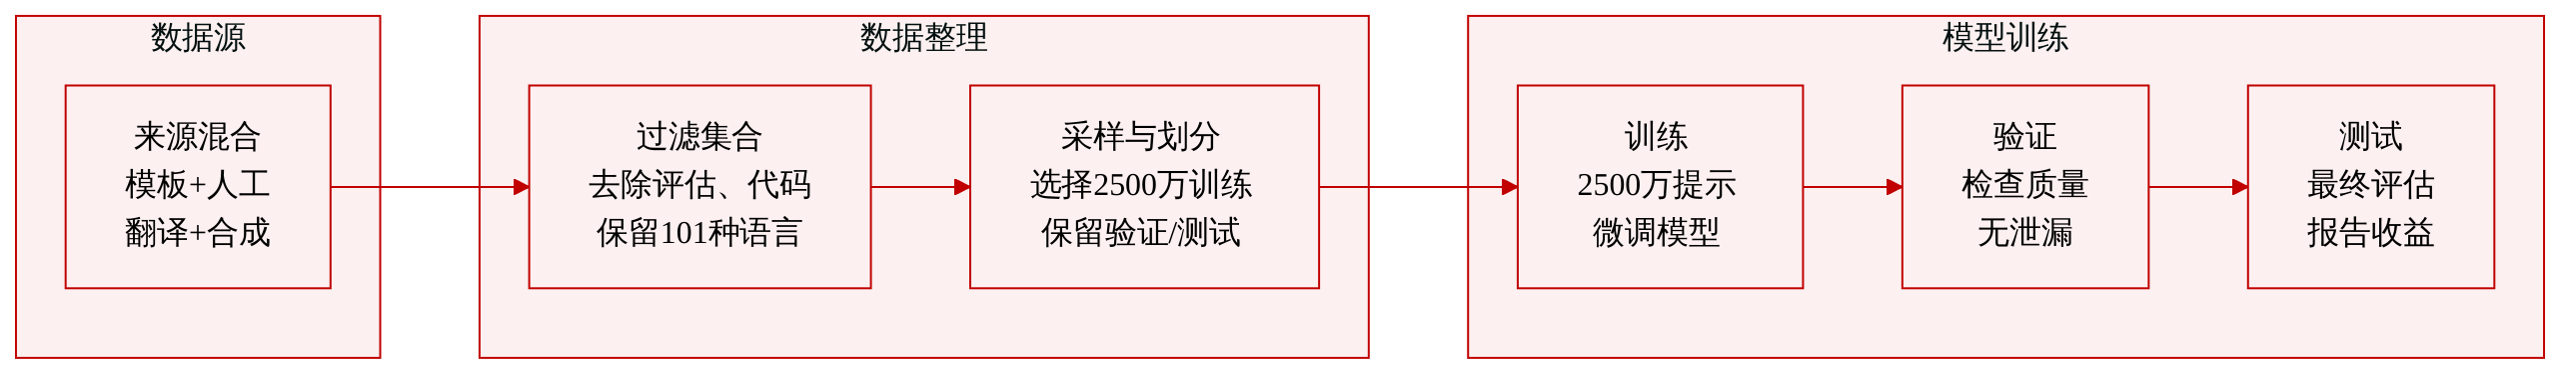
作者通过把现有数据集、人工标注、翻译和合成生成内容转换为指令与响应对,构建了多语言指令微调混合数据,主要关注 mT5 预训练使用的 101 种语言。
-
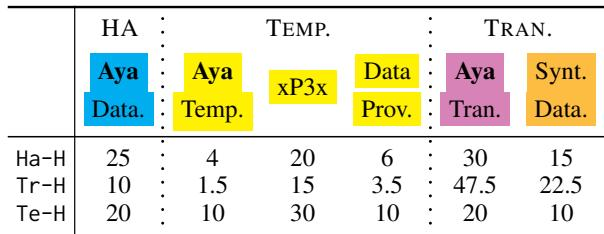
xP3x 是 xP3 的扩展版本,从覆盖 46 种语言和 13 项任务的 8600 万样本,扩展到覆盖 277 种语言和 16 项任务的 6.8 亿样本。对于训练,作者使用了限定在 101 种 mT5 语言上的子集,并将其剪枝为覆盖 101 种语言和 56 个数据集的 1.68 亿样本,以提升质量和生成长度。
-
Data Provenance Collection 使用过滤工具筛选出可公开访问、且许可证自述为商业可宽松使用的有监督指令数据集。它包括 OctoPack 清理过的 Open Assistant、Open Instruction Generalist、Flan Collection 的子集以及 Tasksource Instruct。过滤后,它包含 160 万个样本,其中 55 万个是 few-shot,其余是 zero-shot,覆盖 14 种语言和 161 个数据集。作者移除了源自评测基准或评测任务类别(如文本蕴含、共指消解和句子比较)的数据集,并排除代码数据,因为基础 mT5 模型没有使用代码进行预训练。
-
Aya Collection 的模板化部分来自一个更大的集合,包含 74 种语言下的 5.13 亿实例和模板。对于训练,作者将其过滤到 101 种目标语言,并去除评测污染,最终得到 51 种语言下的 1890 万个样本,按资源水平分为 21 种高资源语言、11 种中资源语言和 19 种低资源语言,并覆盖 34 个数据集。
-
Aya Dataset 提供由母语者编写的人工策划开放式提示和响应对。完整数据集包含 65 种语言下的 20.4 万个样本。限定到目标语言后,作者使用覆盖 64 种语言的 19.95 万个样本,包括 22 种高资源语言、12 种中资源语言和 30 种低资源语言。
-
翻译被用作数据增强,以扩大语言覆盖并改善跨语言泛化。作者使用 Aya collection 中 NLLB 对广泛使用的英语指令微调数据集进行的 101 种语言翻译。翻译优先级偏向任务多样性更丰富、生成长度更长的数据集,并且仅保留与 101 种 mT5 训练语言重叠的语言。
-
ShareGPT-Custom 是一个合成且经机器翻译的数据集,包含 93 种语言下的 680 万个样本。它把来自 ShareGPT 的人工标注提示与内部 LLM 生成的英语合成补全组合在一起。作者没有使用原始的 ShareGPT 补全,因为这些补全来自用户共享的 ChatGPT 对话,为遵守使用条款而被排除。提示会在生成和翻译之前被过滤。
-
在所有数据源中,合并数据池包含超过 2.03 亿实例,但数据量高度倾斜。人工标注数据特别小,只有 19.95 万个样本,约占总训练样本预算的 0.7%。
-
作者在合并数据池中按照 2500 万训练实例的固定预算进行采样。作者为主要数据源分配采样权重,以平衡任务和语言覆盖,然后将每个数据源的权重按比例分配到该数据源内部的不同数据集。消融实验设置包括偏重人工标注、偏重翻译和偏重模板。偏重人工标注会提高 Aya Dataset 的权重;偏重翻译会提高 Aya translations 和 ShareGPT-Custom 的权重;偏重模板会提高 Aya Collection 模板、xP3x 和 Data Provenance Collection 的权重。
方法
作者围绕一条多语言指令微调流水线构建方法,该流水线从人工策划提示出发,并将这些提示扩展为大规模机器翻译训练数据。作者首先从 ShareGPT 中提取人工标注提示,并移除原始合成补全。然后使用内部语言模型为这些提示生成英语补全。得到的提示补全对被机器翻译成多种语言,形成一个名为 ShareGPT Custom 的合成数据集,其中包含 93 种语言下的 680 万个样本。过滤同时应用于原始提示和翻译后的输出,因此训练混合数据来自受控数据生成和翻译,而不是直接复用用户对话。
经微调模型流水线以 mT5 为中心。mT5 是一个 130 亿参数的编码器-解码器 Transformer,在一万亿 tokens、跨越 101 种语言的自然语言文本上进行预训练。作者选择该模型,是因为它提供了异常广泛的语言覆盖,这对于指令微调阶段需要让 embedding 适配许多目标语言的情况非常重要。尽管较新的模型可能在其他方面更强,但这里的重点是降低对早期预训练阶段未包含的语言适配不佳的风险。
在微调阶段,mT5 模型使用 Adafactor 优化器进行训练。学习率设置为 3×10⁻⁴,批次大小为 256,并启用样本打包。训练运行 30000 步,对应约 2500 万训练样本的总预算。与此同时,作者还使用 Okapi 风格模型,将预训练的 BLOOM-7B 和 LLaMA-7B 模型在翻译提示与合成数据混合数据上微调,生成面向特定语言的变体。
实验
这些实验在一个广泛指令混合数据上微调大型多语言 mT5 模型,对人工标注、翻译和模板化数据的采样权重进行消融,并在未见判别式任务、一般知识评估、生成式任务、偏好研究和安全性测试中比较各变体与多语言基线。判别式任务的实验结果显示,尽管语言覆盖更广,一个均衡良好的指令混合数据仍能保持强劲的零样本性能;而偏重模板的加权在基准风格任务上最有效,并似乎受益于从英语开始的跨语言迁移。生成与偏好结果表明,偏重翻译的加权能产生更好的开放式回复和翻译质量,这表明基准准确率并不一定会转化为更受偏好的对话行为。安全性分析显示不同类型的危害并存,模型生成的毒性更低,但仍存在偏见并易受对抗性攻击,而安全蒸馏在较小的性能代价下显著减少了这些危害。
训练混合数据整合了许多多语言指令来源,这些来源在规模、语言覆盖、资源代表性以及序列长度上差异很大。由于人工标注数据相对于模板化、翻译和合成来源非常小,采样权重会强烈影响微调过程中涌现出哪些任务优势。平衡指令遵循能力需要对数据来源进行排序和优先级安排,以免某一种语言或某一种数据类型主导整个混合数据。模板化数据支持判别式任务,而翻译数据支持机器翻译以及更自然的开放式输出。过度提升小型人工标注数据集的权重可能降低平均性能,因为反复暴露于同一个小数据集会引发过拟合风险。
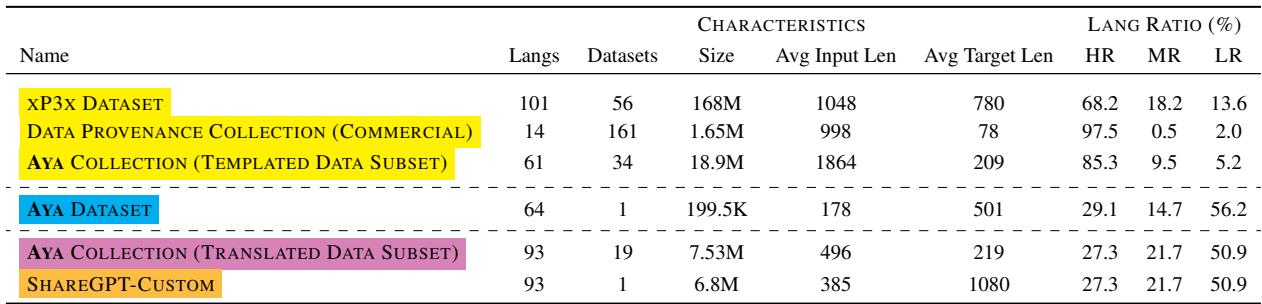
这些变体比较了如何把固定的微调预算分配到人工标注、模板化和翻译来源上。偏重翻译的加权更受青睐,因为它带来更强的生成和机器翻译表现;偏重模板的加权则通过更强的英语迁移提升判别式任务。偏重人工标注的加权整体表现较弱,可能是因为反复暴露于一个小数据集会导致过拟合。提升翻译数据的权重有助于开放式和翻译导向的性能。提升模板化数据的权重有利于判别式任务,尽管翻译变体中的英语占比更小。提升人工标注数据的权重会在这些方案中产生最低的平均性能。
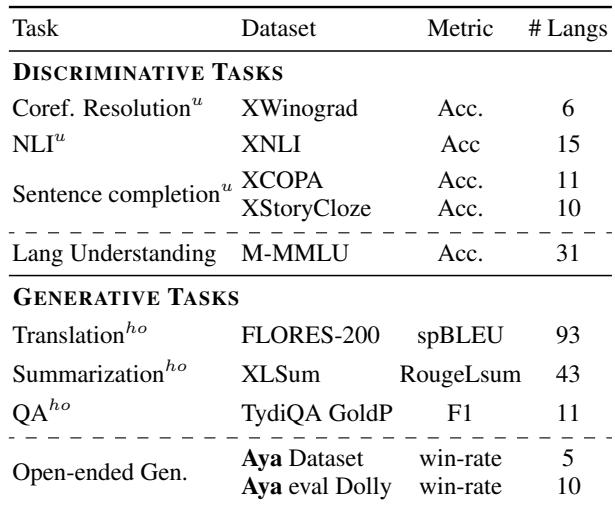
评估设置覆盖未见判别式任务、未见一般语言理解,以及带有留出评估划分的生成式任务。判别式基准通过多个语言和任务类别上的准确率来衡量;生成式任务包括翻译、摘要和问答。开放式生成使用人类偏好胜率和模拟偏好胜率来评估。判别式评估包括未见共指、自然语言推理、句子补全和故事完形填空任务。多语言 MMLU 被用作未见一般语言理解基准。生成式评估使用留出数据来评估翻译、摘要和问答。开放式输出通过人类评估胜率和 LLM 模拟胜率进行比较。翻译和开放式生成受益于强调翻译数据,而判别式任务受益于强调模板化数据。
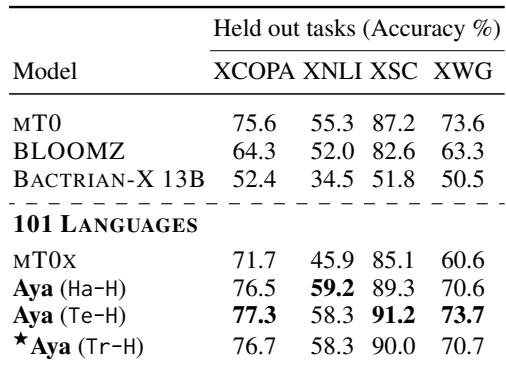
在未见多语言判别式任务上,Aya 取得了最强的平均留出准确率,同时覆盖的语言数量明显多于对比基线。结果表明,广泛且均衡的指令微调混合数据可以在扩大语言覆盖的同时保持性能。在留出判别式任务上,Aya 是综合最佳模型,相对于列出的基线在 XCOPA、XNLI 和 XStoryCloze 上取得提升。覆盖 101 种语言的 mT0x 设置落后于覆盖 46 种语言的 mT0 基线,这表明数据多样性和均衡采样比单纯语言数量更重要。
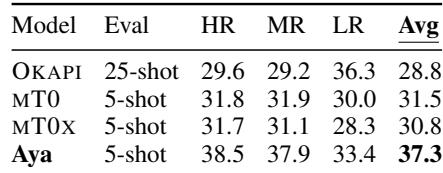
在多语言 MMLU 分数上,Aya 的整体平均表现最强,并在高资源和中资源类别上最高。MT0 和 MT0X 彼此接近,在平均表现上超过所报告的 Okapi 基线。Okapi 取得最佳低资源分数,但其低资源优势没有转化为有竞争力的整体结果。Aya 在平均多语言 MMLU 分数上领先。Okapi 在低资源性能上最强,但平均表现最弱。MT0 和 MT0X 结果相似,其中 MT0 在整体上略微领先。
这些实验评估了不同训练数据混合在多语言指令遵循上的影响,覆盖未见判别式任务、一般语言理解和生成式任务。实验结果表明,翻译数据有利于翻译和开放式生成;模板化数据有利于判别式任务和英语迁移;而过度提升小型人工标注数据的权重可能导致过拟合,并降低平均性能。比较还表明,广泛且均衡的覆盖比单纯语言数量更重要,更均衡的设置取得了最强的整体留出判别式和多语言 MMLU 性能。