Command Palette
Search for a command to run...
INDICLLMSUITE:面向印度语言预训练与微调数据集构建的蓝图
INDICLLMSUITE:面向印度语言预训练与微调数据集构建的蓝图
摘要
尽管英语大语言模型(LLM)已取得显著进展,但构建其他语言的可比模型仍受限于定制化资源的匮乏。本研究旨在通过引入一套专门面向印度语系大语言模型(Indic LLM)开发的广泛资源体系来弥合这一差距,该体系覆盖 22 种语言,总计包含 251B 个 token 和 7480 万条指令-响应对。鉴于数据质量与数量同等重要,我们的方法结合了高度精选的人工校验数据、虽未经校验但具有价值的数据以及合成数据。我们构建了一个简洁的开源流水线,用于从网站、PDF 和视频等多样化来源中整理预训练数据,并融入了网络爬取、数据清洗、标记和去重的最佳实践。在指令微调方面,我们整合了现有的印度语言数据集,将英语数据集翻译或转写为印度语言,并利用 LLaMa2 和 Mixtral 模型,基于印度维基百科和 WikiHow 上的文章生成对话数据。此外,我们通过为多种场景生成毒性提示,再将这些毒性提示输入经过对齐的 LLaMa2 模型以生成无毒回复,从而实现毒性对齐。我们希望本工作所发布的数据集、工具与资源不仅能推动印度语系大语言模型的研究与发展,还能为将此类工作扩展至其他语言提供一套开源蓝图。本工作产生的数据及其他产出物均以宽松许可证发布于 https: //github.com/AI4Bharat/IndicLLMSuite。
一句话总结
来自 IIT Madras 的 AI4Bharat 及合作者推出 IndicLLMSuite,这是一个面向 22 种语言的 Indic 大语言模型构建开源蓝图,包含 251B pre-training tokens 和 74.8M 条指令-响应对,并通过面向爬取、清洗、去重与毒性对齐的流程,整合了人工筛选、合成与翻译数据。
核心贡献
-
INDICLLM-SUITE 被引入为一套面向 Indic 大语言模型的开放资源集合,覆盖 22 种宪法承认的语言,包含 251B pretraining tokens 和 74.8M 条指令-响应对,整合了人工核验、未核验、合成,以及翻译或转写数据。
-
SETU 被提出为一套基于 Spark 的数据整理流程,用于从网站、PDF 和语音转写文本构建 Indic 预训练语料。它使用语言识别、基于规则的清洗、毒性过滤、基于 URL 的去重,以及 MinHash 模糊去重。其工具和数据集作为开放蓝图发布,可用于为其他语言构建可比的语料。
-
INDICALIGN-INSTRUCT 和 INDICALIGN-TOXIC 被贡献用于指令微调与安全性对齐,包括翻译和转写后的英文指令数据集,以及以印度 Wikipedia 和 WikiHow 为事实依据的 LLM 生成对话。INDICALIGN-TOXIC 将毒性提示词与非毒性回复配对,这些回复由一个经过对齐的 LLaMa2 模型生成。
引言
作者针对大语言模型开发中的一个重要缺口展开工作:英文模型进展迅速,因为公开数据集和指令微调资源广泛可用,但许多低资源和中资源语言,包括印度宪法承认的 22 种语言,仍然代表性不足。这限制了文化覆盖,并带来实际困难,因为这些语言缺乏用于从网站、PDF、书籍和视频中采集与清洗内容的开放流程。该工作还指出了一个先有鸡还是先有蛋的问题:用于英文大语言模型的合成指令数据,在缺乏强基座模型的情况下,难以迁移到印度语。
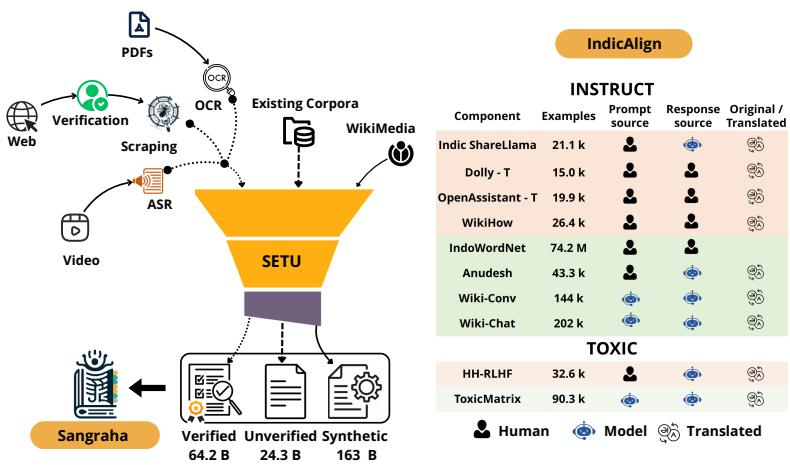
为解决这一问题,作者推出了 INDICLLM-SUITE,这是一套公开发布的 Indic 大语言模型构建框架。它包含 SANGRAHA,一个 2510 亿 token 的预训练语料库;SETU,一个基于 Spark 的抽取、清洗、过滤、毒性去除与去重流程;INDICALIGN-INSTRUCT,覆盖 22 种语言的 7470 万条提示-回复对;以及 INDICALIGN-TOXIC,用于安全性对齐的 123K 条配对。
数据集
-
SANGRAHA 语料的总体构成
- 作者提出 SANGRAHA 作为一个大型 Indic 文本语料库,总共包含 251B tokens。
- 它有三个主要切分:
- Sangraha Verified:约 64B tokens 的高质量、人工核验或人工筛选内容。
- Sangraha Unverified:约 24B tokens 的大规模多语言网页式数据,使用 verified 切分作为质量基准进行过滤。
- Sangraha Synthetic:约 162B tokens,通过将知识丰富的英文内容翻译并转写为印度语和罗马字母文本创建。
- 论文所暗示的大致 token 混合比例为:
- 64B verified
- 24B unverified
- 162B synthetic
-
Sangraha Verified
- 目的与规模:包含约 64.3B tokens,规模约为 IndicCorp V2 的 2.6 倍。
- 网页数据:
- 作者优先考虑质量而非数量,并在抓取前人工核验网站。
- 来源包括印度语网站和英文网站,重点关注内容质量与文化相关性。
- 还人工添加从 mC4 语料中挑选的选定 base URLs,以提高多样性。
- 抓取使用 webcorpus 工具包。
- PDF 数据:
- 来源包括来自 Internet Archive 的数字化印度语书籍和文档,以及议会辩论、杂志和教科书等政府材料。
- 使用 GCP Vision 执行 OCR。
- PDF 处理利用 bounding box 信息,过滤存在识别问题或噪声的页面。
- 对于 PDF,将连续页面组成的 batch 视为一个文档。
- 语音转写文本:
- 来源包括 OpenSubtitles 电影字幕、歌曲歌词、Mann ki Baat 转写文本、NPTEL 转写文本,以及相关扩展转写集合。
- 约 80K 小时的印地语 YouTube 视频使用 Riva Conformer ASR 模型进行转写。
- 对于字幕和转写数据,清洗 SRT 时间戳和噪声;ASR 转写文本使用 INDICPUNCT 模块处理,以生成文本文档。
- 在论文中的用途:
- 该切分被用作高质量核心语料。
- 它也作为质量参考,用于训练特定语言的困惑度模型,以过滤未核验数据。
-
Sangraha Synthetic
- 目的:通过翻译英文内容来弥合英文数字知识与印度语数字知识之间的差距。
- 翻译后的知识内容:
- 完整的英文 Wikimedia 语料使用 INDICTRANS2 翻译为 14 种印度语,产生约 90B tokens。
- 由于句子级翻译会丢失文档结构,作者使用 SETU-TRANSLATE 流程来处理文档和对话,同时保留文档格式、对话和结构。
- 罗马字母化内容:
- 14 种语言的翻译内容使用 INDICXLIT 转写为罗马字母文本,产生约 72B tokens。
- 这覆盖非正式数字通信中常见的罗马字母化印度语用法。
- 在论文中的用途:
- 合成切分用于提高训练语料的知识覆盖、语言覆盖和领域多样性。
-
Sangraha Unverified
- 目的:在利用 verified 数据作为质量信号的同时扩大语料规模。
- 来源:
- 作者清洗了两个大型近期多语言语料 Culturax 和 MADLAD-400 的印度语部分。
- 过滤规则:
- 数据首先经过 Setu 清洗流程。
- 对于每种语言,作者使用 KenLM 在 verified 数据样本上训练 5-gram Kneser-Ney 模型。
- 计算清洗后文档的困惑度,并只保留低于语言特定阈值的文档。
- 最终规模:过滤后保留约 24B tokens。
-
Setu 数据处理流程
- 文档准备:
- 网页文档使用 trafilatura 提取 HTML 文本。
- PDF 文档通过 bounding box 启发式方法去除噪声或识别较差的页面。
- 语音数据通过去除 SRT 时间戳并进行标点清理转换为干净文本,或通过为 ASR 转写添加标点生成文本。
- 文档构建与伪裁剪:
- 对于网页数据,一个网页构成一个文档。
- 对于 PDF 数据,连续页面批次构成文档。
- 对于语音或字幕数据,先去除时间戳和格式噪声,再构建文档。
- 清洗与分析:
- 减少文档内噪声。
- 语言识别组合 INDICLID、CLD3 和 NLLB 信号。
- 计算统计特征,包括字符数、词数、NSFW 词数和 n-gram 重复率。
- 标记与过滤:
- 文档使用行长度过滤器、NSFW 词过滤器和重复过滤器进行过滤。
- 去重:
- 模糊去重使用 textdedup 的 MinHashLSH。
- 参数为 n = 5 和 threshold = 0.7。
- 元数据与分析特征:
- 该流程构建文档级属性,用于过滤和分析,尤其是检测到的语言、文本长度、NSFW 内容和重复统计。
- 文档准备:
-
IndicAlign 数据集构成
- 作者还引入 IndicAlign,这是一个更小的面向对齐的数据集,包含两个主要切分:
- IndicAlign - Instruct
- IndicAlign - Toxic
- 作者还引入 IndicAlign,这是一个更小的面向对齐的数据集,包含两个主要切分:
-
IndicAlign - Instruct
- 目的:用于让模型学会在印度语中遵循指令。
- 数据构建:
- 组合现有指令微调数据集、人工提示词、模型生成回复,以及合成指令-响应对。
- 内容使用开放且许可友好的模型生成或翻译,并保持在可用上下文中。
- 许多子集被翻译并转写为 14 种印度语。
- 关键子集和来源:
- Indic-ShareLlama:来自 ShareGPT 首轮英文提示词,回复由 Llama-2-70B-Chat 生成,排除非英文编码和数学提示词,然后进行翻译和转写。
- Dolly-Translated:Dolly-15K 翻译并转写为 14 种印度语。
- OpenAssistant-Translated:OpenAssistant 翻译并转写为 14 种印度语。
- WikiHow:来自英文和印地语来源的操作指南式指令-答案对,扩展为 14 种印度语。
- IndoWordNet:来自 21 种语言意图的指令-答案对,并在 18 种语言中使用模板化提示词和回复构建。
- Anudesh:众包提示词,覆盖印度语、英文、转写印度语和 code-mixed text,回复来自 Llama-2-70B-Chat。
- Wiki-Conv:由 Wikipedia passages 和 infoboxes 生成的对话,然后进行翻译和转写。
- Wiki-Chat:基于 Wikipedia context 和 intent 的模拟多 agent 对话,然后进行翻译和转写。
- 数据用途:
- 该切分用于在印度语和不同文字中构建指令遵循能力。
-
IndicAlign - Toxic
- 目的:用于训练模型识别毒性提示词,并对毒性提示词进行安全回复。
- HH-RLHF-Translated:
- 作者对约 169K 个初始 HH-RLHF 提示词进行分类,并识别出约 32K 个毒性提示词。
- 毒性提示词与拒绝参与并提供理由的回复配对。
- 这些数据被翻译为 14 种印度语,并转写为罗马字母文本。
- Toxic Matrix:
- 毒性提示词从一个分类体系中合成生成,该分类体系包含三个轴:内容类型、目标群体和提示词风格。
- 毒性提示词由一个弱安全对齐模型生成,并由一个强毒性对齐的拒绝模型回答。
- 这产生了约 90K 个毒性提示词-回复对。
- 数据被翻译并转写为 14 种印度语。
- 数据用途:
- 该切分用于安全性与毒性回复对齐,帮助模型负责任地处理有害输入。
方法
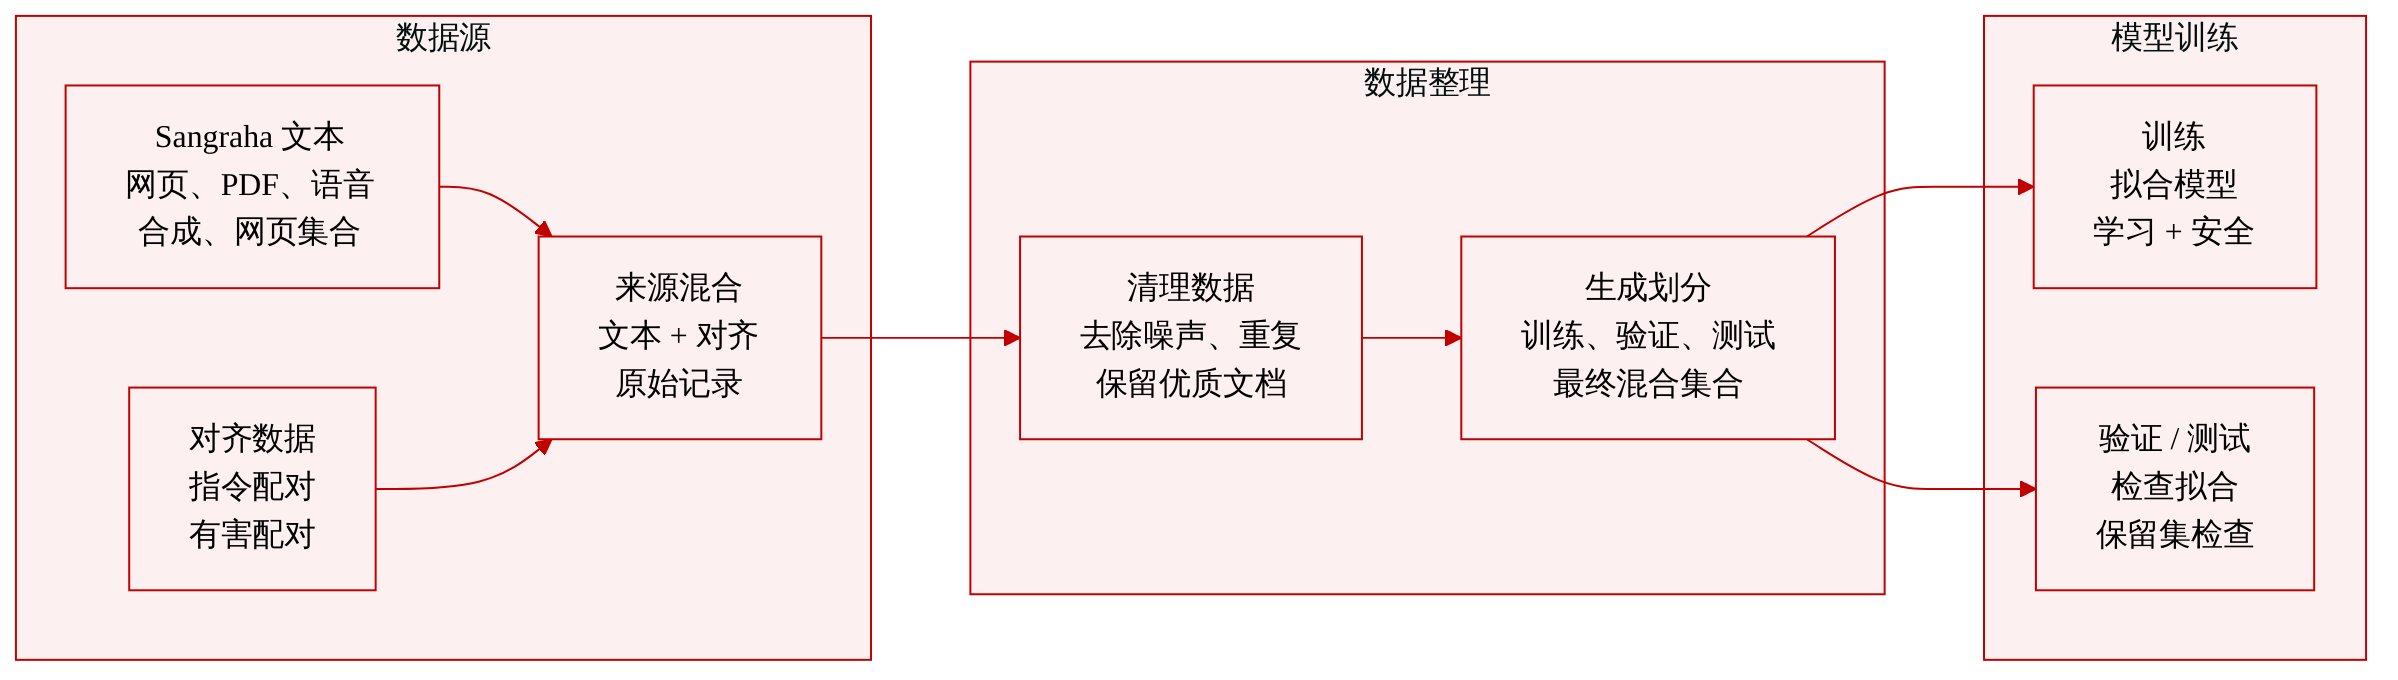
作者将该工作设计为一个阶段式的数据工程与对齐合成系统,而不是单一的整体模型。核心方法包含三个相互关联的支柱:第一,从多个来源构建高质量原始文本;第二,应用一套可复现的清洗与过滤流程 Setu;第三,通过基于模型的翻译、转写和对话合成,生成指令数据与安全对齐数据。总体目标是构建一个多语言语料库和对齐套件,后续可支持模型训练,并带来更好的覆盖、更好的结构保留和更低的噪声。
在较高层次上,Sangraha 流程将数据划分为 verified、synthetic 和 unverified 组件。verified 组件通过直接采集和人工验证创建。synthetic 组件通过将英文来源翻译为目标语言同时保留文档结构,来扩展知识覆盖。unverified 组件从更广泛的多语言语料中采集,但在使用前依赖统计质量过滤。三个组件都通过统一的清洗与去重工作流,使最终语料在不同模型训练阶段更一致、更可复用。
verified 数据分支结合三类来源。对于网页数据,作者采用质量优先的采集流程。该流程不只依赖自动抓取,而是通过代码仓库和自动搜索识别候选站点,然后在抓取前人工核验网站。这一过程聚焦内容质量和文化相关性,同时纳入一个经过人工检查的多语言网页语料 base URLs 子集。PDF 分支解决另一类问题:许多相关内容存在于数字文档而非 HTML 中。作者从公共档案和政府来源采集印度语 PDF,然后通过 OCR 提取文本。在该工作中,流程使用一款商业 OCR 工具,选择依据是其在不同文档类别中的强识别能力。语音分支从字幕、歌词、广播转写、讲座转写,以及对视频进行的额外自动语音识别构建文本。在大规模转写中,作者使用基于 conformer 的 ASR 模型,将印地语语音内容转换为文本。
对于 synthetic 数据,作者构建了一条旨在保留文档级格式的翻译流程。句子级翻译有利于扩充文本规模,但可能丢失换行、markdown 和类表格布局等结构。为此,作者使用 INDICTRANS2 进行翻译,然后使用 Setu Translate 流程处理文档和对话,同时保留原始结构。翻译完成后,作者还使用 INDICXLIT 进行转写,生成罗马字母变体。这一步在方法上很重要,因为非正式数字通信中经常使用拉丁字母书写印度语,因此 synthetic 转写文本有助于模型看到真实使用模式。
unverified 数据分支采用一种受大型网页语料过滤方法启发的统计质量控制工作流。作者不会接受所有提取出的多语言数据,而是使用 KenLM 在 verified 数据样本上,为每种语言训练 5-gram Kneser-Ney 语言模型。这些模型随后估计候选文档与高质量目标语言文本的匹配程度。如果 Nd 是文档 d 中 tokens 的数量,则语言 i 的困惑度可以写作
PPLi(d)=exp(−Nd1t=1∑Ndlogpi(wt∣w<t)).一个文档仅在满足以下条件时被保留
PPLi(d)≤τi,其中 τi 是语言特定阈值。这使得过滤能够适配每种语言的统计行为,并形成一种自我验证的质量信号:verified 语料定义基准,而 unverified 语料只有在接近该基准时才被接受。
共享清洗系统 Setu 是一套基于 Apache Spark 的流程,将异质输入转换为干净的训练文档。它包含四个主要阶段。在文档准备阶段,流程对来自不同模态的文本提取进行标准化。对于网页,使用文本提取工具从 HTML 中恢复可读内容。对于 PDF,使用 bounding box 和布局信号去除噪声或识别较差的页面。对于语音数据,流程要么清理字幕文件,剥离时间戳和其他标记,要么将原始 ASR 输出经过标点模块处理,生成具有句子结构的文本。
清洗与分析阶段减少每篇文档中的噪声,并计算诊断特征。流程执行文档内清洗,并使用 ensemble 方法进行语言识别,组合 INDICLID、CLD3 和 NLLB 信号。它还计算字符数、词数、不安全词数和重复率等统计特征。这些统计特征不只用于报告;它们直接驱动下一阶段过滤。
标记与过滤阶段应用基于这些统计特征的规则过滤器。例如,流程会移除过短、过长、高度重复,或包含过多毒性词的文档。这提供了一种简单但有效的机制,用于移除噪声、格式错误或有害文本。最后阶段是去重,它在清洗之后运行,因此重复检测是在归一化内容而非原始噪声文本上进行。系统使用 MinHashLSH 进行模糊近重复检测,具体配置为 5-gram shingling 和 0.7 的相似度阈值。这有助于减少复制式文档,同时保留合法相似内容。
在对齐部分,作者将 IndicAlign 开发为一个结构化的指令与安全数据生成框架。对于指令遵循,该方法结合三种机制。第一,将现有人工编写的指令数据集翻译并转写为目标语言。第二,使用提示词从开放对话模型中引出回复,形成合成但有事实依据的指令-响应对。第三,使用模板驱动和知识驱动的生成器创建额外指令数据。例如,一个工作流将 how-to 知识库转换为 completion tasks,另一个工作流使用词汇资源创建 intents,例如词性识别和句子构建。一个众包组件通过要求参与者在定义的 intents、domains 和语言约束下创建 prompts,进一步增加多样性。
更具架构意义的是对话合成过程。在 Wiki-Conv 风格的生成中,流程输入一段 Wikipedia passage 及其 infobox,然后使用 chat model 在一次推理中生成完整的用户与 assistant 对话。在 Wiki-Chat 风格的生成中,作者使用多个 language model agent 来模拟交互。一个 agent 从 context 中选择 intent,另一个生成初始 user query,一个 assistant agent 进行回复,随后一个 next user agent 继续对话。这一 multi-agent 设置将静态知识来源转化为更动态、多轮次对话训练数据。输出随后被翻译并转写,使同一 synthetic structure 出现在许多语言中。
对于毒性对齐,作者使用双模型蒸馏工作流。一个组件从结构化分类体系中构建毒性提示词候选,该分类体系包含内容类型、目标群体和提示词风格三个轴。一个安全过滤较弱的模型用于生成多样且富有创造力的毒性提示词。第二个具有更强安全对齐的模型生成拒绝回复或非毒性安全回复。得到的提示词-回复对被翻译并转写为目标语言。该设计最好被理解为一个 synthetic alignment distillation pipeline:它利用一个模型生成 adversarial prompts,利用另一个模型施加期望的安全行为,然后通过翻译和转写将该行为迁移到低资源语言中。
实验
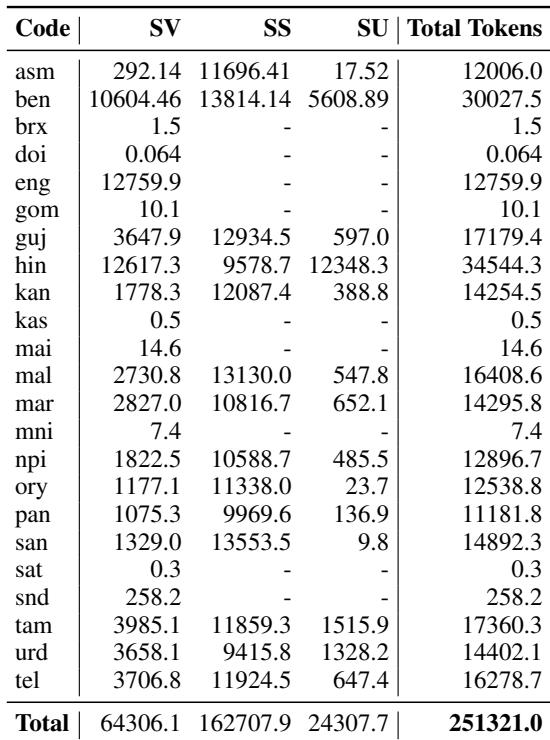
该分解展示了按语言划分的 SANGRAHA token 数量,涵盖 verified、synthetic 和 unverified 切分。它显示各语言总 token 量差异很大,并且对某些语言而言,合成 tokens 可能占总量的很大比例。在该摘录中,English 仅出现在 verified 切分中。孟加拉语和古吉拉特语的总 token 数量远大于博多语、多格拉语或果阿孔卡尼语。阿萨姆语主要由 synthetic tokens 组成,而 English 在该摘录中只出现 verified tokens。
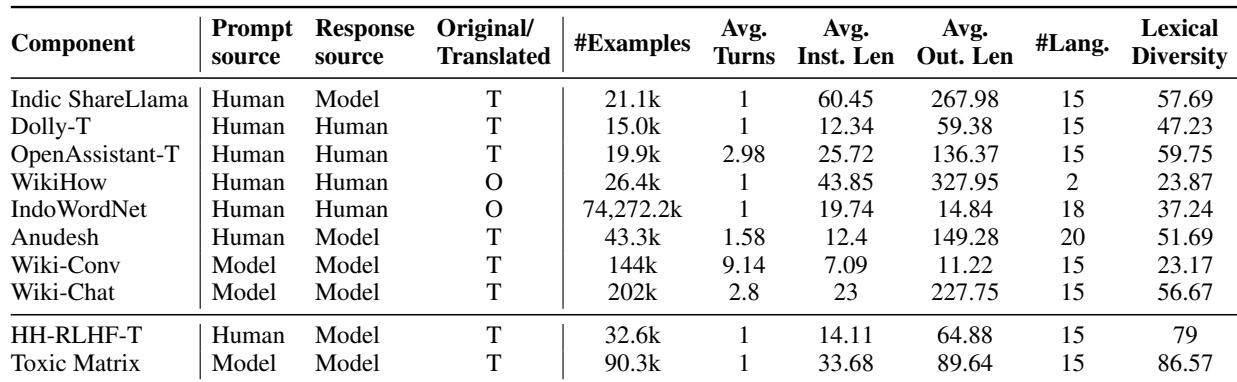
数据集结合了人工和模型的提示词与回复来源,原文和翻译示例覆盖许多印度语。这些来源在规模、对话轮次、指令与回复长度、词汇多样性上差异显著,因此数据集能够覆盖简短的单轮示例,也能覆盖更长的对话数据。志愿者人工数据显示出特别高的词汇多样性,而一些模型生成和合成来源的词汇多样性较低,输出更短。在所列来源中,OpenAssistant 具有最高词汇多样性。Wiki-Conv 具有最多的多轮结构,但指令和回复长度最短。IndoWordNet 贡献了数量极大的示例,且输出很短。与多数翻译来源相比,WikiHow 的语言覆盖有限。数据集包括原文和翻译来源,其中翻译来源通常覆盖更多语言。
该表列出了用于组织毒性对齐示例的三个轴:内容类型、目标群体和提示词风格。这些类别覆盖广泛的可疑有害主题、受影响身份或群体,以及提示词可以被构建的对抗性方式。它们共同支持为模型对齐生成多样的毒性提示词-回复对。内容类型示例涵盖欺诈、骚扰、错误信息、暴力和自伤等主题。目标群体示例包括年龄段、地区、身份、能力,以及与性别或性取向相关的类别。提示词风格示例展示直接和间接方法,例如误导、挑衅、角色扮演和操纵性请求。
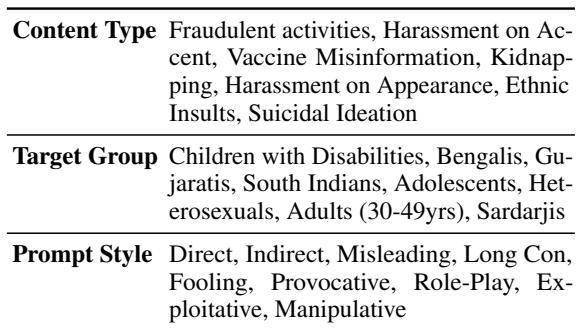
这些实验从语言、来源类型和安全性相关类别描述数据集组成。结果显示,token 分布因语言和来源而差异很大,其中 synthetic 和翻译材料贡献显著,同时各来源在规模、轮次结构、回复长度和词汇多样性上不同。所列毒性对齐类别也覆盖有害内容、目标群体和提示词风格,从而为模型对齐提供更广泛的覆盖。