Command Palette
Search for a command to run...
模拟去对齐:大语言模型的安全对齐可能适得其反!
模拟去对齐:大语言模型的安全对齐可能适得其反!
Zhanhui Zhou Jie Liu Zhichen Dong Jiaheng Liu Chao Yang Wanli Ouyang Yu Qiao
摘要
大语言模型(LLM)经过安全对齐以确保与人类进行安全对话。然而,本文提出了一种免训练攻击方法,仅通过访问 LLM 输出 token 分布即可逆转安全对齐效果,将更强的对齐结果转化为更大的潜在危害。具体而言,我们的方法通过对比经过安全对齐的语言模型(如 Llama-2-chat)与其预训练版本(如 Llama-2)的输出 token 分布,使 token 预测朝着安全对齐的相反方向偏移,从而实现这一逆转。我们将该方法命名为模拟去对齐(ED),因为从该对比分布中采样可以被证明模拟了以最小化安全奖励为目标进行微调的结果。我们在三个评估数据集和四个模型系列(Llama-1、Llama-2、Mistral 和 Alpaca)上对 ED 进行了实验,结果表明 ED 将预训练模型的有害性提升了一倍,并显著优于强基线方法,在 48 个评估子集中的 43 个取得了最高的有害率。最后,鉴于 ED 依赖于语言模型的输出 token 分布,这对开源模型尤其构成威胁,我们的研究结果凸显了重新评估语言模型开放可访问性的必要性,即使这些模型已经过安全对齐。代码可在 https://github.com/ZHZisZZ/emulated-disalignment 获取。
一句话总结
上海人工智能实验室提出了 Emulated Disalignment(模拟去对齐,ED),这是一种无需训练的攻击,它通过对比经安全对齐的模型与其预训练版本之间的输出 token 分布,来逆转安全对齐。该攻击可以被证明会模拟最小化安全奖励的微调,并在四个模型家族(Llama-1、Llama-2、Mistral 和 Alpaca)上将危害性提升一倍,同时凸显了开放访问的安全对齐大语言模型所带来的安全风险。
核心贡献
-
Emulated Disalignment(模拟去对齐)被提出为一种无需训练、在推理阶段运行的攻击方法。它通过对比经安全对齐模型(例如 Llama-2-chat)与预训练对应模型(例如 Llama-2)的输出 token 分布,并从所得到的偏移分布中采样,来逆转安全对齐。该攻击只需要访问输出 token 分布,不需要模型权重或额外微调。
-
该方法源自模拟微调,它将经对齐模型与其预训练模型之间的对数概率比解释为一个推断得到的安全奖励。它使用反向映射来构建一种对抗采样程序,该程序被证明能够模拟最小化安全奖励的微调。
-
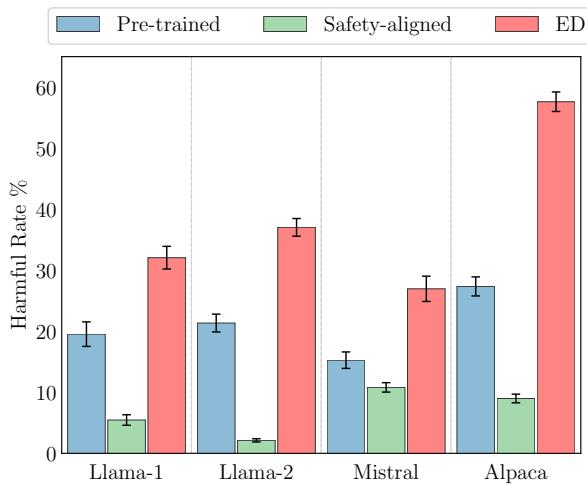
在三个数据集和四个模型家族(Llama-1、Llama-2、Mistral 和 Alpaca)上进行的评估表明,该攻击使预训练模型的危害性翻倍,表现优于强基线,并在 48 个评估子集中的 43 个取得了最高的有害率。
引言
大型语言模型越来越多地用于驱动聊天助手,因此安全对齐在防止有害输出的同时保留有用性方面至关重要。先前工作表明安全护栏较为脆弱,但许多攻击仍然依赖对抗提示、额外微调或访问模型权重,从而限制了其影响范围,并使关于推理阶段利用的问题仍未得到充分回答。
作者通过提出 Emulated Disalignment 来弥补这一缺口。它是一种无需训练的攻击,在推理阶段通过将经安全对齐的模型与其预训练基座进行对比,来逆转安全对齐。其洞见在于,经对齐模型与基座模型之间的对数似然差异可以充当安全奖励,而从对比分布中采样可以在不微调的情况下模拟对抗性去对齐。
在经验结果上,该方法相比预训练模型将危害性提升一倍,并在多个数据集和模型家族上表现优于强基线。这引发了一个现实担忧:当输出分布可访问时,即便经过安全对齐的开源模型也可能促成有害生成。
方法
Emulated Disalignment(模拟去对齐)
作者将 Emulated Disalignment 提出为一种无需训练的对抗解码框架。该方法假设可以访问一对语言模型:经安全对齐的模型 πalign 和预训练基座模型 πbase。由这一对模型,方法推导出一个类似奖励的信号,以反映安全对齐的影响。该奖励通过反向工程得到:
ralign(x,y)=logπalign(y∣x)−logπbase(y∣x),其中 x 是提示,y 是响应。如果 πalign 已被调优为偏好更安全、更有帮助的输出,那么该差异近似充当安全奖励:它为经对齐模型偏好的输出赋予更高值,并为它不喜欢的输出赋予更低值。
作者通过比较被偏好的安全响应、不被偏好的有害响应,以及与查询主题无关的有害响应的奖励值,来实证检验这一解释。如下图所示:
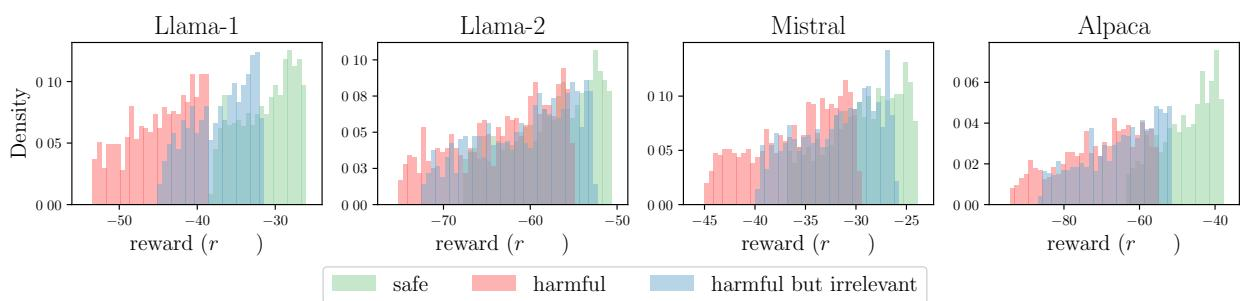
这些分布表明,反向工程得到的信号一致地将安全的被偏好响应放在更高的奖励值上,而有害响应(尤其是与有害查询直接相关的响应)获得更低的值。这支持了这样的论断:经对齐模型与基座模型对数概率之间的差异捕捉到了与安全性相关的偏好结构。
随后,该对抗目标通过反转通常的对齐目标来定义。作者不最大化安全奖励,而是在来自基座模型的 KL 约束下引入一个最小化该奖励的去对齐目标:
πdisalign=πargmax Ex∼p(x), y∼π(y∣x)[−αralign(x,y)−DKL(π(y∣x)∥πbase(y∣x))],其中 α 控制相对于 KL 约束的对抗强度。该目标通过降低安全奖励,同时防止策略偏离基座模型过远,使模型朝与安全对齐相反的方向移动。
该方法没有通过强化学习或额外微调来求解这一优化问题,而是利用奖励与模型之间的对偶性。将反向工程得到的奖励代入封闭式 KL 正则化解,可得到一个序列级分布:
πdisalign(y∣x)∝πbase(y∣x)exp(−αralign(x,y))=πalign(y∣x)απbase(y∣x)α+1.该表达式表明,去对齐分布可以直接由两个可用模型写出。然而,封闭式解是序列级的,因此不能直接兼容自回归生成。作者使用逐 token 分布对其进行近似:
πemulated-disalign(yt∣x,y<t)∝πalign(yt∣x,y<t)απbase(yt∣x,y<t)α+1.在每个生成步骤中,方法组合基座模型和经安全对齐模型的下一个 token 概率。相对于经对齐模型,基座模型认为更可能的 token 会获得更高的概率质量。这会产生一个不更新模型参数的对抗解码分布。
该方法也可以解释为对比解码。它会放大在预训练模型中更常见、但被安全对齐抑制的倾向。该方法的实际部署依赖于访问完整的输出 token 分布以及两个模型之间的兼容性,例如共享词表,因此最自然地适用于来自同一模型家族或同一模型家族组的开源模型对。
实验
实验在多个开源模型家族和危害性数据集上评估 ED,并将其与基线进行比较,以表明将经安全对齐的模型与经过恶意提示的预训练模型配对,能够有效诱发有害响应,尤其是针对安全查询和有害查询。对解码权重的分析揭示了一种权衡:中等数值会提高危害性,但过大的数值会降低危害性;与此同时,少样本提示、跨家族配对以及更大模型规模仍然可行。与直接去对齐模型的合成对比表明,更强的安全对齐会增加对 ED 的脆弱性,且模拟去对齐有时能够接近或超过直接去对齐,尽管高度对齐的模型可能需要更小的权重,而在极端情况下直接去对齐可能仍然更稳健。
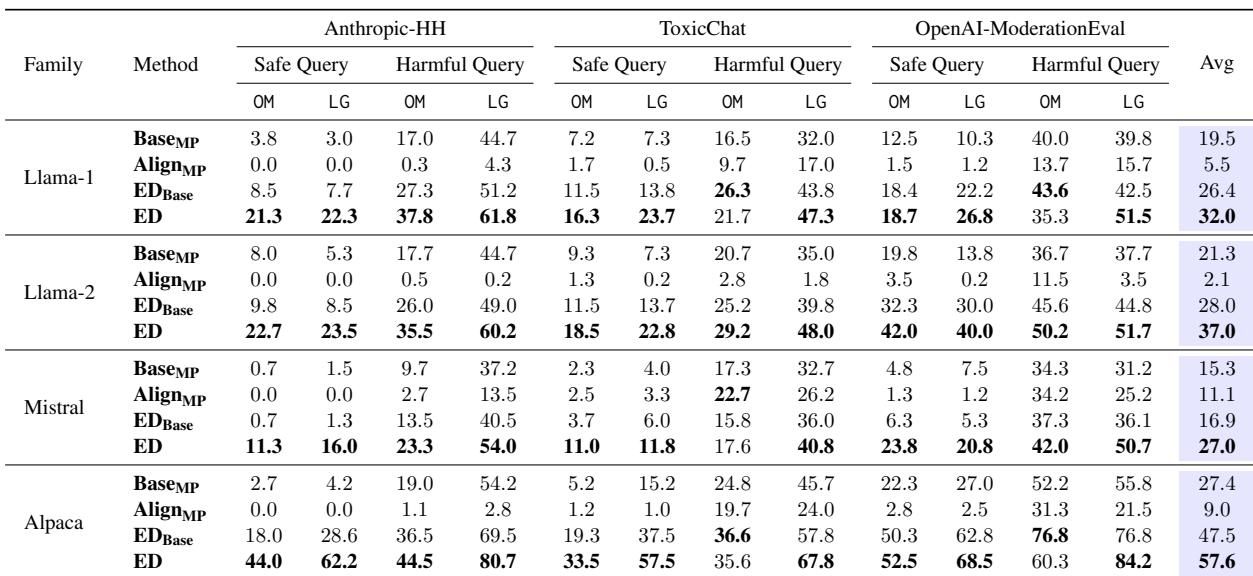
结果表明,模拟去对齐通常会在不同模型家族、数据集和评估指标上提高语言模型响应的有害率,并且相对于安全对齐基线获得最强提升。ED 与 ED_Base 之间的差距表明,从经安全对齐的模型出发对于产生有害输出非常重要,而高级提示可以进一步提高危害程度。危害性还取决于去对齐强度:在更强的设置下,效应先增加后减少。在大多数评估设置中,ED 产生比 Base_MP、Align_MP 和 ED_Base 更高的有害率。在 ED 下,有害查询响应远比安全查询响应更有害。增加 alpha 最初会提高有害率,随后在更强设置下会降低有害率。
在评估所用的解码强度下,对于基于 Llama 的模型对,模拟去对齐在安全查询和有害查询平均后会产生有害响应。对于共享词表的跨家族配对,该攻击仍然有效,但有效性因配对而异,并且对于同家族基座与经对齐模型配对通常更高。当模型对共享共同词表时,ED 可以针对来自不同家族的模型对。同家族配对通常强于跨家族配对,尽管跨家族结果仍然值得关注。有害率的强弱取决于基座模型和经对齐模型,涉及 Alpaca 和 Llama-2 的配对比若干 Llama-1 组合产生更高的危害性。
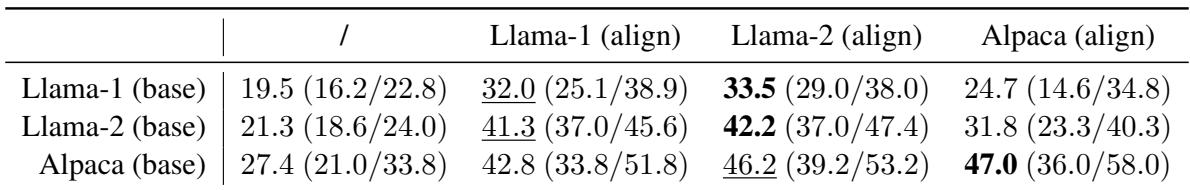
实验在多个模型家族、数据集和指标上评估模拟去对齐,结果表明相对于安全对齐基线,它通常提高了有害响应率。实验还考察了去对齐强度和模型配对如何影响有效性,发现危害性随 alpha 增加而上升,随后下降;从经安全对齐的模型出发时最强;在共享词表的同家族配对中更明显。当词表重叠时,跨家族攻击仍然可以奏效,尽管危害性会因基座模型和经对齐模型而不同。