Command Palette
Search for a command to run...
面向数据标注的高效统计质量估计方法
面向数据标注的高效统计质量估计方法
Jan-Christoph Klie Juan Haladjian Marc Kirchner Rahul Nair
摘要
标注数据集是训练、评估、比较和部署监督式机器学习模型的重要基础,因此确保标注质量至关重要。在标注过程中,需要良好的质量管理以及可靠的质量估计,以便在质量不足时及时采取改进措施。质量估计通常由专家对样本实例进行正确或错误的人工判定来完成,但检查所有标注实例往往成本高昂。因此,实践中通常仅对子集进行检查;子集大小的选取大多缺乏依据,未考虑统计功效,且往往相对较小。然而,基于小样本的估计会导致错误率估计值不够精确。使用不必要的大样本则会浪费本可用于更多标注工作的经费。因此,我们首先详细阐述了如何利用置信区间确定估计标注错误率所需的最小样本量,随后提出将验收抽样作为错误率估计的替代方案。结果表明,验收抽样可在保持相同统计保证的前提下,将所需样本量最多减少 50%。
一句话总结
达姆施塔特工业大学的 UKP Lab 与 Apple 描述了如何使用置信区间确定估计标注错误率所需的最小样本量,并提出将验收抽样作为替代方案,在保持等效统计保证的同时将所需样本量最多减少 50%。
核心贡献
-
置信区间用于确定在所需置信水平和精度下估计标注错误率所需的最小样本量,以替代临时的样本量选择。
-
将制造领域的验收抽样应用于标注项目,使检查人员能够决定接受或拒收批次,而不是始终直接估计完整错误率。
-
对两种置信水平和检验功效配置下的平均样本量进行分析表明,验收抽样,特别是具有截尾的序贯抽样,可在保持统计保证的同时将所需检查量最多减少 50%。
引言
作者利用置信区间和验收抽样,使数据标注质量估计更具统计学依据。大规模标注数据集对于训练和验证机器学习模型至关重要,但人工检查标注质量成本高昂,而且先前的工作往往依赖一致性指标或临时小样本,可能产生不可靠或过度乐观的错误估计。本文提出了一个用于估计标注错误率的统计框架,表明较紧的置信界可能需要令人意外地大的样本量,并提出将制造领域的验收抽样作为接受或拒收方法,在需要检查的样本示例最多减少 50% 的情况下提供类似保证。作者还提供了 Python 包,以便在标注工作流中应用这些方法。
数据集
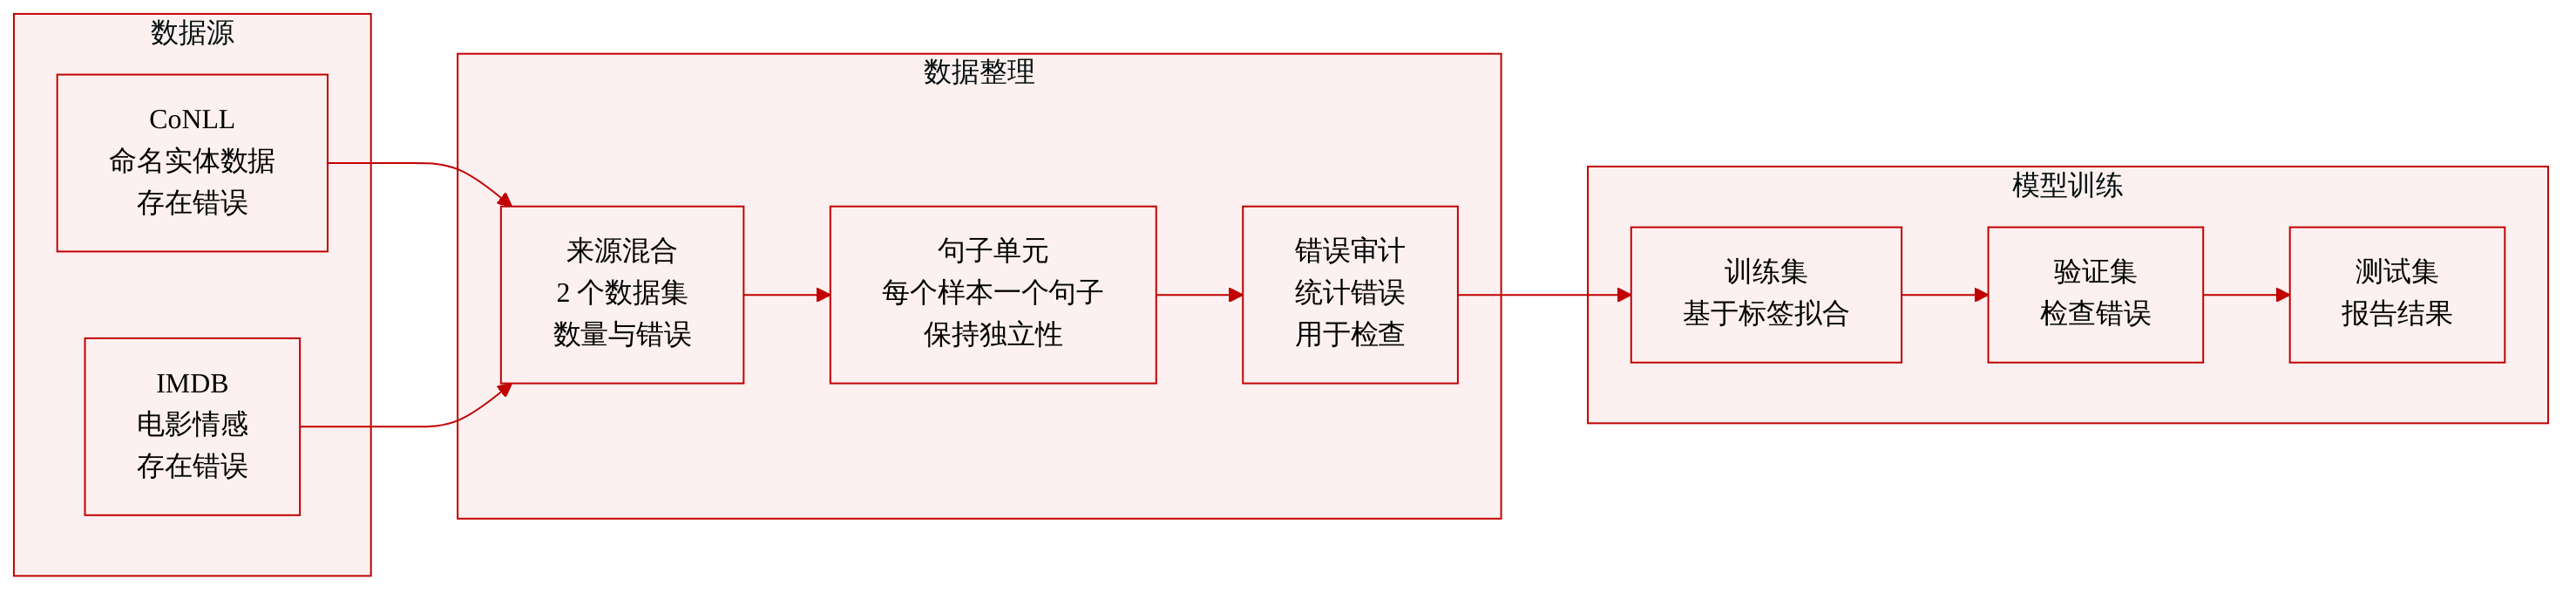
- 作者在两个已知包含不可忽略标注错误的真实数据集上评估验收抽样:CoNLL 2003 和 IMDB。
- CoNLL 2003 是由 Tjong Kim Sang 和 De Meulder(2003)提出的命名实体识别数据集,其标注错误由 Reiss 等人(2020)分析。
- IMDB 是由 Maas 等人(2011)提出的句子级情感分类数据集,其标注错误由 Northcutt 等人(2021)分析。
- 实验中使用的数据集大小和错误计数取自 Klie 等人(2023),并报告于表 2。
- 对于 CoNLL 2003,标注和错误在句子层面处理,以满足统计验收抽样分析所要求的独立性假设。
- 这些数据集用于观察验收抽样在真实标注错误率下的实际行为。
方法
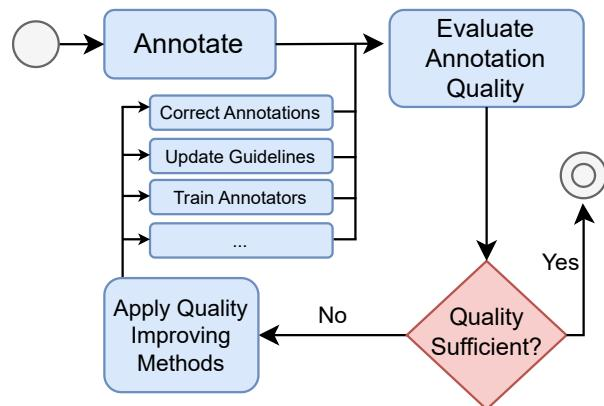
作者利用批次抽样、统计推断和验收决策规则,在有限人工检查下估计标注质量。工作流从标注批次开始,并从中人工审查实例子集。对于大小为 N 的批次,不放回地检查 n 个实例会产生错误计数 X。如果 K 表示批次中未观测到的错误标注数量,则被检查到的错误计数服从超几何分布:
P(X=x)=(nN)(xK)(n−xN−K).由于人工检查不会对同一实例重新抽样,因此相较于二项近似,更倾向于采用该分布。当 n/N 并非非常小时,二项捷径会变得不安全,而这在严格的统计质量控制设置中很常见。抽样单位还需要尊重标注依赖关系。例如,跨度标注任务理想情况下应在句子层面抽样,而文本识别或对象分类任务则应在图像层面抽样,而不是在边界框层面抽样。
第一个质量估计模块将观测错误率计算为被检查错误标注数量与被检查标注总数之比。作者提醒,仅报告该点估计是不充分的,因为它无法反映精度或不确定性。相反,他们将错误率建模为未知比例 θ,并为其构造置信区间。精确区间构造基于离散累积分布函数,定义为
P(X≥k;θl)=2α1, P(X≤k;θu)=2α2, α1+α2≤α,其中 k 为观测到的错误数量,θl,θu 界定估计错误率。为简化起见,两个尾部通常被对称处理。对于所需置信水平和区间半宽,可通过数值求解下式得到相应样本量。
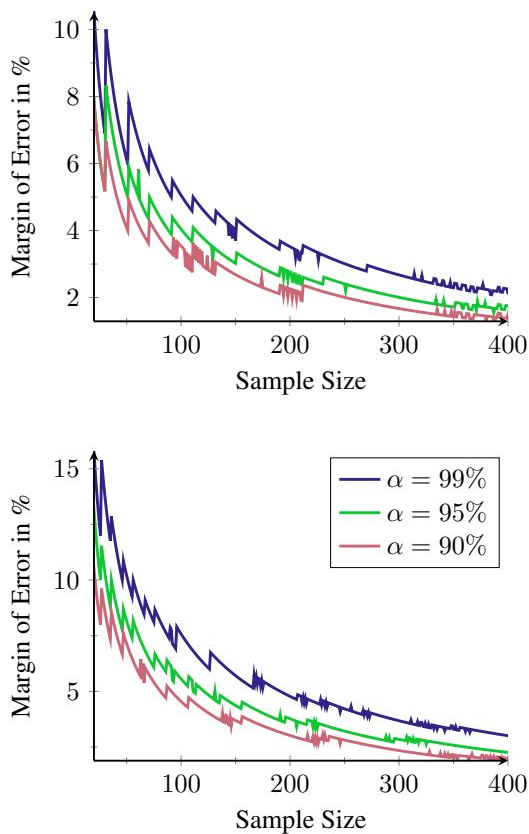
P(X≥k;θl)+P(X≤k;θu)−α=0.由于超几何分布是离散的,精确区间通常较为保守。也就是说,它们可能略宽于名义置信水平所要求的宽度,这往往意味着所需的样本量比严格必要的样本量略大。作者更倾向于这种保守行为,因为近似方法在极端比例附近,包括非常低的错误率附近,可能会产生不稳定的样本量或较差的覆盖率。样本量、置信水平和误差界限之间的关系是该模块的核心。请参考下图:
第二个模块将质量控制重新构建为决策问题,而非估计问题。验收抽样不会直接估计批次错误率。相反,它根据样本中发现的错误数量决定批次是否可接受或应被拒收。抽样方案通过求解以下方程指定样本量、接受限和拒收边界:
P(X≤c;pa,n)≥1−α, P(X≤c;pr,n)≤β,满足 0<pa<pr<1 和 1>1−α>β>0。这里,pa 为理想错误率,pr 为不可接受错误率,α 是与拒收合格批次相关的生产者风险,β 是与接受不合格批次相关的消费者风险。pa 与 pr 之间的区间是无差别区间,在该区间内,方案仍可能根据抽样结果决定接受或拒收。常见的三类方案是单次抽样、双次抽样和序贯抽样。其决策流程如下:
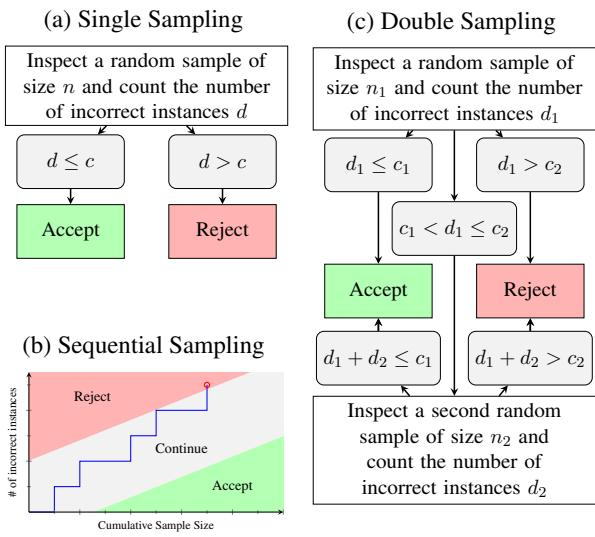
单次抽样检查大小为 n 的一个样本,如果观测到的错误计数最多为 c,则接受该批次。其平均样本量是恒定的,因为始终要检查整个样本。双次抽样从大小为 n1 的第一个样本开始。如果第一个错误计数足够低,则立即接受该批次。如果足够高,则立即拒收该批次。如果第一个结果落在中间区域,则检查大小为 n2 的第二个样本,并由合并后的错误计数决定最终决策。截尾会在拒收不可避免时提前停止第二个样本,从而进一步降低检查量。完整方案的期望检查量可表示为
ASNf=n1PI+(n1+n2)(1−PI),其中
PI=P(D1≤c1)+P(D1>c2),且 D1 是第一个样本中的错误计数。截尾方案采用更复杂的表达式,因为检查可能在第二个样本完全处理完毕之前停止。
序贯抽样通过逐个检查实例来推广双次抽样。每次检查后,该方法将累积错误计数与接受边界和拒收边界进行比较。如果计数过高,则拒收批次。如果足够低,则接受批次。否则,继续检查。边界取决于 pa、pr、α、β、已检查实例数量以及迄今观察到的错误数量。为避免过长的检查路径,该方法可在对应单次抽样方案的样本量处进行截断。在这种情况下,最终决策遵循单次抽样的接受限。截尾会调整边界,以缩小继续区域并提前停止,尽管对于超几何设置而言,精确的最优截尾比二项情形更困难。
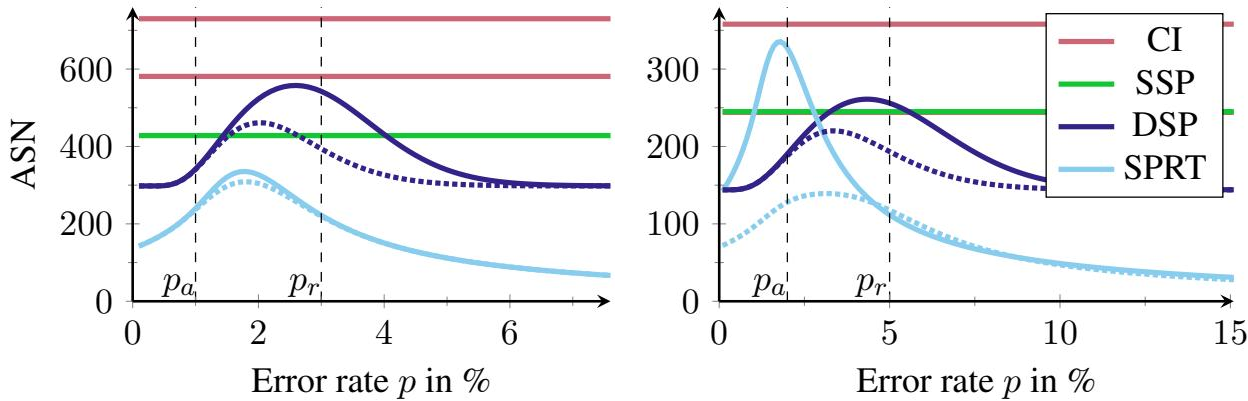
分析阶段使用平均样本量(ASN)比较这些模块的实际检查成本。对于置信区间和单次抽样,由于不存在提前停止,ASN 是固定的。对于双次抽样和序贯抽样,ASN 取决于批次的真实错误率。作者在批次大小 N=1000 下评估严格和宽松的质量控制设置。基于置信区间的错误率估计需要最大的样本量,因为它需要以较紧的边界估计较小的错误比例。在未截尾时,单次抽样通常比双次抽样更节省检查量,而截尾的双次抽样提高了效率。在所评估的配置下,截尾序贯抽样需要最低的检查量。置信区间、单次抽样、双次抽样和序贯抽样的平均样本量解析比较如下图所示,其中虚线曲线表示截尾:
实验
实验评估样本量如何影响标注错误估计的可靠性,并在包含已知错误的真实数据集上检验验收抽样。仿真结果表明,较小的样本量,尤其是大约低于 300 时,会产生较宽的置信区间和不精确的估计,而较大的样本量会提高精度。应用于 CoNLL 2003 和 IMDB 表明实用的验收抽样,包括为支持统计独立性的 CoNLL 2003 句子层面分析。
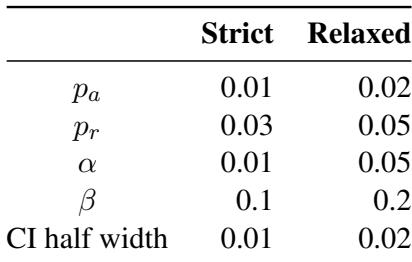
表格定义了两类目标质量制度:严格设置采用更紧的可接受错误水平,并且置信区间半宽小于宽松设置。相关讨论认为小样本估计不够精确,因为它们的置信界限可能很大,尤其是在样本量较小时。该讨论也促使在已知包含标注错误的数据集上采用验收抽样。在列出的参数中,严格质量目标比宽松质量目标更保守。较小的样本量会产生更宽的不确定性范围,降低估计可靠性。该方法应用于已知错误使质量目标具有相关性的标注数据集。
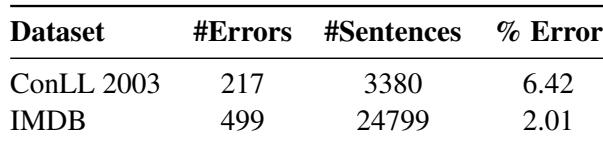
表格汇总了验收抽样实验中使用的两个 NLP 数据集的标注错误统计:CoNLL 2003 和 IMDB。就句子数量而言,CoNLL 2003 较小,但错误百分比更高,而 IMDB 大得多,错误百分比更低。两个数据集都提供了已知错误计数,适合用于在真实标注错误上测试基于抽样的错误估计。CoNLL 2003 的标注错误百分比高于 IMDB。IMDB 包含多得多的句子,同时保持相对较低的错误率。两个数据集都作为具有已知标注错误的真实案例,用于验收抽样。
实验在严格和宽松质量制度下评估验收抽样,表明严格目标更保守,小样本会产生更宽、可靠性更低的不确定性范围。该方法在 CoNLL 2003 和 IMDB 上进行测试,两者均为包含已知标注错误的真实数据集,其中 CoNLL 2003 更小且噪声更大,而 IMDB 更大且错误率更低。这些案例在不同样本量和错误水平下展示了该方法在真实标注错误上的表现。