Command Palette
Search for a command to run...
CHECKWHY: Causal Fact Verification via Argument Structure
CHECKWHY: Causal Fact Verification via Argument Structure
Jiasheng Si Yibo Zhao Yingjie Zhu Haiyang Zhu Wenpeng Lu Deyu Zhou
摘要
With the growing complexity of fact verification tasks, the concern with "thoughtful" reasoning capabilities is increasing. However, recent fact verification benchmarks mainly focus on checking a narrow scope of semantic factoids within claims and lack an explicit logical reasoning process. In this paper, we introduce CHECKWHY, a challenging dataset tailored to a novel causal fact verification task: checking the truthfulness of the causal relation within claims through rigorous reasoning steps. CHECKWHY consists of over 19K "why" claimevidence-argument structure triplets with supports, refutes, and not enough info labels. Each argument structure is composed of connected evidence, representing the reasoning process that begins with foundational evidence and progresses toward claim establishment. Through extensive experiments on state-of-the-art models, we validate the importance of incorporating the argument structure for causal fact verification. Moreover, the automated and human evaluation of argument structure generation reveals the difficulty in producing satisfying argument structure by fine-tuned models or Chainof-Thought prompted LLMs, leaving considerable room for future improvements.
一句话总结
齐鲁工业大学和东南大学推出 CHECKWHY,这是一个包含 19K 个实例的因果事实核查数据集,要求模型通过从基础证据到主张成立的论证结构来验证因果关系,结果表明微调模型和采用思维链提示的大语言模型难以生成令人满意的论证结构。
核心贡献
- 论文推出 CHECKWHY,这是一个由人工与模型协同构建的数据集和基准,用于对 “why” 主张进行因果事实核查,包含超过 19K 组主张、证据和论证三元组,标签为 supports、refutes 和 not enough info。
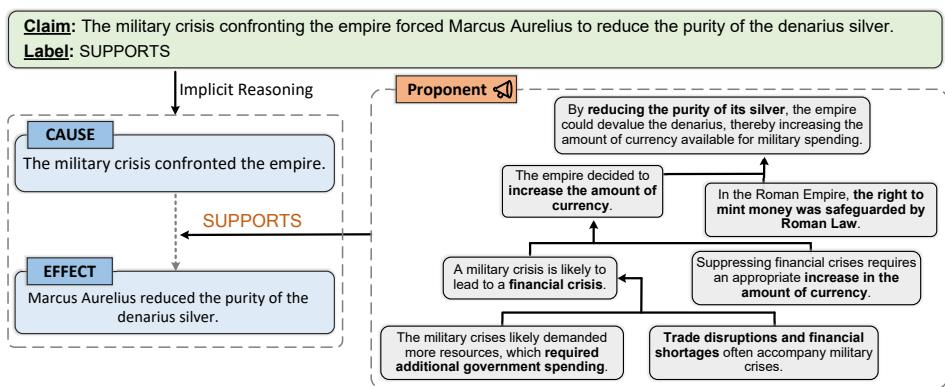
- 该工作构建具有汇聚、链接和发散模式的论证结构,以显式表示每个主张中从基础证据到因果结论的推理过程。
- 在前沿模型上进行的实验,包括自动评估和人工评估,表明论证结构对因果验证很重要,并且微调模型或采用思维链提示的大语言模型难以生成令人满意的论证结构。
引言
事实核查很重要,因为它有助于将在线主张与可靠证据进行核对,并减少错误信息传播。此前的基准大多关注 who、what、when 和 where 等简单事实问题,其验证通常可以通过直接证据匹配完成,因此它们对显式因果推理或多步推理提供的洞见有限。作者通过 CHECKWHY 来弥补这一空白,CHECKWHY 是用于验证包含因果关系的 “why” 主张的基准。他们利用人工与模型协同构建的方式,并借鉴逻辑学理论,构建了 19,596 个主张、证据和论证结构三元组,并评估了微调模型和大语言模型,以说明显式论证结构很有价值,但也很难生成。
数据集
-
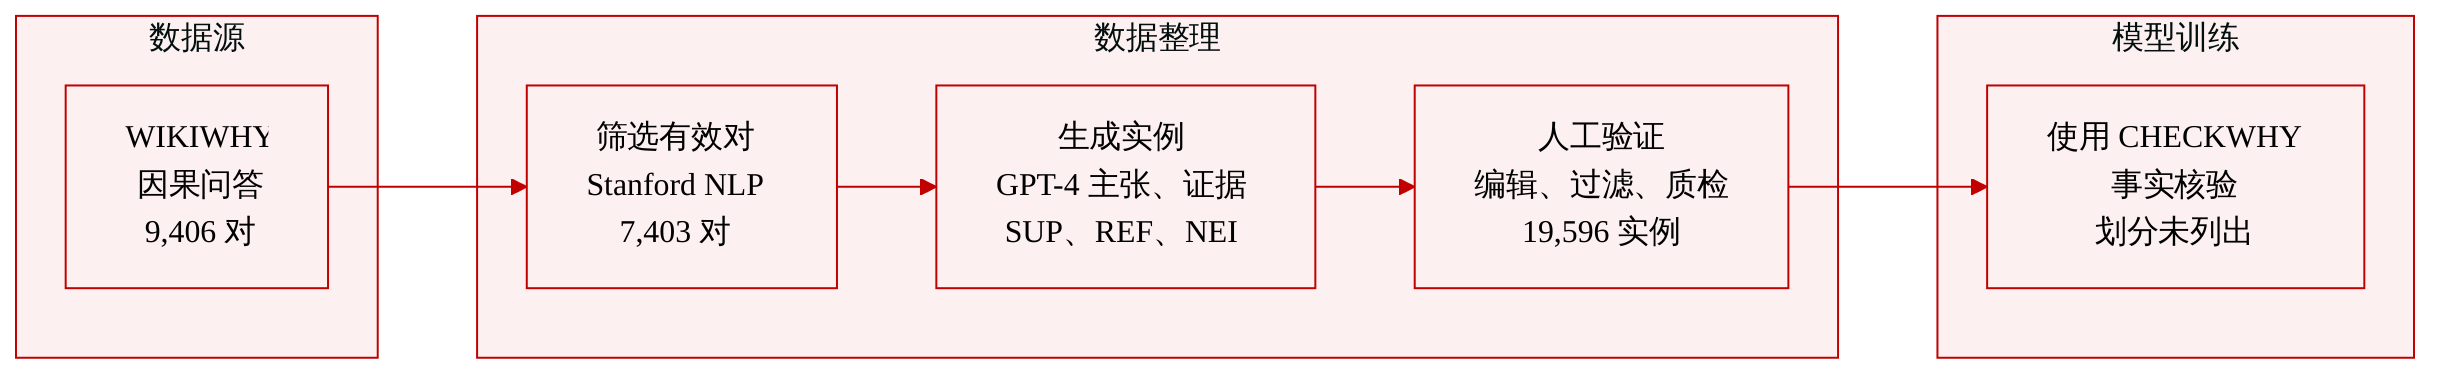
数据集来源:作者使用公开的因果关系问答数据集 WIKIWHY 作为初始来源。该流程从 9,406 条 WIKIWHY 因果对实例开始。
-
初始过滤:通过 Stanford NLP 解析检查缺失谓词,删除原因或结果任一侧句法结构不完整的因果对。该步骤保留 7,403 组有效因果对,用于后续构建。
-
总体构建:作者通过人工与模型协同流水线构建 CHECKWHY:数据准备、GPT-4 生成和人工校验。
-
标签分布:对每一组因果对,GPT-4 生成三种实例类型,并平衡其真实性标签:SUP 表示支持,REF 表示反驳,NEI 表示 not enough info。
-
SUP 证据生成:GPT-4 接收来自 WIKIWHY 的因果对和解释,然后生成支持因果主张的分步推理证据。
-
REF 证据生成:作者采用反事实策略。GPT-4 先生成与原结果相反或反事实的结果,然后从原原因推理到该反事实结果,以生成反驳原主张的证据。
-
NEI 证据生成:通过从 SUP 或 REF 实例中删除证据,或合并这两类实例的证据,使所提供证据本身不足以验证该主张,从而构造 NEI 实例。
-
论证结构:GPT-4 还使用 Python 风格示例,为 SUP 和 REF 实例生成结构化推理。该模式将证据表示为 FACT 节点,并使用函数式链接表示串联、发散和合并推理路径。
-
主张生成:GPT-4 在无法访问外部信息的情况下,将每组因果对转换为多样的自然语言因果主张。
-
干扰证据:为模拟具有误导性的验证场景,BM25 检索 300 条与主张词汇重叠度很高的候选证据,BLEURT 再为每个实例选择 8 到 12 条语义相近的干扰证据。
-
人工编辑:标注人员审阅并编辑主张、证据和论证结构。他们检查主张是否忠实覆盖因果对,证据是否与标签一致,论证结构是否简洁、语法正确且逻辑有效。
-
人工过滤:另一组标注人员根据忠实性、流畅性和有效性三项标准,过滤低质量的已编辑实例。过滤后保留 6,757 条 SUP 实例和 6,638 条 REF 实例。
-
质量控制:每个实例由两名标注人员进行编辑和过滤,第三名标注人员解决分歧。对于最终保留的实例,作者报告 Fleiss k 为 0.75。
-
最终规模:CHECKWHY 包含 6,532 组完整实例集,每组包括 SUP、REF 和 NEI 实例,共计 19,596 个实例。
-
实例模式:SUP 和 REF 实例包含主张、证据和论证结构。NEI 实例仅包含主张和证据,因为它们缺少有效的论证结构。
-
推理子集:由于 NEI 不包含论证结构,作者还构建了一个排除 NEI 的 CHECKWHY 变体,用于通过 SUP 和 REF 论证结构评估推理能力。
-
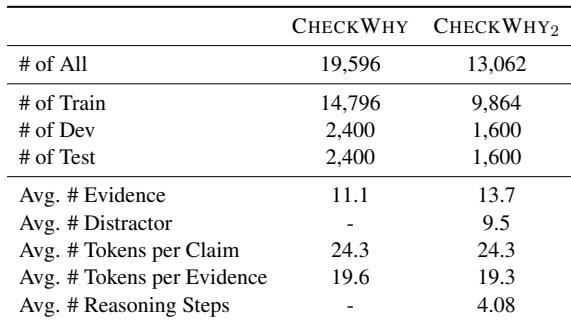
数据集统计:每个实例平均包含 13.7 条证据和 4.08 个推理步骤。
-
推理类别:样本分析显示,事件因果性占 36%,基于属性的推断占 22%,基于规则的推断占 17%,归纳推理占 14%,顺序推理占 10%。
-
用途:作者将 CHECKWHY 用作具有平衡支持、反驳和 not enough info 标签的事实核查数据集,并将其作为论证结构推理基准。该数据集部分描述的是构建与评估用途,没有明确说明训练划分或混合比例。
方法
作者利用人工与模型协同流水线构建 CHECKWHY 标注框架。如下图所示:
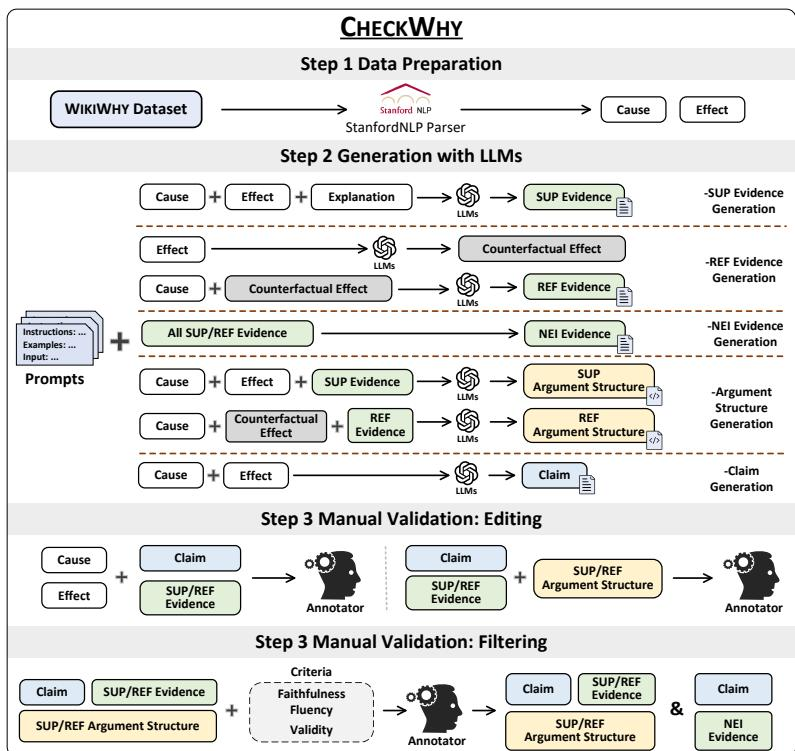
该流水线由数据准备、大语言模型生成和人工校验组成。第一阶段解析源因果记录,以抽取原因和结果单元,这些单元成为主张生成、证据生成和论证结构建模的基础输入。
在生成之前,框架将验证证据表示为有向论证树。主张作为根节点,证据节点作为子节点,并通过编码逻辑支持关系的边连接。该设计将相关推理模式合并为少量结构算子。串联链接从一个证据节点指向一个父节点。发散链接从一个证据节点指向多个父节点。合并链接从多个证据节点指向一个父节点。为对同一因果主张同时生成支持和反驳实例,框架对同一主张应用不同结构。一种结构建立因果关系,另一种结构编码反驳所主张因果关系的推理。
对于模型辅助生成,作者使用 GPT-4 进行上下文学习。对每组原因和结果,流程分为若干模块。支持证据模块输入原因、结果和来源解释,并使用 ReAct 风格提示,促使模型从原因到结果进行分步推理。生成的推理链被视为支持证据。
反驳模块使用反事实构造策略。从原始结果开始,提示模型生成具有相反标签的反事实结果。然后提示模型从原始原因推理到该反事实结果。所得证据被解释为反驳原始结果。这种两步设计缩小了难以构造反驳证据的案例的生成空间。
NEI 证据模块创建标签为 not enough info 的实例。该模块可以从支持或反驳实例中删除证据,或合并两种类型的证据,使剩余证据不足以令人信服地验证该主张。
对于每个生成实例,框架还产生一个紧凑的论证结构。GPT-4 使用 Python 风格代码模板进行提示,模板施加严格格式约束。这些模板引入用于证据节点的 FACT 类,以及对应串联、发散和合并论证模式的三个链接函数。这些函数引导模型输出可执行风格的推理路径,而不是自由形式的散文。
主张生成模块输入原因和结果,并提示模型以多样的自然语言形式表达因果主张,同时不访问外部信息。为模拟具有误导性的验证场景,该流水线还会构造干扰证据。BM25 检索与主张词汇重叠度高的候选,BLEURT 再选择语义相似度较近的一组较小候选。这些选定的干扰证据会附加到 SUP、REF 和 NEI 实例。
最后阶段通过两种模式进行人工校验。在编辑模式中,具有自然语言处理背景的标注人员审阅并完善主张、证据和论证结构。他们检查主张是否保留原始因果细节,证据是否与其标签一致,语言是否简洁,以及论证结构是否去除多余的非代码内容。在过滤模式中,另一组标注人员根据忠实性、流畅性和有效性,决定保留或丢弃已编辑实例。忠实性要求证据能够在其所属标签下验证该主张。流畅性要求表达符合语法且可读。有效性要求论证结构正确刻画从原因到结果的推理。
质量控制通过重复标注实施。两名标注人员分别对每个实例进行编辑和过滤。第三名标注人员解决分歧,并以多数投票确定最终保留实例。
实验
实验通过四个难度递增的任务评估 CHECKWHY:仅基于叶节点证据验证主张、在给定论证结构下验证主张、从证据联合预测标签和论证结构,以及仅从叶节点证据构造完整推理链,并使用判别式、生成式和大语言模型基线进行评估。自动评估和人工评估显示,提供显式论证结构能够一致地提升验证效果,而模糊的 not enough info 证据对大语言模型尤其困难。总体而言,显式结构推理是该基准的核心,CodeT5 风格模型在结构生成方面表现最佳,而大语言模型在构造可靠因果论证结构方面仍然受限,表明仍有很大改进空间。
表格总结了 CHECKWHY 语料库及其用于论证结构推理的 SUP/REF 子集。完整集合包含更多实例,而子集聚焦于支持和反驳主张,并显示更高的平均证据数量,包括干扰证据。两个版本中的主张长度都保持相近,说明该数据以扩展证据而非更长主张为特征。完整 CHECKWHY 集合更大,并在训练集、开发集和测试集之间保持平衡。SUP/REF 子集平均证据数量更高,且包含干扰证据,反映了更详细的推理输入。完整集合与子集之间的平均主张长度几乎相同。与 WIKIWHY 相比,CHECKWHY 被认为具有更长的推理证据和更多推理步骤。
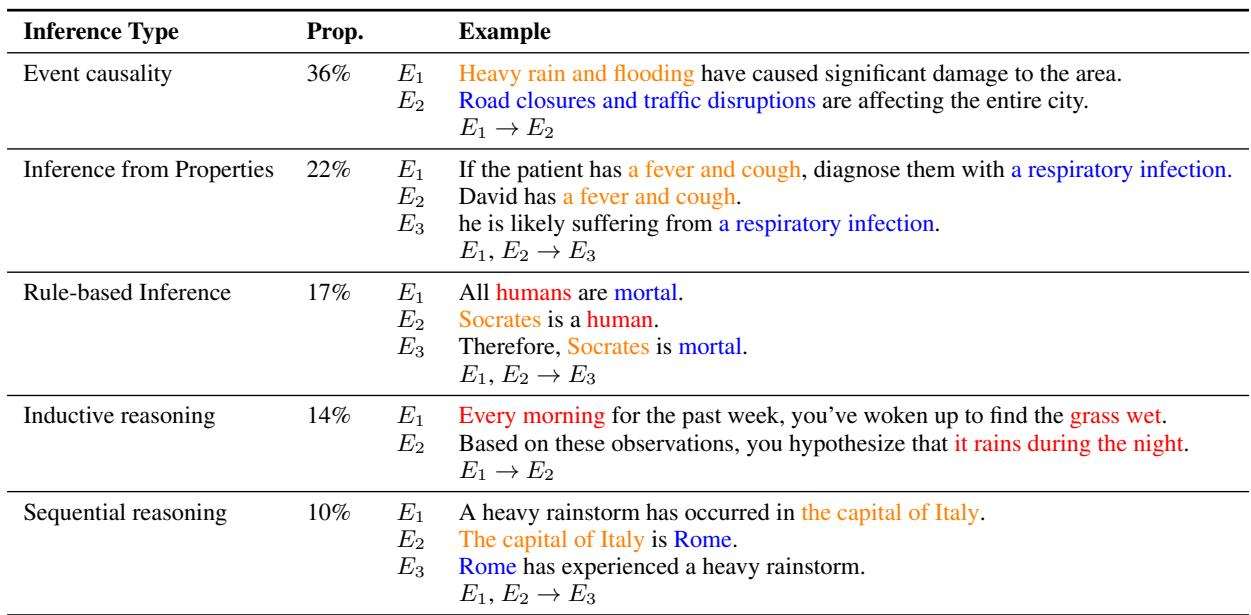
采样的论证结构呈现多种常见推理形式,其中事件因果性最为突出。基于属性的推断和基于规则的推断也占示例的重要比例,说明推理往往依赖显式因果链接或结构化条件。事件因果性在采样实例中是最常见的推理类型。基于属性的推理和基于规则的推理也是论证结构中常见的模式。
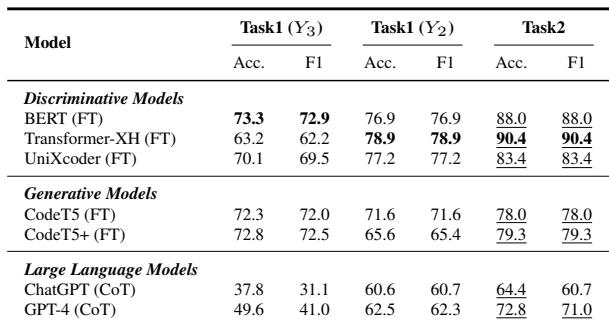
在因果验证任务上,微调的判别式模型总体上优于生成式 CodeT5 基线,尤其是在提供论证结构时。从仅基于文本的 Task 1 设置转向结构感知的 Task 2 设置后,各基线均获得一致提升,其中 Transformer-XH 受益最大。证据模糊设置会产生混合效果,大多数基线有所提升,但 CodeT5 性能略有下降。判别式模型总体上取得了最强的验证准确率和 F1 分数。在所有基线中,Transformer-XH 从论证结构中受益最大。CodeT5 落后于判别式模型,并且从 Y3 转向 Y2 时没有出现性能提升。
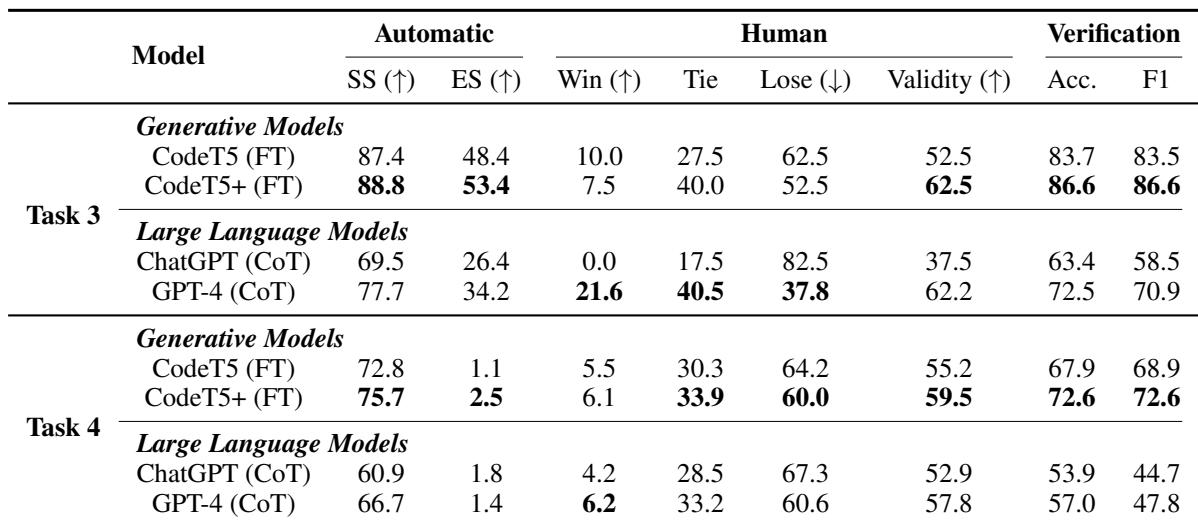
在论证生成设置中,CodeT5+ 是自动指标上最强的基线,在结构相似度、精确匹配、准确率和 F1 上均优于 CodeT5 和大语言模型。从自动评估看,大语言模型仍落后于微调模型,尽管 GPT-4 可以在人工比较中获得更有利的结果,这说明流畅性和语义正确性并不能转化为整体优势。人工评估表明,各基线仍然有限,存在很大改进空间。CodeT5+ 在自动论证生成和验证指标上领先。大语言模型的自动得分较弱,但在人工判断中可能更具竞争力。结构相似度始终高于精确匹配,反映的是语义重叠,而非逐字匹配。即使是最强基线也存在明显改进空间,其人工评估有效性仅为中等水平。
实验分析了 CHECKWHY 语料库及其 SUP/REF 子集、采样的论证结构,以及基线模型在因果验证和论证生成上的表现。结果表明,扩展且结构化的证据是该数据的核心,事件因果性、基于属性的推理和基于规则的推理是反复出现的论证形式。微调判别式模型在验证任务上表现最佳,尤其是在使用论证结构时;CodeT5+ 在自动论证生成指标上最强,而大语言模型在人工评估中显得相对更具竞争力,但所有方法仍然有限。