Command Palette
Search for a command to run...
Causal Estimation of Memorisation Profiles
Causal Estimation of Memorisation Profiles
Pietro Lesci Clara Meister Thomas Hofmann Andreas Vlachos Tiago Pimentel
摘要
Understanding memorisation in language models has practical and societal implications, e.g., studying models' training dynamics or preventing copyright infringements. Prior work defines memorisation as the causal effect of training with an instance on the model's ability to predict that instance. This definition relies on a counterfactual: the ability to observe what would have happened had the model not seen that instance. Existing methods struggle to provide computationally efficient and accurate estimates of this counterfactual. Further, they often estimate memorisation for a model architecture rather than for a specific model instance. This paper fills an important gap in the literature, proposing a new, principled, and efficient method to estimate memorisation based on the difference-in-differences design from econometrics. Using this method, we characterise a model's memorisation profile—its memorisation trends across training—by only observing its behaviour on a small set of instances throughout training. In experiments with the Pythia model suite, we find that memorisation (i) is stronger and more persistent in larger models, (ii) is determined by data order and learning rate, and (iii) has stable trends across model sizes, thus making memorisation in larger models predictable from smaller ones.
一句话总结
剑桥大学与苏黎世联邦理工学院提出一种源自计量经济学的双重差分方法,通过在整个训练过程中观察一小批实例,高效估计语言模型的逐实例记忆曲线;在 Pythia 模型套件上的实验表明,模型规模越大记忆越强,记忆受数据顺序和学习率支配,并且可以跨模型规模进行预测。
核心贡献
-
基于计量经济学中的双重差分设计,开发了一种无偏且计算效率较高的实例级反事实记忆估计量,用于估计将某个训练实例纳入训练后,对模型预测该实例能力的影响。
-
提出一种通过在整个训练过程中观察一小批实例来刻画模型训练记忆曲线的方法,将检查点时间、数据顺序和学习率效应从架构层面的平均值中分离出来。
-
在 Pythia 模型套件上的实验表明,更大模型的记忆更强、更持久,由数据顺序和学习率决定,并且跨模型规模保持稳定,使得可以用较小模型预测较大模型中的记忆。
引言
大语言模型在网页规模语料库上进行训练,却能够逐字复现训练序列,这与版权、隐私、事实理解和训练动态都密切相关。已有工作以因果方式定义记忆,但测量它很困难,因为反事实结果即模型在没有使用某个实例进行训练时的表现,无法观察。较早的估计要么需要多次训练,因此描述的是模型架构而非特定模型;要么假设反事实结果可以忽略,并可能把记忆与普通可预测性混为一谈。作者利用潜在结果和计量经济学来形式化反事实记忆,并提出一种基于训练检查点和对数似然测量的观测估计量。由此得到整个训练过程中的记忆曲线,并表明更大模型的记忆更持久,学习率和数据位置很重要,而且这些曲线足够稳定,可以用较小模型预测更大模型中的记忆。
方法
作者利用因果框架刻画语言模型何时记忆训练样本。每个样本 x 都会在其首次用于训练的特定时间步 g=G(x) 接受处理。令 Yc(x;g) 表示在时间步 g 将 x 纳入训练的条件下,模型在检查点 c 上对 x 的表现。反事实结果 Yc(x;∞) 表示如果该样本从未用于训练,模型在同一样本上的假想表现。在这一框架下,反事实记忆被定义为在时间步 g 对某个样本进行训练对其在时间步 c 后续评估所产生的因果效应:
τx,c=Yc(x;g)−Yc(x;∞).由于无法观察个体的反事实结果,该方法关注在所有于时间步 g 接受处理的样本上的平均处理效应:
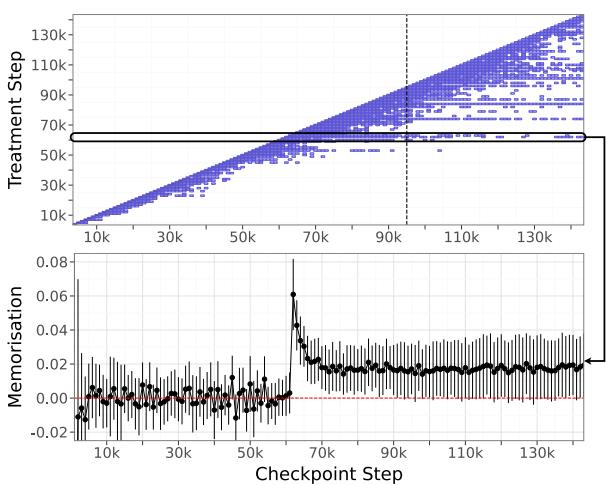
τg,c=xE[Yc(x;g)−Yc(x;∞)∣G(x)=g].τg,c 这一组数值覆盖了处理时间步 g 和检查点时间步 c,形成一条记忆曲线。该曲线的每一行表示在时间步 g 引入的一批样本的记忆路径。在样本暴露之前的检查点不存在记忆,因此当 c<g 时,τg,c=0。当 c=g 时,这种效应称为即时记忆;当 c>g 时,称为持久记忆;当 c=T 时,称为残留记忆。
为了进行估计,作者首先观察训练批 Bg 中样本的事实结果。将在检查点 c 处的批平均观测性能定义为:
Yc(g)=∣Bg∣1x∈Bg∑Yc(x).因果估计量中的第一项可以用该量直接估计。第二项,
xE[Yc(x;∞)∣G(x)=g],是反事实量,因为 Bg 中的样本实际上已经用于训练。为解决该问题,作者推导了两种估计量,用可观测的代理结果替换不可观测的反事实结果。
第一种是差分估计量。假设训练样本和验证样本独立同分布,并且样本被随机分配到训练批或验证集中,那么在未接受处理的验证样本上的期望表现可以近似接受处理样本的期望反事实表现。相应的估计量为:
τg,cdiff=Yc(g)−Yc(∞),其中 B∞ 表示留出验证集。该估计量仅使用检查点 c 处的观测结果。它比较已训练批的平均表现与未训练验证样本的平均表现。该方法要求训练集和验证集之间具有强分布匹配,并且由于批均值 Yc(g) 仅受限于 Bg 中的样本,其方差可能仍然较高。
主要估计程序采用双重差分设计。该方法利用时间维度来识别处理效应,比较接受处理样本与未接受处理样本在检查点之间的表现变化。它依赖平行趋势和无预期效应。平行趋势意味着,在没有训练的情况下,接受处理样本和未接受处理样本在不同检查点之间的期望表现变化相同:
xE[Yc(x;∞)−Yc′(x;∞)∣G(x)=g]=xE[Yc(x;∞)−Yc′(x;∞)∣G(x)=∞].无预期效应意味着在时间步 g 进行训练不会影响任何检查点 c<g 的表现:
xE[Yc(x;g)∣G(x)=g]=xE[Yc(x;∞)∣G(x)=g].在这些条件下,目标因果估计量可以用可观测的面板结果重写。双重差分估计量为:
τg,cdid=xE[Yc(x;g)−Yg−1(x;g)∣G(x)=g]−xE[Yc(x;∞)−Yg−1(x;∞)∣G(x)=∞].在实践中,作者在一批训练批和验证样本的子集上,于处理之前的紧邻检查点 g−1 以及之后的某个检查点 c 评估模型表现。这构成了一个观测结果面板,类似于因果推断中的重复测量。双重差分估计量按如下方式计算:
τg,cdid=change for trained batch(Yc(g)−Yg−1(g))−change for validation set(Yc(∞)−Yg−1(∞)).该工作流仅使用来自模型检查点序列的观测结果。对于每个批 Bg,该方法测量该批可用于训练之后模型在该批上的表现变化量,同时减去那些仍未训练样本上观测到的背景变化。这一差分控制了模型随时间发生的整体改进,而不是因暴露于特定训练批而产生的改进。
作者还将影响函数描述为在最终检查点估计反事实记忆的一种逐实例级近似替代方法。影响函数估计若从训练集中移除某个样本而无需重新训练时参数会发生的变化:
θ−x,T≈θT+N1Hθ−1∇θL(θT,x),其中 Hθ 是在 θT 处评估得到的训练损失海森矩阵。通过用调整后的参数评估该样本,可以得到估计的反事实表现:
Y−x,T(x)=γ(θ−x,T;x).相应的基于影响函数的记忆估计量为:
τx,Tinfl=YT(x)−Y−x,T(x).该方法避免了重复重新训练,并提供逐实例估计,但它依赖于凸性、海森矩阵正定性以及收敛假设,这些假设在大语言模型上通常较弱。它也只适用于最终检查点,因此无法刻画中间检查点之间的记忆动态。
实验
实验使用经过子采样的训练实例面板,并在多个检查点上以序列级对数似然进行测量,评估了 Pythia 语言模型中从 70M 到 12B 参数规模的反事实记忆。结果显示,即时记忆在训练早期更强,并随模型规模增大而增加;小模型中的持久记忆较弱或缺失,并在固定步数后趋于平稳。残留记忆通常在统计上不显著,不过训练末期会出现近因效应,并且不同模型规模下的总体记忆模式大体可预测。