Command Palette
Search for a command to run...
M4LE:面向大语言模型的多能力、多范围、多任务、多领域长上下文评测基准
M4LE:面向大语言模型的多能力、多范围、多任务、多领域长上下文评测基准
Wai-Chung Kwan Xingshan Zeng Yufei Wang Yusen Sun Liangyou Li Yuxin Jiang Lifeng Shang Qun Liu Kam-Fai Wong
摘要
管理长序列已成为大语言模型(LLM)的一项重要且必要的功能。然而,评估其处理长上下文的能力仍然是一个挑战。本文提出了 M4LE,一个多能力、多范围、多任务、多领域的长上下文评测基准。该基准涵盖 36 个 NLP 数据集,覆盖 11 种任务类型和 12 个领域,提供了一个全面的测试平台。针对缺乏自然长序列任务的问题,我们提出了一种自动方法,将短序列任务转化为长序列场景。这些场景从五个关键能力维度评估 LLM 的长上下文理解能力:基于显式线索或语义线索对长上下文中单个或多个相关片段的理解,以及全局上下文理解。这种自动方法使我们能够创建输入长度从 1k 到 8k 均匀分布的实例。我们对 11 个主流 LLM 的评测揭示了以下发现:1)当前 LLM 难以理解长上下文,尤其是当任务需要多片段注意力时;2)对于能力较强的 LLM,语义检索更具挑战性;3)在较长文本上通过位置插值进行微调的模型,与使用神经正切核(NTK)感知缩放方法且无需微调的模型性能相当。我们将该基准公开开放,以促进该挑战性领域的未来研究。
一句话总结
CUHK、华为诺亚方舟实验室、HKUST 及合作者提出 M4LE⋅,这是一个覆盖 36 个 NLP 数据集的长上下文评估基准,引入自动短序列到长序列转换方法,从五种能力评估 LLM,揭示它们在多跨度注意力和语义检索方面的不足。
核心贡献
-
引入 M4LE,这是一个多能力、多长度范围、多任务和多领域基准,用于评估 LLM 的长上下文理解能力。该基准基于 36 个 NLP 数据集构建,覆盖 11 种任务类型和 12 个领域,并围绕单跨度、多跨度、显式提示、语义提示和全局上下文能力组织。
-
提出一种自动构建方法,将短序列 NLP 任务转换为长上下文评估实例,生成从 1k 到 8k 输入长度均匀分布的示例,并将覆盖范围扩展到天然长数据集之外。
-
在 M4LE 上评估 11 个主流 LLM,发现模型在多跨度注意力任务上表现不佳,语义检索对能力较强的模型也尤其困难,而在更长文本上使用位置插值进行微调,与不进行微调的 NTK-aware scaling 相比表现相当。
引言
大语言模型越来越多地用于需要处理长输入的任务,例如文档理解、摘要和信息抽取,这使得鲁棒的长上下文评估对实际部署变得重要。早期的 L-Eval 和 LongBench 等基准主要复用现有的长 NLP 数据集,这限制了任务多样性、长度控制以及对不同长上下文能力的覆盖,同时也会带来潜在的数据泄漏风险。作者提出 M4LE,该基准从短 NLP 数据集构建长上下文评估任务,并覆盖五种理解能力、1K 到 8K 词的上下文长度、36 个数据集、11 种任务类型和多个领域。
数据集
-
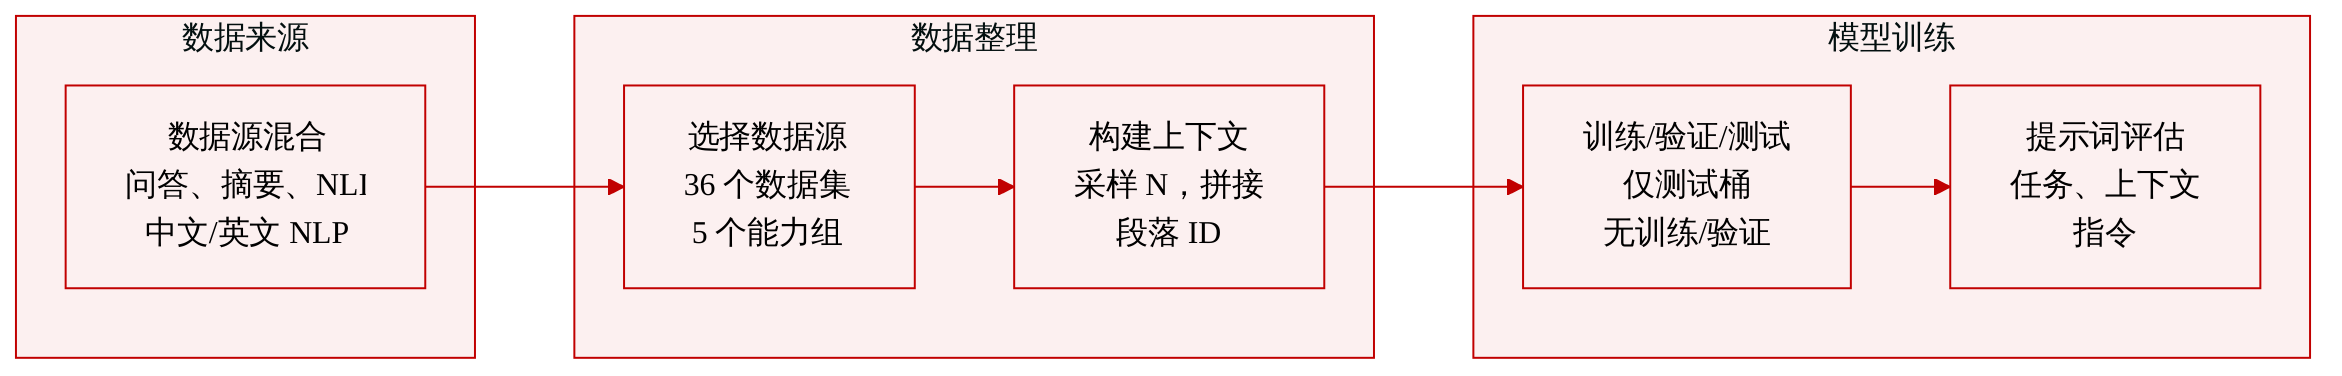
作者将 M4LE 构建为用于长上下文理解的评估基准,而不是训练数据集。节选中未描述训练划分或明确的混合比例。
-
每个样本被格式化为包含以下内容的元组:
- 任务描述
- 上下文
- 指令
- 响应
-
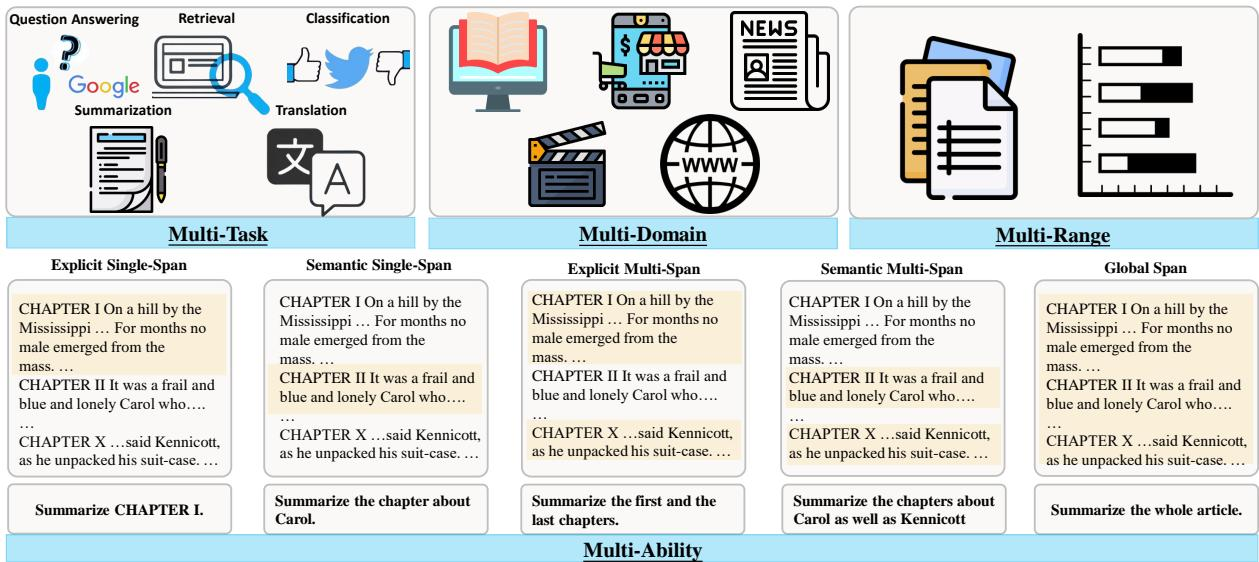
该基准覆盖五类能力:
- 显式单跨度理解,包含 10 个构建数据集
- 语义单跨度理解,包含 9 个构建数据集
- 显式多跨度理解,包含 4 个构建数据集
- 语义多跨度理解,包含 3 个构建数据集
- 全局上下文理解,包含 10 个构建数据集
-
源数据集选自广泛使用的中英文 NLP 数据集,覆盖多样任务和领域,包括新闻、Wikipedia、网页摘要、书籍、专利、学术论文、医学文本、教材、电商内容和字幕。
-
数据来源按任务类型分组:
- QA:TriviaQA、NQ-Open、HotpotQA、DRCD、NewsQA、DuoRC 和 C3
- 分类:BIGPATENT、MNDS News、THUCNews 和一个电商情感数据集
- 摘要:Arxiv、Pubmed、BIGPATENT、Booksum、CNNNews、MNDS News、Wikihow、CNewsum、CLTS+、News2016、LCSTS、CEPSUM 和用于双语摘要的 NCLS
- NLI:使用英文 WikiText-103 和中文 Wiki2019zh 构建的任务
- 翻译:Tedtalks、OpenSubtitles 和 News commentary,使用句子级对齐构建更长的上下文
- 检索:额外检索任务使用与 NLI 相同的来源构建
-
作者同时选择天然长上下文的数据集和较短输入的数据集,后者可通过自定义构建扩展为更长的上下文。
-
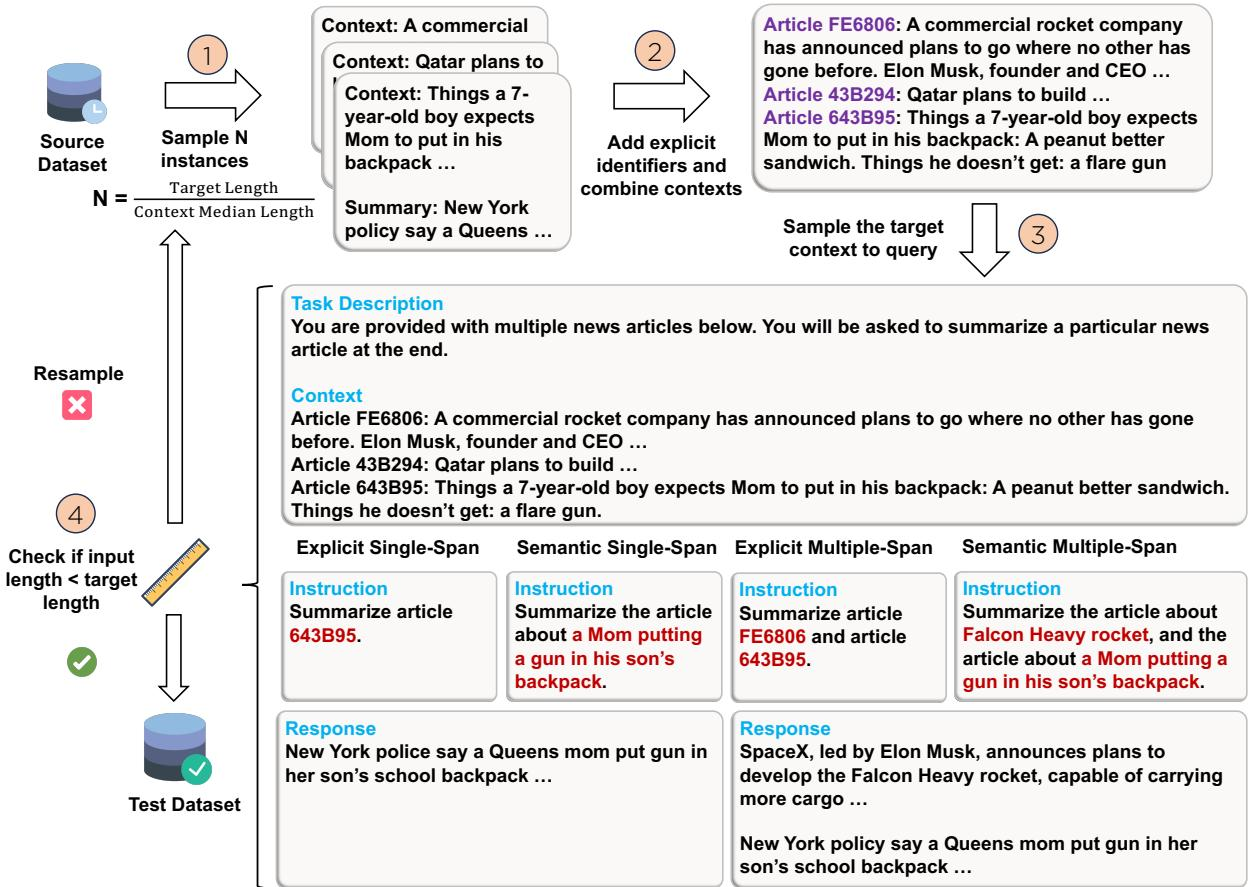
要为某个目标长度范围 K 构建测试实例,作者从一个源数据集中采样 N 个实例。N 由 K 除以该数据集的中位上下文长度确定。
-
它们将采样到的上下文段落拼接为一个 Context 序列,并在每个段落开头附加显式段落标识符。
-
指令决定模型必须使用显式标识符还是语义提示来定位相关段落。
-
单跨度任务需要一个段落中的信息,而多跨度任务需要来自多个不相交段落的信息。
-
计数任务被纳入语义多跨度任务,以要求统计相关段落。
-
当原始实例已经足够长,且任务需要整个上下文时,使用全局上下文理解。
-
相关段落被故意均匀分布在上下文中,以减少位置效应带来的偏差。
-
示例还被划分为不同长度桶,以评估不同上下文长度下的性能。
-
该数据集被用作基于提示的基准:模型接收任务描述、长上下文和指令,然后必须定位所需信息并生成预期响应。
方法
作者采用结构化评估框架,其中每个样本被定义为一个元组,包含任务描述、长上下文、指令和目标响应。为了正确作答,模型必须首先识别上下文中的相关部分。该框架沿两个正交维度组织这一要求:相关证据的范围,以及用于定位它的提示类型。相关证据可以是单个文本片段、多个文本片段或整个上下文,而提示可以是显式指针(如段落标识符),或必须从指令中推断的语义提示。将这些维度组合起来形成五种针对性能力:显式单跨度、语义单跨度、显式多跨度、语义多跨度和全局上下文理解。下面的概览图展示了这一分类体系,以及该框架的多任务、多领域和多长度范围设计。
任务构建模块将短上下文源样本转换为受控的长上下文评估实例。对于期望的目标长度 K,该流程估算所需源样本数量为 N=K/Lmed,其中 Lmed 表示源数据集的中位上下文长度。然后它采样 N 个实例,将它们的上下文拼接为单个序列,并为每个上下文块附加显式标识符。为了减少位置偏差,相关片段被分布在整个合并输入中,而不是只放在开头或结尾。
对于每种能力,指令会根据预期的检索挑战进行调整。在显式单跨度任务中,指令直接指出一个上下文块。在语义单跨度任务中,指令描述目标块的内容或主题,要求模型将线索匹配到正确段落。显式多跨度任务要求使用显式标识符处理多个不相交块,而语义多跨度任务用语义线索替换标识符,并可能引入计数式操作以测试段落级聚合。全局上下文理解在任务完成依赖整个输入时使用完整拼接后的上下文。下面的构建图展示完整工作流程,包括长度检查和当合并上下文不满足目标约束时的重采样。
实验
该研究在多个上下文长度桶和任务能力上评估 11 个开源和闭源 LLM,并使用 M4LE 分析性能如何随输入增长而变化,以及语言或支持文档位置是否影响长上下文行为。在所有实验中,所有模型在更长上下文下都显著退化;大多数开源模型在超过短上下文后下降更陡,并且与 GPT-3.5 的差距扩大,而在更长上下文上微调相对于位置缩放带来的优势有限。多跨度和语义检索任务尤其困难;消融实验表明,当微调数据支持双语时,双语退化遵循相似模式,此外模型通常偏好上下文开头或结尾的信息,而不是中间部分。
M4LE 被呈现为比所比较基线更广泛的长上下文基准,提供更广的任务、数据集和领域覆盖。它也不同于仅依赖现有长序列 NLP 任务的方法,而是明确支持多种上下文长度范围和能力类别。M4LE 覆盖的任务和数据集多于所比较基准。它同时包含英文和中文,并增加了更广泛的领域覆盖。它在列出的基准中唯一标出对多长度范围和多能力的支持。
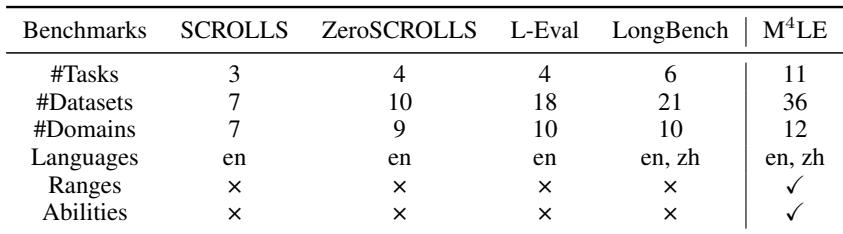
该评估将 M4LE 与现有长上下文基准进行比较,显示其提供更广的任务、数据集、领域和语言覆盖。它还验证了该基准对多种上下文长度范围和能力类别的独特支持,而不是仅依赖标准长序列 NLP 任务。总体而言,M4LE 被定位为一个更全面的多语言长上下文评估框架。