Command Palette
Search for a command to run...
利用扩散模型破译甲骨文语言
利用扩散模型破译甲骨文语言
Haisu Guan Huanxin Yang Xinyu Wang Shengwei Han Yongge Liu Lianwen Jin Xiang Bai Yuliang Liu
摘要
甲骨文(OBS)起源于约 3000 年前的中国商朝,是语言学史上的一座里程碑,其历史早于许多已确认的文字体系。尽管已发现数千篇铭文,甲骨文仍有大量内容尚未被破译,为这一古老语言蒙上了一层神秘面纱。现代人工智能技术的出现为甲骨文破译开辟了新的前沿,对严重依赖大规模语料库的传统自然语言处理(NLP)方法提出了挑战——而历史语言恰恰无法提供这样的语料资源。本文提出了一种全新的方法,采用图像生成技术,具体开发了甲骨文破译工具 OBSD。OBSD 利用基于条件扩散的策略生成破译线索,为人工智能辅助的古文字分析开辟了新路径。为验证其有效性,研究团队在甲骨文数据集上开展了大量实验,定量结果证明了 OBSD 的有效性。代码及破译结果将在 https://github.com/guanhaisu/OBSD 公开。
一句话总结
研究人员提出 OBSD,一种基于条件扩散的模型,可生成 Oracle Bone Script 的视觉线索,用于 Oracle Bone Script 破译,从而为缺乏传统 NLP 方法所需大规模文本语料的古代语言提供图像生成方法。
核心贡献
- Oracle Bone Script Decipher(OBSD)是一种基于条件扩散的图像生成模型,通过利用 Oracle Bone Script 古代字形与现代汉字之间的结构关系,为识别未知 Oracle Bone Script 字符生成视觉线索。
- 引入局部结构采样(Localized Structural Sampling)技术和 zero-shot 精炼模块,帮助模型从有限历史数据中捕捉精细字符结构,并提升破译准确率。
- 在 HUST-OBS 和 EVOBC 数据集上的实验表明,配合消融研究和基准比较,OBSD 可用于 AI 辅助的古代语言破译。
引言
Oracle Bone Script 是中国商代刻写在龟甲和兽骨上的古代书写体系。它为理解早期中国文明的历史、语言和文化提供了直接窗口。尽管已识别出超过 4,500 个 Oracle Bone Script 字符,但只有约 1,600 个被破译并与现代汉字建立对应关系,大多数铭文仍无法阅读,使 Oracle Bone Script 成为 AI 辅助历史语言重建中的重要但困难对象。
多数已有研究集中于识别已经破译的 Oracle Bone Script 字符,或依赖已知已破译样本进行基于案例的推理。生成式方法面临额外挑战,因为 Oracle Bone Script 没有标准编码方案,主要以碎片化图像形式存世,也缺乏完整数字语料库。这限制了基于文本的 NLP 模型,也使学习从古代文字到现代汉字的演化路径变得困难。
作者利用条件扩散模型辅助 Oracle Bone Script 破译。作者训练 Oracle Bone Script Decipher,从未知的 Oracle Bone Script 字符生成可能的现代汉字图像,并采用基于图像的生成方式,而不是依赖大规模文本语料。作者还引入局部结构采样来捕捉精细字符结构,并加入 zero-shot 精炼模块来提升破译准确率。该方法为 AI 辅助古代文字破译提供了新路径,并可能扩展到楔形文字和象形文字等其他古代书写体系。
数据集
-
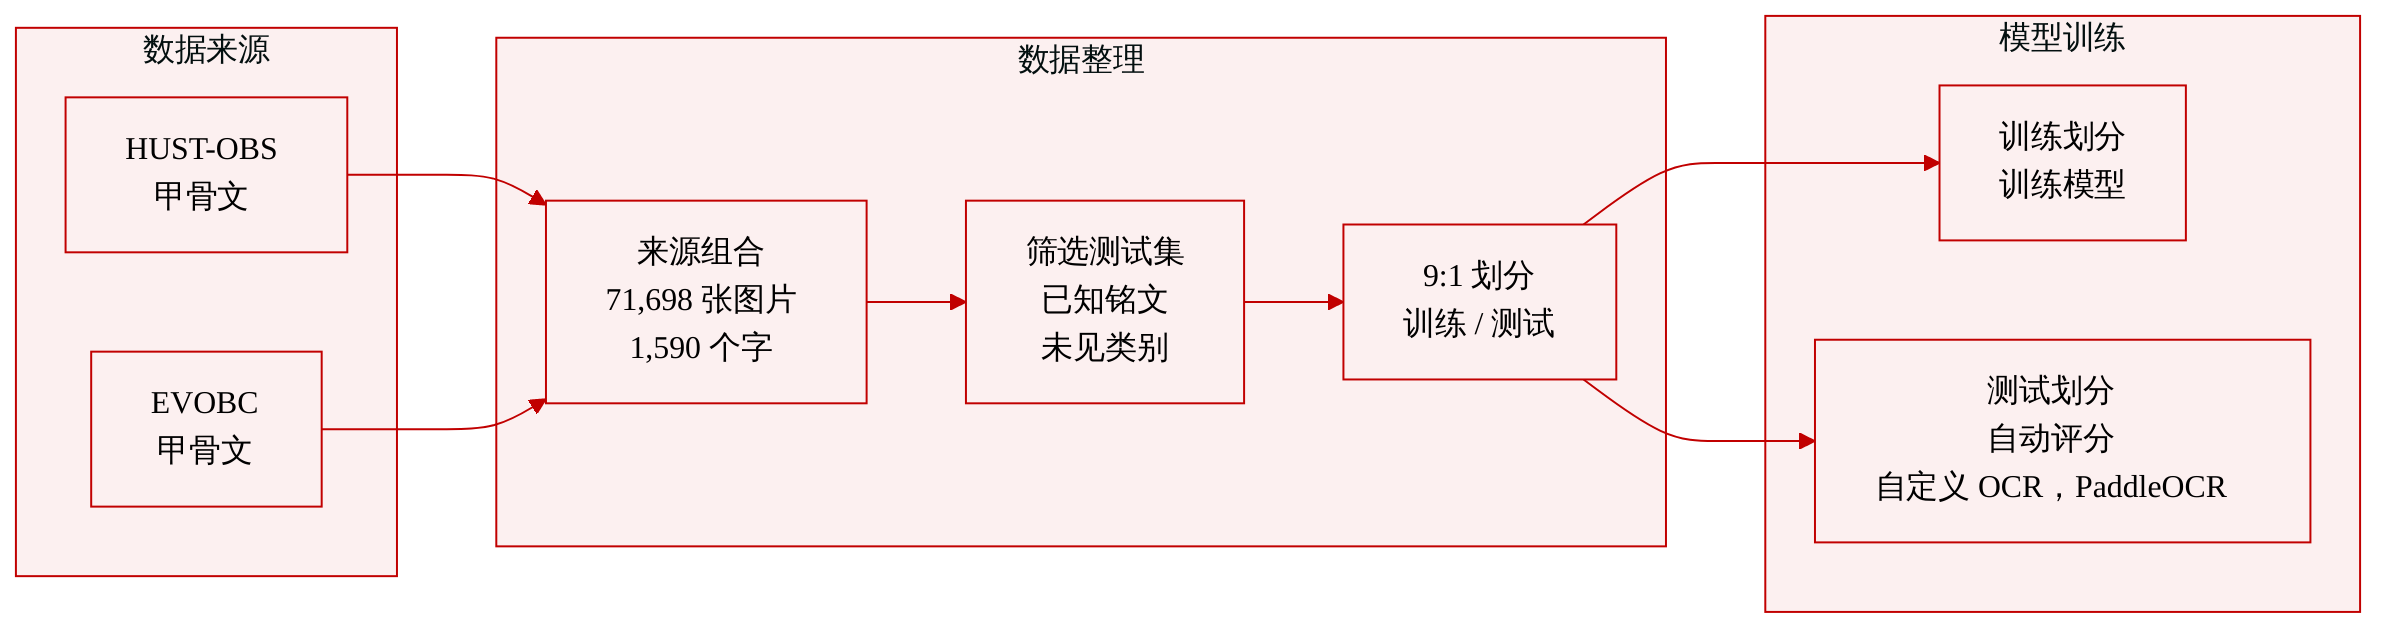
作者使用 HUST-OBS 和 EVOBC 数据集来训练和评估其 Oracle Bone Script 破译模型。源仓库被描述为最大的 Oracle Bone Script 集合之一,包含 71,698 张图像,呈现 1,590 个不同字符。
-
测试时,作者使用已经破译的铭文,而不是未知铭文。这样可避免对测试集进行专家验证,并支持自动评分。测试集还经过筛选,使测试集中的字符类别不出现在训练集中,从而使未见类别上的评估更具挑战性。
-
数据按 9:1 的比例划分为训练集和测试集。较大的训练划分用于训练基于生成的破译模型,而互不重叠的测试划分用于客观评估。
-
在提供的文本中,除了 9:1 划分和用于测试的类别筛选之外,作者未描述具体裁剪策略、元数据构造或数据混合比例。
-
在评估方面,作者使用两个 OCR 工具,而不是常规图像相似度指标。其自定义 OBS-OCR 工具是基于 ResNet 101 的分类器,在现代汉字 88,899 个类别上训练,并报告 99.87% 的识别准确率。作者还使用 PaddleOCR 作为额外评估工具,使生成的破译结果能够自动与真实标签进行比较。
方法
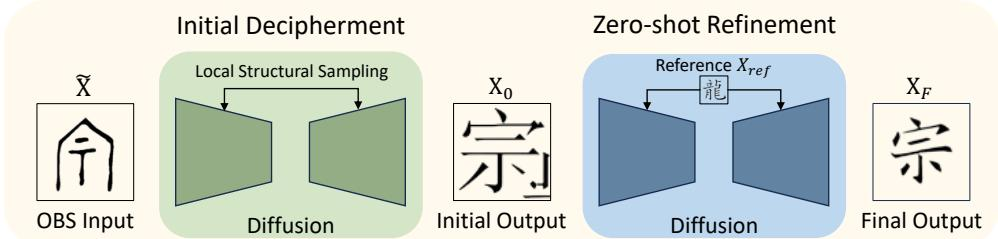
作者将 Oracle Bone Script 破译表述为条件图像转换问题:给定 Oracle Bone Script 图像 X~,目标是预测其对应的现代汉字图像。训练集包含配对 (si,ci),其中 si 是一个 Oracle Bone Script 实例,ci 是一个已知现代汉字。模型不应局限于精确类别匹配,而应提出能够解释此前未解铭文的现代字形。所提 OBSD 框架包括一个初始破译阶段,该阶段从 Oracle Bone Script 输入生成首个现代汉字图像;随后是一个 zero-shot 精炼阶段,该阶段利用参考现代汉字图像修正结构缺陷。参见整体流程:
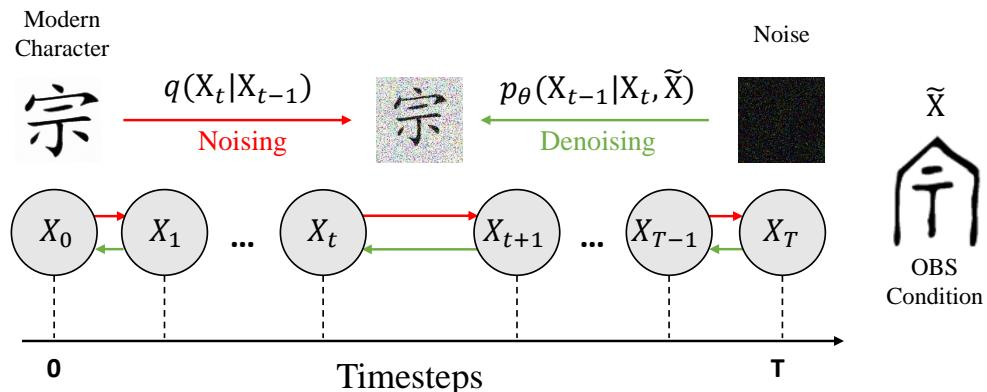
第一阶段的基础是条件扩散模型。训练时,将现代汉字图像视为目标干净图像 X0。正向噪声过程通过马尔可夫链逐步破坏 X0,使最终状态近似高斯噪声。完整正向过程写作
q(X1:T∣X0)=t=1∏Tq(Xt∣Xt−1),其中 T 是扩散步总数。每一步按
q(Xt∣Xt−1)=N(Xt∣αtXt−1,(1−αt)I),添加噪声,其中 αt 控制噪声强度,I 表示单位矩阵。累积噪声状态可直接表达为
Xt=γtX0+1−γtϵ,ϵ∼N(0,I),其中 γt 是步骤 t 之前 α 值的累积乘积。去噪 U-Net fθ 被训练为在 Oracle Bone Script 输入 X~ 和当前噪声状态 Xt 条件下预测注入噪声。训练目标为
L=Eϵ,γϵ−fθ(X~,Xt,γ)2.推理时,模型从高噪声状态 XT 开始,并逐步反转扩散过程。反向更新为
Xt−1=αt1(Xt−1−γt1−αtfθ(X~,Xt,γt))+1−αtϵt,其中 ϵt∼N(0,I) 引入随机性,以提升结果多样性。最终去噪图像 X^0 是初始破译输出。扩散过程如条件生成图所示:
尽管标准条件扩散在条件提供可直接利用结构时有效,但直接应用于 Oracle Bone Script 图像不足以准确合成现代字符。Oracle Bone Script 字形与其现代字形往往只共享部分视觉线索,因此全局条件扩散模型可能生成离散的笔画片段,而不是结构连贯的字符。作者通过将字符的全局结构演化与跨书写体系更稳定的部首局部组件进行比较来解决这一问题。参见结构比较:
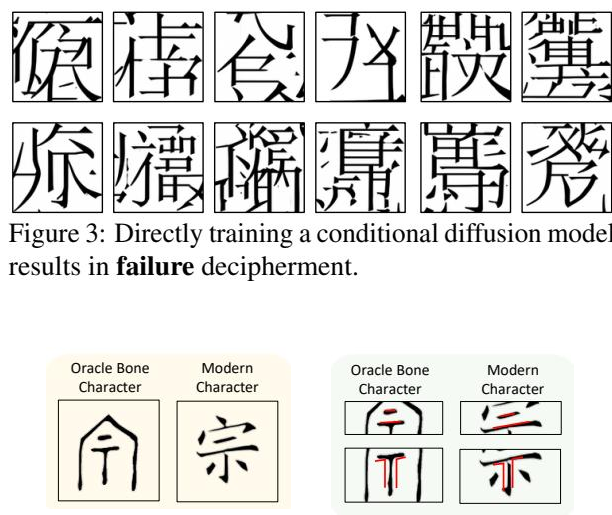
这一观察促使提出局部结构采样。该方法不强制扩散模型学习从 Oracle Bone Script 图像到现代字符的单一全局映射,而是将生成分解为逐 patch 局部转换。每个 patch d 由条件 patch 生成过程建模,
pθ(X0:T(d)∣X~(d))=p(XT(d))t=1∏Tpθ(Xt−1(d)∣Xt(d),X~(d)),去噪损失也随之变为以 patch 为导向:
ϵ^t(d)=fθ(Xt(d),X~(d),t),L′=Et,dϵ^t(d)−ϵt(d)2.推理时,输入 Oracle Bone Script 图像通过结构化滑动窗口布局划分为 patch。作者使用 patch 大小 64 和网格间距 16,使每个单元格容纳一组 16×16 的结构化 patch。通过以步长 16 水平和垂直移动窗口来提取 patch。重叠区域并非只在去噪后才进行修复。相反,会在每个时间步 t 对重叠部分进行平均,使共享区域在整个反向扩散轨迹中保持同步。这种感知时间步的平均操作可防止合并伪影,并保持独立采样 patch 之间的平滑过渡。完整初始破译训练和推理过程如流程图所示:
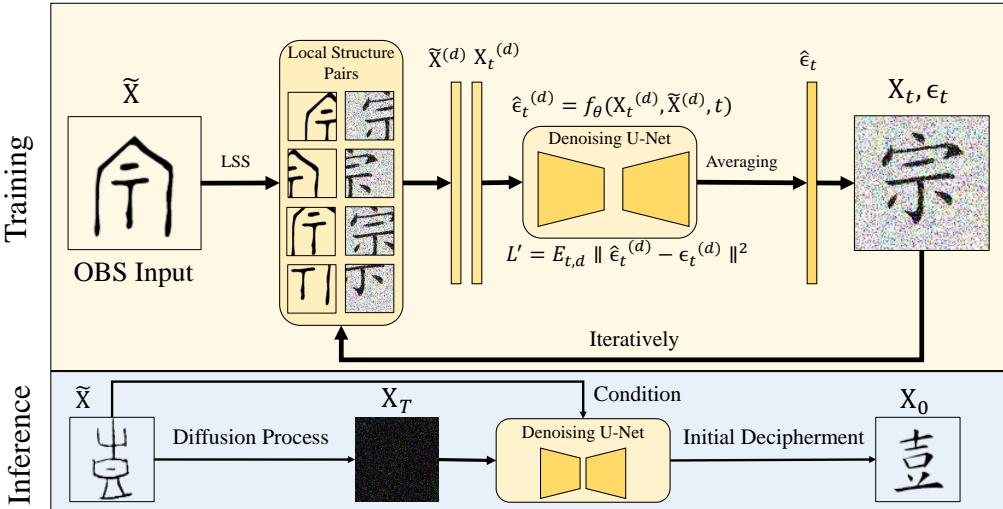
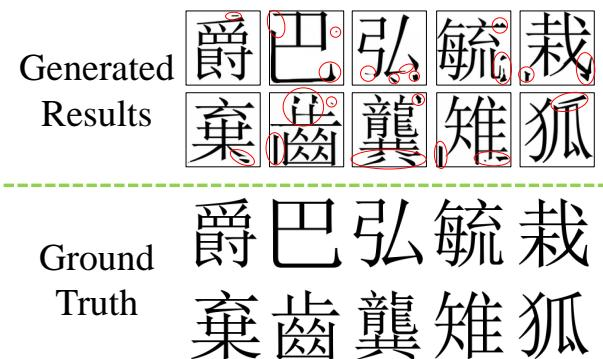
即使经过局部扩散,初始破译阶段仍可能产生笔画扭曲、组件断裂和噪声结构。这些缺陷源于许多 Oracle Bone Script 变体可能映射到同一个现代目标图像,而扩散训练期间可用的现代参考字形数量有限。作者将该问题视为多对一歧义,它会在初始生成阶段干扰生成模型。生成示例在如下图中表现出此类伪影:
为修正这些缺陷,作者引入 zero-shot 精炼模块。该模块仅在现代汉字字体样式转换上训练,而不在 Oracle Bone Script 到现代字符的配对上训练。该模块学习将一个现代字体样式转换为另一个现代字体样式,同时保留底层字符结构。作者使用多种现代字体训练该组件,并将训练任务表述为一对一样式到样式重建。推理时,使用参考现代汉字图像 Xref 对初始破译输出 X0 进行精炼,产生最终输出 XF。
精炼架构遵循带有双编码器的字体样式转换框架。样式编码器 Es 从参考图像 Xref 中提取样式特征。内容编码器 Ec 从源图像 X0 和参考图像 Xref 中提取多尺度内容特征:
F0={f01,f02,f03},Fref={fref1,fref2,fref3}.这些特征由专用 U-Net 处理,其中包含多尺度内容聚合块和参考结构交互块。其目标是将源图像的结构意图迁移到目标样式,同时避免内容漂移。
使用交叉注意力将源内容特征与参考结构对齐。对于每个特征尺度,展平后的参考特征和源派生特征被投影为 query、key 和 value 向量:
Sref=flatten(frefi),Ss=flatten(oi), Q=Φq(Sref),K=Φk(Ss),V=Φv(Ss),其中 oi 表示从源内容和样式信息获得的 U-Net 特征,Φq、Φk 和 Φv 是线性投影函数。注意力特征计算为
Fattn=softmax(dkQKT)V,变形偏移由前馈网络预测:
δoffset=FFN(Fattn).最终图像特征通过预测偏移对源特征应用变形卷积来渲染:
If=DCN(oi,δoffset).由于精炼阶段适配单一目标字体样式,作者简化原始框架,省去样式对比精炼及其相关对比损失。训练转而使用偏移正则目标,
Loffset=mean(∥δoffset∥),该目标会惩罚过大的变形偏移,并鼓励结构稳定的样式迁移。训练完成后,精炼模块直接应用于初始扩散输出,并利用参考现代汉字图像来恢复缺失笔画、修正扭曲组件,并生成最终破译的现代字符。
实验
在保留的 Oracle Bone Script 类别上的实验使用两个 OCR 工具评估生成的现代字符破译结果,并测试单轮性能、多轮迭代、组件消融和定性重建质量。结果表明,OBSD 优于经过改造的 GAN 基线和通用图像翻译基线;这些基线通常生成不完整或结构混乱的字符。多轮尝试提升了现实破译工作流中的稳健性。消融和定性分析证实,局部结构监督和 zero-shot 精炼对于生成连贯笔画和结构非常重要,这表明基于图像的生成式建模可以支持 Oracle Bone Script 语言破译,包括对未破译样本提供线索。
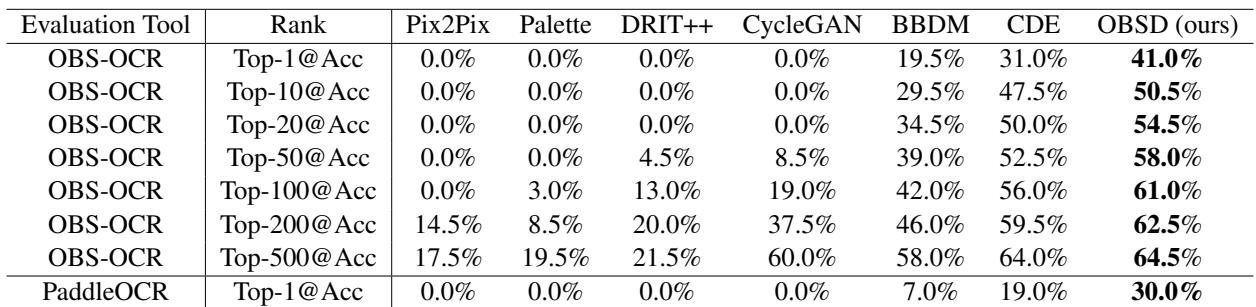
所提方法在所有报告的排名设置下均取得最高 OBS-OCR 准确率,表明其即时破译性能和宽松破译性能均强于所比较的图像到图像翻译方法。其准确率随排名扩大而稳步提升,并在最大排名截止值处达到最佳结果。基于扩散的基线是最接近的竞争者,而基于 GAN 的方法在低排名时明显较弱,只有当考虑更大候选集时才会有所提升。所提方法在 Top-1 准确率上领先,并在 Top-500 准确率上仍保持最佳。识别准确率通常随允许排名增加而提升。在该任务中,基于扩散的方法比基于 GAN 的方法性能更强。
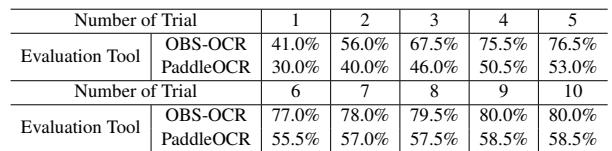
OBSD 多轮破译结果表明,允许连续尝试会稳定提升 Top-1 成功率。OBS-OCR 和 PaddleOCR 在多次试验中均有提升,而 OBS-OCR 达到平稳状态的水平远高于 PaddleOCR。这一现象表明,迭代破译为两种自动评估器都带来累积增益。成功率在多次试验中上升,而非停留在单次尝试水平。在整个多轮评估中,OBS-OCR 始终比 PaddleOCR 报告更高准确率。后期试验中的增益变小,表明该方法正在接近稳定的破译上限
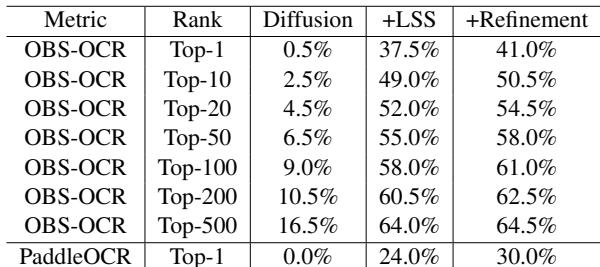
消融研究表明,基本扩散模型在 Oracle Bone Script 破译上表现较差,主要生成无法解释的输出。加入 LSS 模块会显著提升识别准确率,尤其是在 OBS-OCR 和 PaddleOCR 的 Top-1 结果上。加入 zero-shot 精炼会在所有评估的排名阈值上进一步提升性能。基本扩散模型给出非常低的识别准确率。LSS 模块显著提升破译准确率。zero-shot 精炼在 LSS 结果之上带来一致增益。
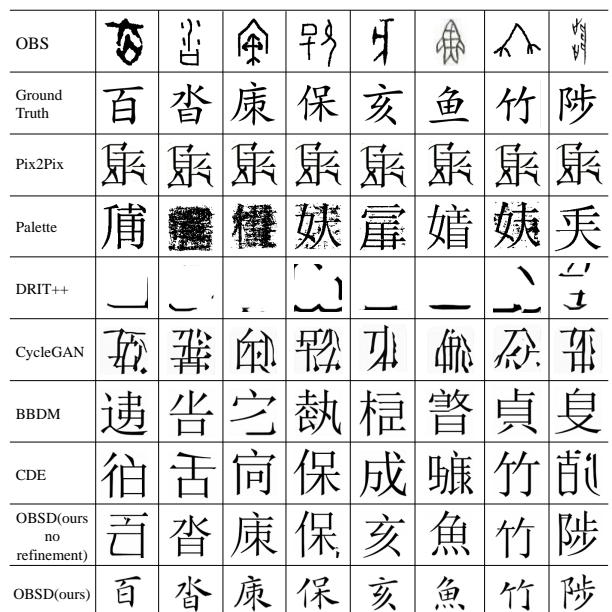
该表展示了将 Oracle Bone Script 翻译为现代汉字的图像到图像转换定性比较。OBSD 比所比较基线生成更完整、更具区分性、结构更连贯的字符重建。相比之下,一些基线会产生过度统一的输出,或碎片化且无法识别的字符。OBSD 生成的现代汉字更接近真实标签。Pix2Pix 在不同输入上产生高度统一的输出。DRIT++ 经常无法形成完整且可识别的字符。OBSD 更好地保留了精细字符笔画和结构。
在基于排名的破译准确率、多轮评估、组件消融以及定性字符重建比较中,所提方法始终优于扩散基线和 GAN 基线。随着允许更多候选排名,识别性能提升,连续破译尝试带来累积但逐渐减弱的增益。消融结果表明,基本扩散模型较弱,而 LSS 模块和 zero-shot 精炼分别提供显著且递进的改进。在定性方面,该方法生成更完整、结构更连贯的 Oracle Bone Script 到现代汉字翻译,优于竞争模型。