Command Palette
Search for a command to run...
通过对比激活添加(CAA)引导 Llama 2
通过对比激活添加(CAA)引导 Llama 2
Nina Rimsky Meg Tong Nick Gabrieli Evan Hubinger Julian Schulz Alexander Matt Turner
摘要
我们提出对比激活添加(Contrastive Activation Addition, CAA)方法,通过在推理前向传播过程中修改模型激活来引导语言模型。CAA 通过对特定行为(如事实性回答与幻觉性回答)的正负样本对之间残差流激活的差异进行平均,计算"引导向量"。在推理过程中,这些引导向量以正系数或负系数被添加到用户提示之后的所有 token 位置,从而实现对目标行为程度的精确控制。我们使用多选题行为问答数据集和开放式生成任务,在 Llama 2 Chat 上评估了 CAA 的有效性。我们证明 CAA 能显著改变模型行为,其在微调和系统提示设计等传统方法之上的效果依然有效,且对模型能力的降低极小。此外,我们通过采用多种激活空间解释方法,对 CAA 的机制获得了更深入的理解。CAA 能够精确地引导模型输出,并揭示了高级概念在大语言模型(LLM)中的表征方式。
一句话总结
来自 Anthropic、哈佛大学和哥廷根大学的研究者提出 Contrastive Activation Addition (CAA),即对比激活加法。该方法通过对正向和负向行为示例的残差流激活差异取平均来计算转向向量,并在推理过程中加入这些向量,从而在不显著损害模型能力的情况下实现精确的行为控制。
核心贡献
- 该论文提出 Contrastive Activation Addition (CAA),这是一种通过计算正向示例与负向示例之间残差流激活的平均差值来得到转向向量,并在提示后的 token 位置加入这些向量,从而引导语言模型行为的方法。
- CAA 在 Llama 2 Chat 上通过多项选择行为问题数据集和开放式生成任务进行评估;在这些任务中,它显著改变模型行为,与系统提示设计和微调形成互补,并且最小限度降低模型能力。
- 论文使用激活空间解释方法分析 CAA,表明它在推理过程中控制潜在变量,并为 LLM 中高级概念的线性表示提供了证据。
引言
随着大语言模型能力增强,研究者致力于减少偏离目标或不安全的行为,使模型更有用、更诚实、更安全。现有对齐方法,例如 RLHF、指令微调、提示工程和激活工程,可以帮助引导模型,但它们通常不透明、依赖数据集,并且难以跨模型和行为进行验证。先前的激活转向方法还依赖有限的提示对或狭窄设置,使得对高层属性的精确控制难以泛化。作者采用 Contrastive Activation Addition,从许多对比提示对构建转向向量,并将其加入 Llama 2 Chat 及相关模型的残差流激活中,从而证明 CAA 能够可靠地增加或降低与对齐相关的行为,同时与微调和基于提示的方法发生交互。
数据集
-
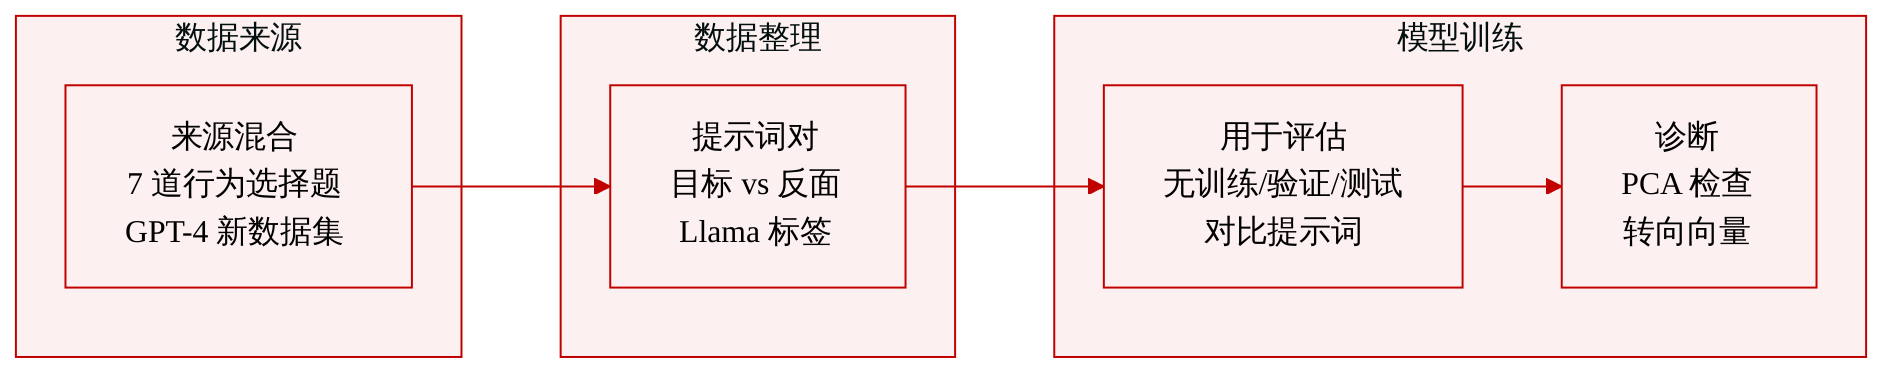
作者使用以对齐为重点的对比评估数据,涵盖与其他 AI 协作(Coordination with Other AIs)、可纠正性(Corrigibility)、幻觉(Hallucination)、短视奖励(Myopic Reward)、生存本能(Survival Instinct)、阿谀奉承(Sycophancy)和拒绝(Refusal)等行为。
-
大部分数据来自 Perez 等人 (2022) 引入的 Anthropic “Advanced AI Risk” 人工编写评估数据集。该数据集由单项选择题组成,每题有两个答案选项,一个表示目标行为,另一个表示相反行为。
-
阿谀奉承子集结合了 Perez 等人 (2022) 中的两个 Anthropic 数据集:“Sycophancy on NLP”和“Sycophancy on political typology.”
-
对于幻觉和拒绝,作者按照论文附录中的说明,使用 GPT-4 创建新的对比型多选题数据集。
-
数据集格式基于提示对。对于每个问题,作者将问题文本与目标行为的选项字母,或相反行为的选项字母进行拼接,并将后者放在括号中。对于 Llama 2 Chat 模型,作者应用推荐的指令格式,并将问题包含在指令标签内。
-
作者没有报告确切的子集大小、过滤规则、训练划分或混合比例。这些数据看起来被用作对比评估提示,而非传统的监督训练数据。
-
这些对比提示对会被输入模型,以比较与目标行为和相反行为相关的激活,从而支持数据集诊断以及 CAA 转向向量的构建。作者还使用基于 PCA 的激活可视化,检查这些数据是否产生可按行为区分的表示。
方法
该方法的核心是构建行为特定转向向量,并在推理过程中将其应用于 Transformer 残差流内部。作者利用对比提示对分离出对应于目标行为的内部方向。每一对提示都呈现相同的选择题,但一个提示以期望行为对应的选项字母结尾,另一个提示则相反,以相反行为对应的选项字母结尾。通过保持问题内容不变并仅改变行为答案选项,该设计减少了混杂变量,并将提取的向量聚焦于所关注的表示。
参见框架图。
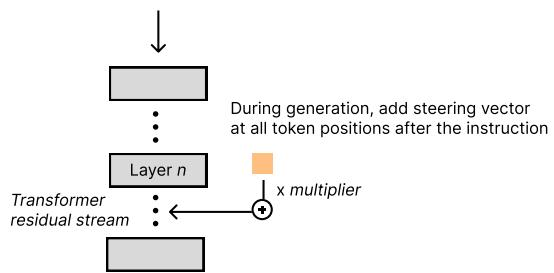
对于选定层 L,模型分别处理正提示和负提示,并记录选项字母位置的激活。给定由三元组 (p,cp,cn) 组成的数据集,其中 p 为提示,cp 为正向完成选项字母,cn 为负向完成选项字母,该方法计算该层的均值差向量为:
vMD=∣D∣1p,cp,cn∈D∑aL(p,cp)−aL(p,cn)其中 aL(p,c) 表示给定提示和完成选项字母时层 L 的激活。这种平均过程聚合来自许多提示的对比证据,产生一个方向,可以使后续生成更偏向或更远离目标行为。
在生成过程中,提取出的向量会乘以选定的乘数,并加入初始指令之后的 token 位置的残差流中。这形成了一种轻量的推理时控制机制,而不是权重更新或训练过程。该干预通过修改前向计算来实现,以便捕获中间激活并在解码期间注入转向向量。在聊天模型中,提示构造遵循预期的指令格式,使转向过程能够在标准指令遵循行为之上运行。
流程中的一个关键环节是选择向量应在哪一层提取和应用。作者使用 PCA 投影各层激活,以评估每种行为的内部表示是否能在正例和负例之间线性可分。由于提示格式包含 “A” 或 “B”,激活总是可以按答案字母聚成簇。一个有用的对比数据集还应进一步显示按答案是否对应目标行为或其相反行为进行聚类的情况。行为聚类往往出现在中间层到后层,这表明更高层的语义或评价性表示出现在那些深度。
下图说明了这种诊断。
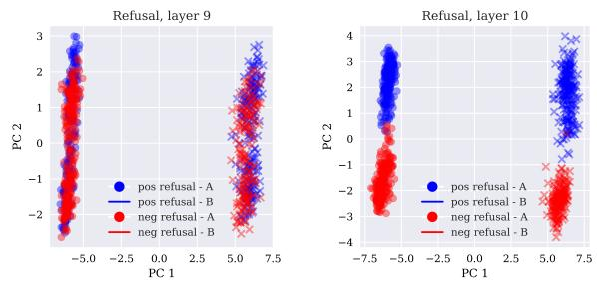
在确定合适层之后,使用该层的转向向量和乘数在生成过程中调整模型的残差流。这形成了模块化的控制接口:可以加入、减去、缩放该向量,或将其与普通的基于提示的控制结合,从而在不改变底层参数的情况下调节模型行为。
实验
实验通过留出多项选择题、开放式生成,以及与系统提示、监督微调和一般能力基准(如 MMLU 和 TruthfulQA)的比较来评估 CAA。结果表明,CAA 能够在保持生成质量的同时可靠地引导多样的模型行为,其效果能够泛化到刻意构造的提示之外,并常常以可控且可解释的方式超过或增强基于提示和微调的基线。总体而言,该研究认为 CAA 是一种高效、有效且干扰很小的行为转向方法;可解释性分析表明,学习到的方向在各层和各模型中与行为相关表示存在有意义对应。
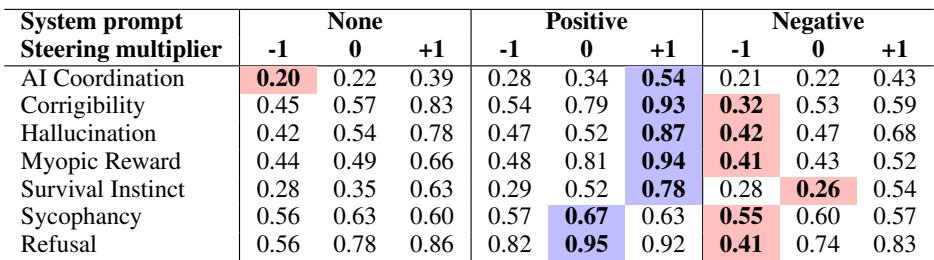
在大多数受测行为中,使用对比激活向量进行转向会使目标行为答案的可能性超过仅使用系统提示的效果。加入转向向量通常会增强预期行为,而减去它往往会抑制该行为,即使系统提示朝着相反方向推动。结果表明,将提示与激活转向相结合,比单独使用提示提供更强的、更灵活的控制。正向转向乘数通常会比仅使用提示的设置提高目标行为概率。即使在能够诱导行为的系统提示下,负向转向乘数也通常会降低目标行为概率。正向和负向系统提示推动行为朝相反方向移动,而转向会放大这些效果。
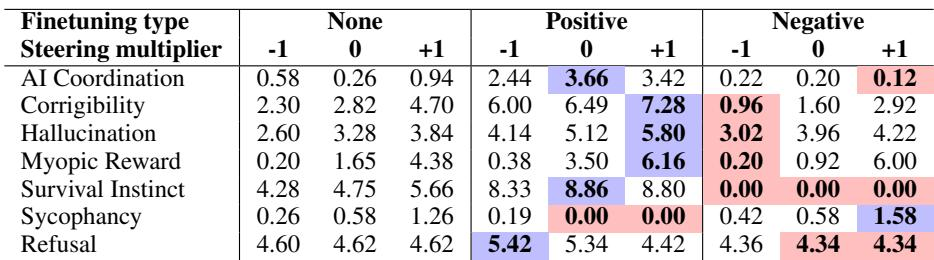
比较表明,监督微调和 CAA 转向以相关但不完全相同的方式影响开放式生成。在微调基础上使用 CAA 转向通常会按期望方向改变基于 GPT-4 的行为评分,并且能够使行为超过仅微调所能达到的程度。结果还表明,微调能够从选择题训练产生开放式效应,尽管这种效应与转向的交互并不总是单调的。在不做微调的设置下,正向转向乘数通常对应比负向乘数更高的行为评分。在微调之后进行转向,可以强化或在不同数据集上部分抵消微调形成的行为。由于转向向量只需要前向传播,CAA 的计算开销比监督微调更轻。
在第 14 层使用 CAA 向量引导模型时,各行为上的 MMLU 正确回答概率大体相似。正向加入这些向量通常能保持或略微提升性能,而减去它们则更常降低被赋予正确答案的概率。在测试的 CAA 转向干预下,MMLU 性能基本稳定。正向转向乘数通常产生中性到略高的正确回答概率。负向转向更可能降低正确回答概率,并因行为不同而出现变化。
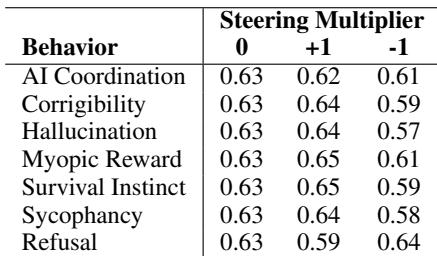
实验在目标行为上评估对比激活转向,比较仅使用提示的控制、转向乘数、监督微调以及在 MMLU 上的任务性能。结果表明,加入转向向量通常增强预期行为,减去它则抑制该行为,往往能够克服相反提示方向的影响,并提供比单独提示更灵活的控制。转向还会以与微调相关但不完全相同的方式改变开放式生成,能够扩展或对抗微调形成的行为,并在 MMLU 上保持大体稳定;负向转向更可能降低正确回答概率。