Command Palette
Search for a command to run...
语言复杂度与语音识别准确率:正字法复杂度有害,音系复杂度无害
语言复杂度与语音识别准确率:正字法复杂度有害,音系复杂度无害
Chihiro Taguchi David Chiang
摘要
本文研究影响自动语音识别(ASR)模型性能的语言学因素。我们假设正字法复杂度和音系复杂度均会降低识别准确率。为验证该假设,我们在涵盖 15 种书写系统的 25 种语言上对多语言自监督预训练模型 Wav2Vec2-XLSR-53 进行微调,并比较其 ASR 准确率、字素数量、单字素熵、语素文字度(书写系统对词/语素级信息的编码程度)以及音素数量。结果表明,较高的语素文字度与较低的 ASR 准确率显著相关,而音系复杂度与准确率之间不存在显著相关性。
一句话总结
圣母大学的研究人员对 Wav2Vec2-XLSR-53 在覆盖 15 种文字系统的 25 种语言上进行了微调,并发现较高的表意文字性,一种正字法复杂度度量,与下降的 ASR 准确率相关,而音系复杂度则未显示强相关性。
核心贡献
- 该研究在 25 种语言和多种文字系统上微调 Wav2Vec2-XLSR-53,并将 ASR 准确率与字素数量、单字素熵、表意文字性和音素数量进行比较。
- 该研究将正字法复杂度与音系复杂度分离,使用音素到字素模型的注意力分散度测量表意文字性,并将其与音系库大小进行比较。
- 结果显示,字符错误率与正字法复杂度强相关,尤其是表意文字性和字素库大小,而音系库大小未显示显著相关性;复杂的正字法还会导致更慢、更不稳定且更不精确的学习。
引言
自动语音识别需要能够在书写系统和语音系统难度不同的语言之间工作,这对构建包容性且面向低资源场景的语音技术很重要。先前的多语言 ASR 工作通过自监督预训练提升了性能,但尚未清晰区分正字法复杂度,例如大型字素库和表意文字性,如何影响微调后的准确率,尤其是在预训练数据可能使评测产生偏差的情况下。作者利用 Wav2Vec2-XLSR-53 在 25 种语言和 15 种正字法上的微调,检验字素库大小、表意文字性和音素库大小是否会降低 ASR 准确率。其结果表明,正字法复杂度与更高的字符错误率强相关,而音系库大小则不然,这提示这些模型更容易适应语音系统,而不是复杂的文字系统。
数据集
-
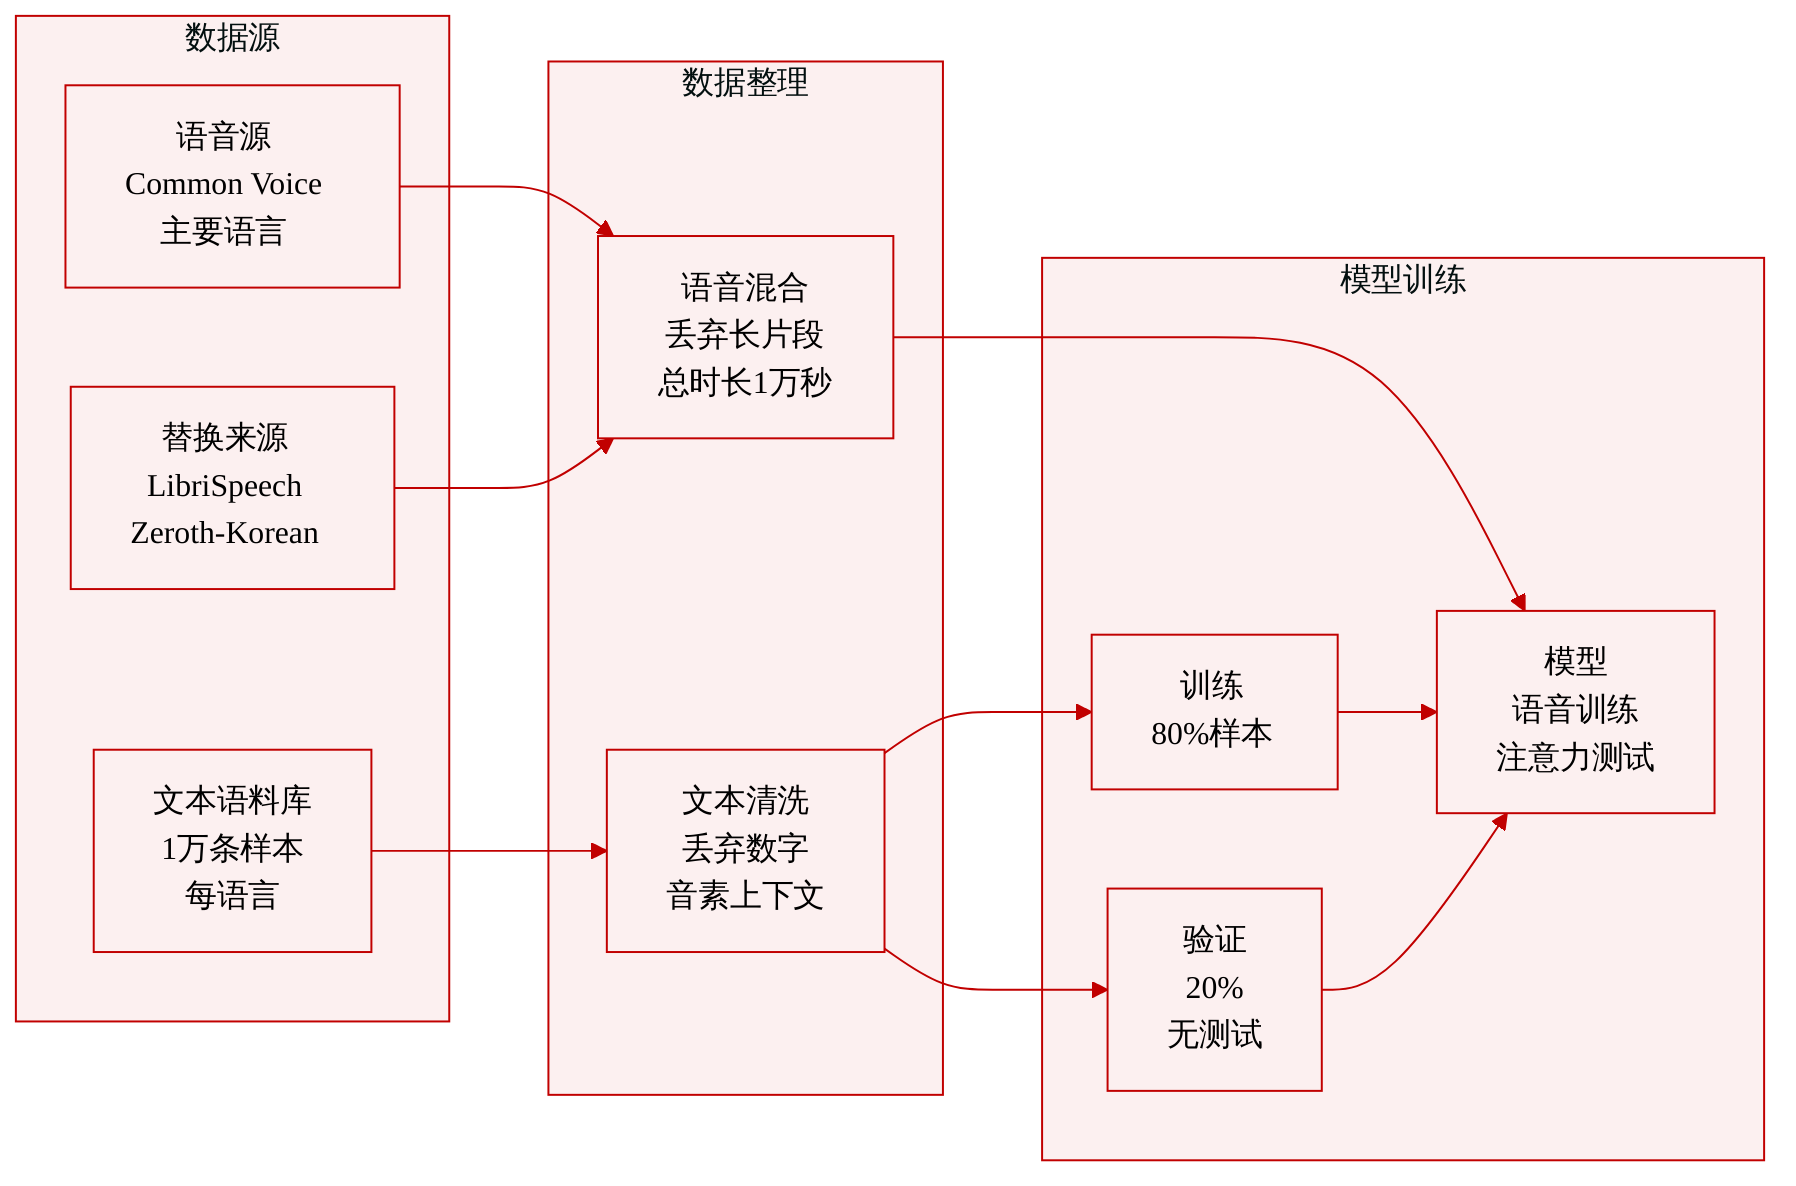
语音训练语料主要由 Common Voice 16.1 构建,除英语和韩语外的所有受考察语言均如此。作者用 LibriSpeech 替换英语,因为 Common Voice 英语包含许多非母语语音样本,并用 Zeroth-Korean 替换韩语,因为 Common Voice 16.1 的韩语子集样本不足。
-
由于 LibriSpeech 和 Zeroth-Korean 允许的最大音频长度比 Common Voice 16.1 更长,因此过滤掉过长的音频样本。在每个实验设置中,作者持续提取训练样本,直到总音频时长达到 10,000 秒,通过语音时长而非样本数量标准化数据集规模。
-
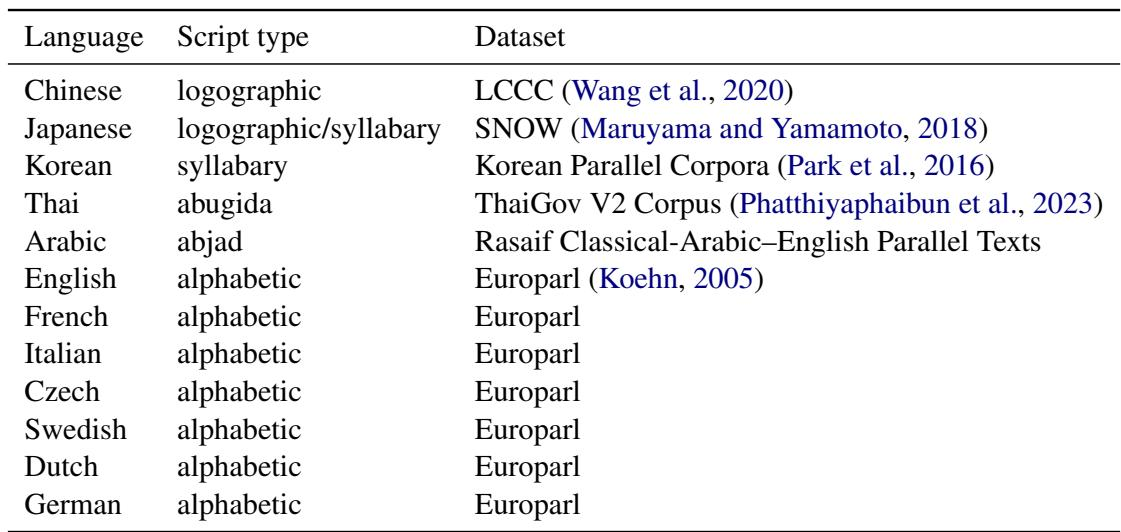
对于表意文字性分析,作者使用表 1 中列出的特定语言数据集,这些数据集涵盖不同文字系统的语言。对于每种语言,作者提取 10,000 个样本,并将其划分为 80% 训练集和 20% 验证集。由于该分析测量注意力扩展而非转录准确率,因此不创建测试集。
-
文本样本经过预处理,移除标点符号并省略包含数字符号的样本。音素序列方案包含 7 个 tokens:目标词左侧有 3 个上下文 tokens,中间为目标 token,右侧有 3 个上下文 tokens。目标词被
<TARG>和</TARG>包围,词边界由[SEP]标记,并且[START]和[END]分别添加到输入和输出序列的开头与结尾。 -
音素化由语言专用工具处理。日语、韩语和中文使用相同的转换器。泰语使用 PyThaiNLP 的转写模块进行罗马字转写。英语通过 eng-to-ipa 包使用 CMU Pronouncing Dictionary 进行音素化。其他字母文字语言和阿拉伯语使用 gruut 库转换为 IPA。
-
语音数据用于为特定语言语音实验创建长度受控的训练集。清理并音素化后的文本数据用于训练音素到正字法模型,并测量模型是仅关注局部发音还是关注周围上下文。
方法
所提出的实验流程整合了三个互补组件:一个多语言自监督语音骨干模型、一个监督式自动语音识别适配流程,以及一个用于不同文字系统音素到正字法依赖关系的独立测量框架。前两个组件面向 ASR 建模,而第三个组件量化可能有助于解释转录难度的一种语言特定属性。
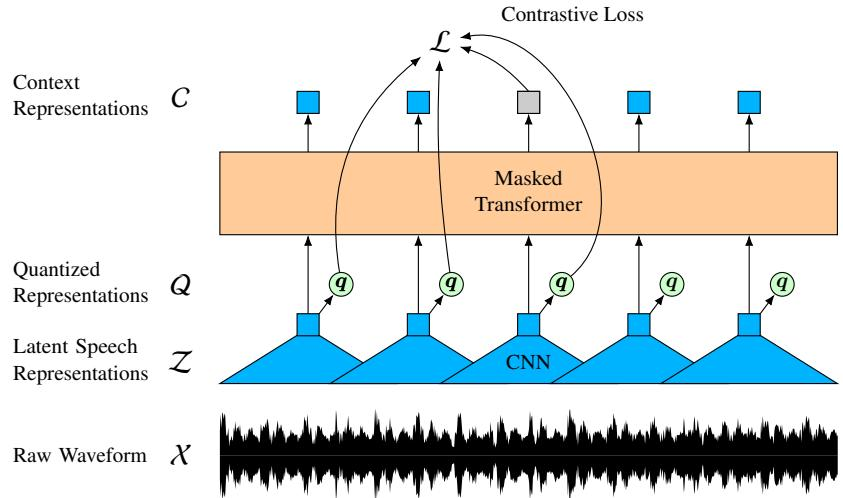
ASR 骨干模型是 Wav2Vec2-XLSR-53,它建立在 Wav2Vec 2.0 的自监督语音表示范式之上。在预训练阶段,原始波形 X 通过卷积特征编码器,以生成潜在语音表示 Z。这些潜在表示随后通过乘积量化映射为量化表示 Q。在训练期间,以固定概率对若干潜在表示槽位进行掩码。一个带掩码的 Transformer 接收这些损坏的潜在槽位,并预测上下文表示 C。学习目标使用对比损失,将预测的上下文表示与被掩码位置的正确量化向量以及不正确量化向量进行对比。该阶段使模型能够在没有转录文本的情况下学习语音表示。
如框架图所示:
在 ASR 微调中,预训练模型被适配到每个目标语言和文字系统。监督目标是连接时序分类,它将可变长度的声学帧与可变长度的正字法序列对齐。各设置复用相同训练配置,包括 20 个 epoch 和 0.0003 的学习率。训练前移除标点,以便模型关注语音到文本映射,而不是正字法切分。由于基础模型是自监督模型,而不是基于转录语音的弱监督模型,该实验设置降低了微调表现因目标语言是否已经出现在带标签预训练数据中而被严重偏置的可能性。
该流程还包括一个受控文字系统转换模块。作者不仅比较具有固定原生正字法的语言,还在同一语言上评估多种转录系统。对于日语,将默认的汉字和假名正字法与仅假名和仅罗马字表示进行比较。仅假名转录通过词形切分和转换获得,而仅罗马字转录通过将假名罗马字化生成。对于韩语,将标准谚文音节表示与 Hangul Jamo 表示进行比较,后者将每个谚文音节分解为音位成分。对于中文,将标准汉字表示与注音符号和拼音进行比较。这些转换在预处理期间确定性地执行,因此模型性能差异可以与字素库和字符级变异性相关联,而不是与底层语音数据的变化相关联。
为了刻画文字系统复杂度,使用两个字素相关度量。第一个是训练数据中观察到的不同字素类型总数。第二个是训练数据的单字符熵,它考虑了字符频率不均的情况。该熵计算如下
H(C)=−c∈C∑p(c)logp(c),其中 C 是语料库中的字符类型集合。该熵度量很重要,因为许多文字系统并不均匀分布字符;相反,高频字符主导分布,而低频字符可能以增加有效学习负担的方式影响训练,简单的类型计数可能会高估或低估这种负担。
第二个主要组件估计表意文字性,此处定义为词的拼写形式在多大程度上依赖周围上下文,而不是仅可由发音预测。为了估计该属性,作者训练一个单独的音素到正字法序列到序列模型。模型接收一段较短的音素上下文,并预测被特殊标签包围的目标词的拼写形式。输入格式包括起始符号、周围音素、词边界标记、目标词标签和结束符号。音素上下文包含 7 个 tokens,目标词位于中间,其左右各有三个音素。该架构包含编码器和解码器。编码器包含嵌入层,随后是双向 GRU 层。解码器包含嵌入层、单向 GRU 层,以及接收来自编码器上下文向量的交叉注意力层。用于测量的注意力矩阵来自残差连接和层归一化之前的交叉注意力机制。
表意文字性得分来自移除与目标词相关联的注意力区域后剩余多少注意力。设 A 表示注意力矩阵,M 表示相同形状的二进制掩码矩阵。掩码后的注意力写作逐元素 Hadamard 积 M∘A。掩码将选定条目置零,从而抑制直接对应目标词的注意力质量。词 w 的注意力扩展则为
Sw=∑i,jAi,j∑i,j(M∘A)i,j.该量估计在目标词注意力区域被掩码后保留的注意力占总注意力的比例。较低的保留注意力表示模型主要依赖目标词自身发音,这符合表音文字系统的预期。较高的保留注意力表示对周围上下文有更强依赖,这符合更表意的文字系统,其中发音和拼写之间的直接映射程度较低。
语料库级得分对词级注意力扩展取平均:
Stoken=∣D∣∑w∈DSw,其中 D 是语料库中的目标词集合。掩码操作和由此得到的注意力分布可视化如下,其中原始注意力矩阵与目标词注意力值被抑制后的矩阵进行比较。
掩码操作可视化如下:
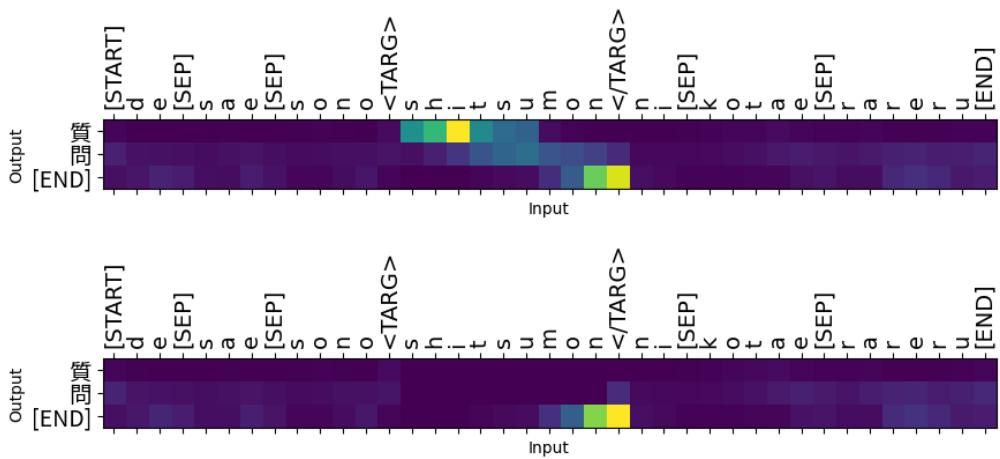
音素化通过适合相应语言的转换工具处理。日语、韩语和中文使用与字素转换模块相同的转换路径,而其他语言则使用成熟的音素化资源或 IPA 转换库转换为发音表示。该预处理确保表意文字性测量在不同语言上操作于可比较的音素上下文之上。
实验
实验使用微调后的多语言模型,在不同语言及替换文字系统上评估自动语音识别,尤其是日语、韩语和中文,以检验转录准确率是否受正字法复杂度或音系复杂度影响。它们使用字符级评估和时间校准误差度量,来比较不同字素库和书写规范。定性结果表明,表意或字素数量较大的文字系统会使学习和转录更困难,导致模型收敛更差且更慢,而音系复杂度几乎没有明显不利影响。校准误差度量还降低了仅由文字系统表示造成的差异,支持正字法在 ASR 表现中起主要作用的观点。
该表比较了具有不同文字类型的语言的数据集,包括表意文字、音节文字、元音附标文字、辅音字母文字和字母文字系统。所引用结果表明,更具表意性的文字系统和更大的字素库与更困难的自动语音识别行为以及更慢的学习相关联。表意和混合正字法与表音系统相比,给语音到文本转录带来更大难度。复杂的文字系统显示出不那么平滑的学习行为,并且相比更简单的正字法需要更多训练才能取得同等进展。
在各类文字系统中,更大的字素库以及更具表意性或以音节字符编码的表示与更高的字符错误率和更不稳定的学习相关联。音素类型数量与准确率未显示显著关系,而 CEPS 与正字法复杂度的一致性弱于 CER。英语据报告具有明显更低的错误率,这可能反映了更强的预训练暴露和更干净的朗读语音数据集。假名、罗马字、Hangul Jamo 和注音符号等表音替代表示相比对应的复杂字符系统具有更低错误率。CEPS 降低了由文字系统表示造成的明显惩罚,例如谚文音节与 Hangul Jamo 之间。正字法复杂度而非音系库大小解释了更多观察到的 ASR 准确率变化。
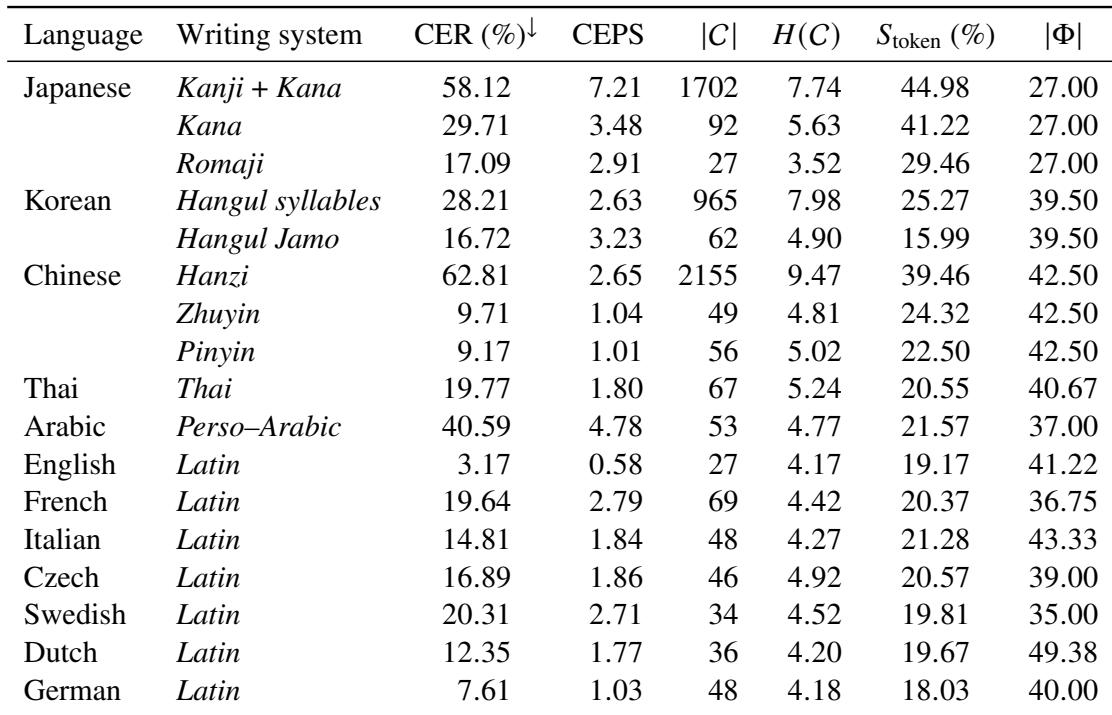
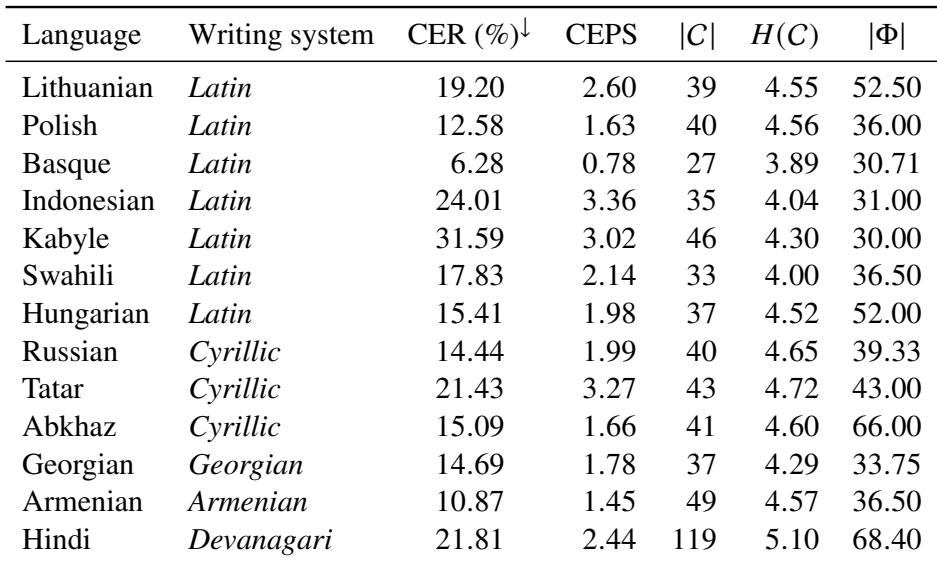
字符错误率与正字法复杂度呈正相关,其中字素库大小、单字符熵和基于 token 的表意文字性具有更强关联。相比之下,音素类型数量与字符错误率没有有意义的关系,这表明被评估的预训练模型对音系变化保持相对稳健。CEPS 指标与字符错误率相关,但与正字法复杂度的联系更弱,这表明它减少了文字系统表示差异造成的明显影响。更高的正字法复杂度与更高的字符错误率相关联。音素库大小似乎无法解释 ASR 误差差异。CEPS 与正字法复杂度的相关性弱于 CER。
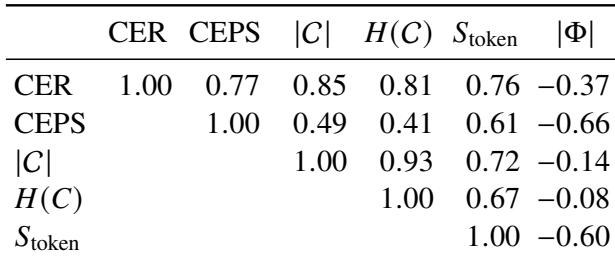
对于具有表音正字法的拉丁字母语言,ASR 误差在不同语言间变化,某些语言比其他语言更容易转录。表音指标倾向于遵循与 CER 相同的整体排序,这表明它反映的是相对转录难度,而不是音系复杂度。在这些语言中,字素库、熵和音素类型数量的差异并未显示出与性能之间清晰一致的关系。巴斯克语在该拉丁字母语言集合中比卡拜尔语和印度尼西亚语显示出低得多的误差。尽管使用拉丁字母,卡拜尔语在所列出语言中具有最高 CER。CEPS 值总体上与拉丁字母表音语言中的 CER 排名保持平行。
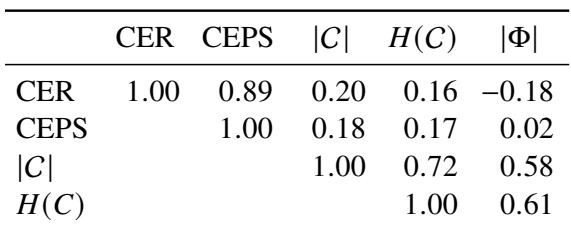
对于表音语言,字符错误率仅与字素数量和单字符熵等正字法度量呈现弱正相关。CEPS 得分与字符错误率强相关,这表明它在这些语言中反映了相似的难度模式。相比之下,在该设置中,音系复杂度与转录错误没有实质关系。CER 和 CEPS 强相关。正字法度量与 CER 呈现弱正相关。音系复杂度未显示出与 CER 的实质性相关。
实验评估文字系统类型和正字法复杂度如何影响跨语言自动语音识别。它们发现,表意、混合和字素库较大的文字系统通常更难转录,并表现出更不稳定的学习,而表音系统则更容易。总体而言,正字法复杂度比音素库大小更能解释表现差异,并且 CEPS 紧密追踪相对难度,同时降低了由文字表示造成的明显差异。