Command Palette
Search for a command to run...
SPZ:一种基于语义扰动与区域混合的阿尔茨海默病检测数据增强方法
SPZ:一种基于语义扰动与区域混合的阿尔茨海默病检测数据增强方法
Fangfang Li Cheng Huang Puzhen Su Jie Yin
摘要
阿尔茨海默病(AD)以显著的认知和功能障碍为特征,亟需发展早期检测技术。传统的诊断实践,如认知评估和生物标志物分析,通常具有侵入性且成本高昂。近期研究已探索了基于深度学习的非侵入式 AD 检测方法,但可获取数据的匮乏制约了检测性能的进一步提升。为应对上述挑战,我们提出了一种新颖的基于语义扰动的数据增强方法,该方法从根本上区别于主要依赖显式数据工程的现有技术。我们的方法通过生成受控的语义扰动来增强文本表示,帮助模型识别 AD 特异性语言模式,尤其在数据有限的场景下更为有效。该方法学习上下文信息,并针对不同语言特征动态调整扰动程度,从而增强模型对 AD 特异性语言特征的敏感性以及对自然语言噪声的鲁棒性。在 ADReSS 挑战赛数据集上的实验结果表明,我们的方法优于其他具有竞争力的深度学习方法。
一句话总结
中南大学、湘江实验室和悉尼大学提出了 SPZ,这是一种基于语义扰动并带有区域混合的数据增强方法。该方法生成可控扰动以增强文本表示,并针对不同语言特征动态调整扰动程度,从而在数据受限条件下实现更鲁棒的非侵入式阿尔茨海默病(AD)检测。
核心贡献
- SPZ 被提出为一种面向数据受限场景的非侵入式 AD 检测的语义扰动数据增强框架。该方法对既有文本施加可控扰动,无需人工数据工程。
- SPZ 将 Generator 与 Mediator 相结合。Generator 使用与温度相关的 Gumbel-Softmax 技巧,从 Gaussian 或偏态分布中生成 token 级扰动;Mediator 为每个词分配词级扰动概率。随后,方法通过区域混合将初始表示和噪声混合,以优化文本表示,同时保留原始语义并突出 AD 特有的语言模式。
- 在 ADReSS 挑战数据集上的实验表明,SPZ 优于强深度学习基线,说明可控语义扰动能够提升 AD 检测准确率和鲁棒性。
引言
阿尔茨海默病检测受益于自动语音和文本分析,因为 AD 患者通常表现出独特的语言模式,例如更多的填充词、更少的信息性名词和动词、句法组织混乱、停顿和犹豫。这一点很重要,因为传统认知测试和生物标志物分析成本较高且耗时,而基于语言的方法可以支持可扩展的早期筛查。以往工作受限于小规模标注数据、隐私问题,以及依赖随机删除、替换、改写或生成的数据增强方法。这些方法可能移除 AD 特定线索,引入增强偏差,需要人工数据工程,并降低模型泛化能力。作者提出了 SPZ,这是一个即插即用的数据增强框架。它不是创建新样本,而是对既有文本施加可控语义扰动。SPZ 使用 Generator 模块添加受温度控制的高斯噪声,并使用 Mediator 模块分配词级扰动概率,随后混合表示以保留原始语义,同时提高对 AD 特定特征的敏感性。该方法可在数据受限场景中提升 AD 检测效果,并在 ADReSS 数据集上取得有竞争力的性能。
数据集
-
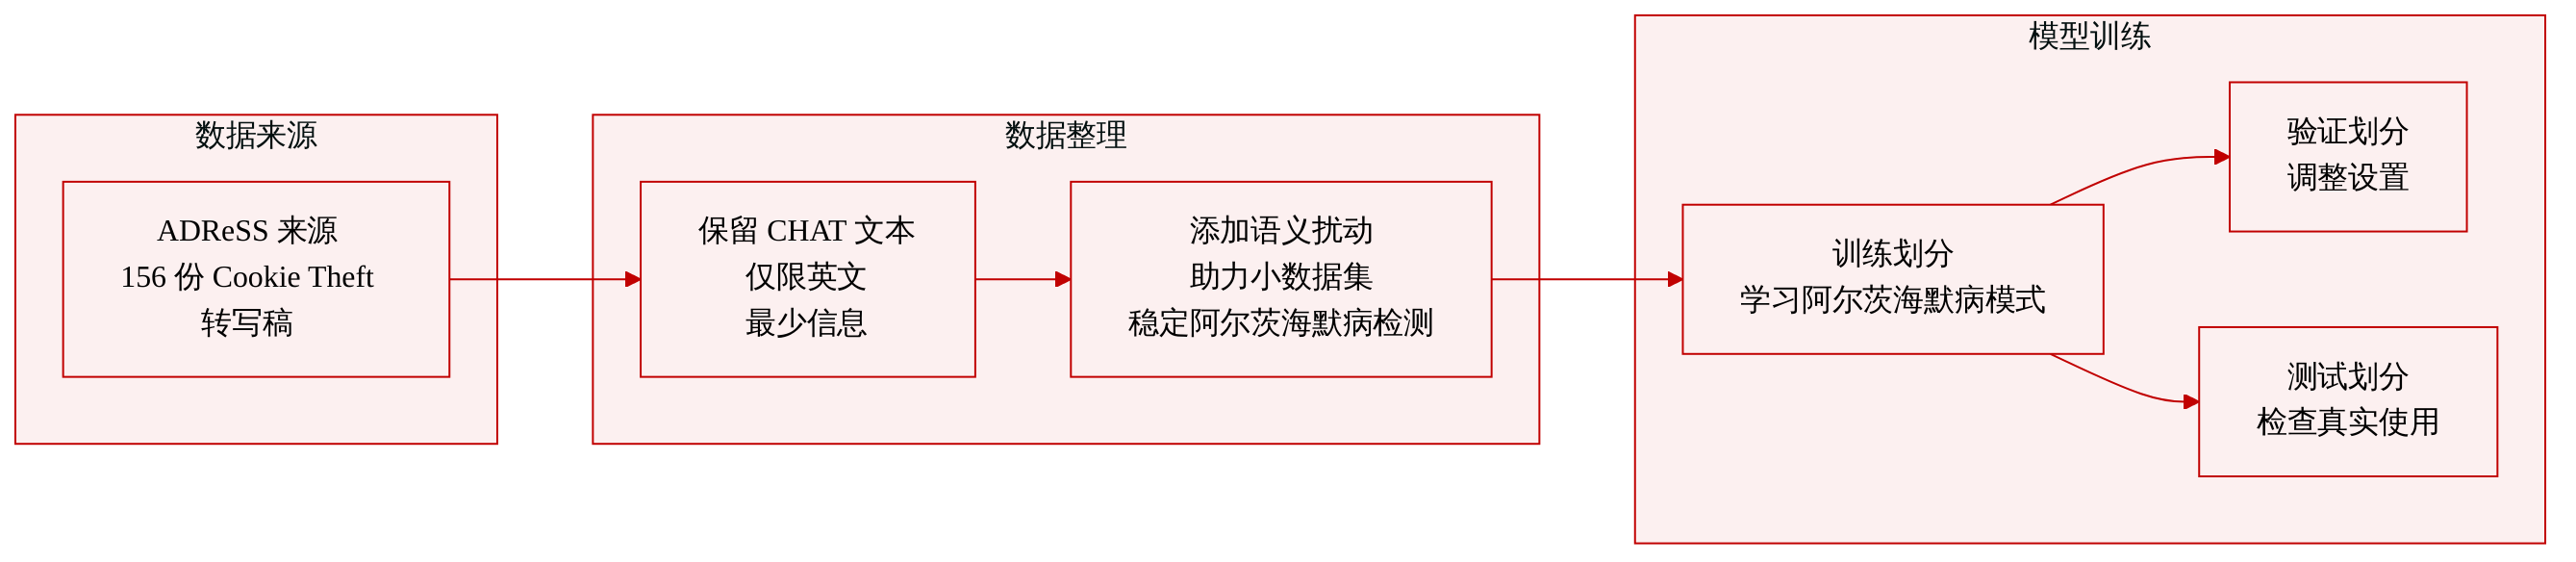
来源:作者使用 ADReSS 挑战数据集,这是 AD 检测的标准化基准。它包含 156 个英语使用者的语音样本及对应转写文本,任务为 Cookie Theft 图片描述。
-
组成:数据集包含 78 名非 AD 参与者和 78 名受 AD 影响参与者。每组各有 35 名男性和 43 名女性,因此在诊断状态和性别上分布均衡。年龄也被描述为均衡,但提供的片段未给出具体年龄段。
-
模态与模式:该研究仅关注转写文本数据,而非音频。转写文本采用 CHAT 协议格式化,CHAT 是 TalkBank 数据的标准格式。
-
元数据与标签:该数据集支持使用参与者诊断状态、性别和年龄相关元数据进行 AD 分类。均衡设计旨在降低预测任务中的潜在偏差。
-
数据规模与挑战:该数据集仅有 156 个样本,规模较小,部分原因在于采集难度和隐私问题。作者将这种有限规模视为构建鲁棒 AD 分类模型的核心挑战。
-
处理与增强:作者围绕文本转写构建训练设置。它们将可控语义扰动作为数据增强策略,用于在数据受限条件下提升文本表示和可靠性。提供的文本未说明划分比例或详细训练混合设置。
-
其他处理说明:提供的片段未描述裁剪、图像预处理或新元数据构建。主要处理步骤是使用 CHAT 格式化的转写文本进行 AD 检测。
-
伦理与来源背景:数据来自 ADReSS 挑战,并遵循严格协议,以最小化个人信息并控制访问。仅包含英语的转写数据限制了文化代表性,该工作定位为学术研究,而非直接临床部署。
方法
作者提出了带有区域混合的语义扰动方法,这是一种轻量级数据增强框架,用于改进数据受限场景下 AD 转写检测中的表示学习。该方法并不生成完全新句子,而是在 token 嵌入层面运作,并对已有语言表示引入可控语义扰动。该框架刻意保持简单、模块化和易于优化,同时仍促使分类器对 AD 相关语言模式更加敏感。
该架构可以理解为一个 BERT 编码骨干,后接三条信息通路。如下方框架图所示:
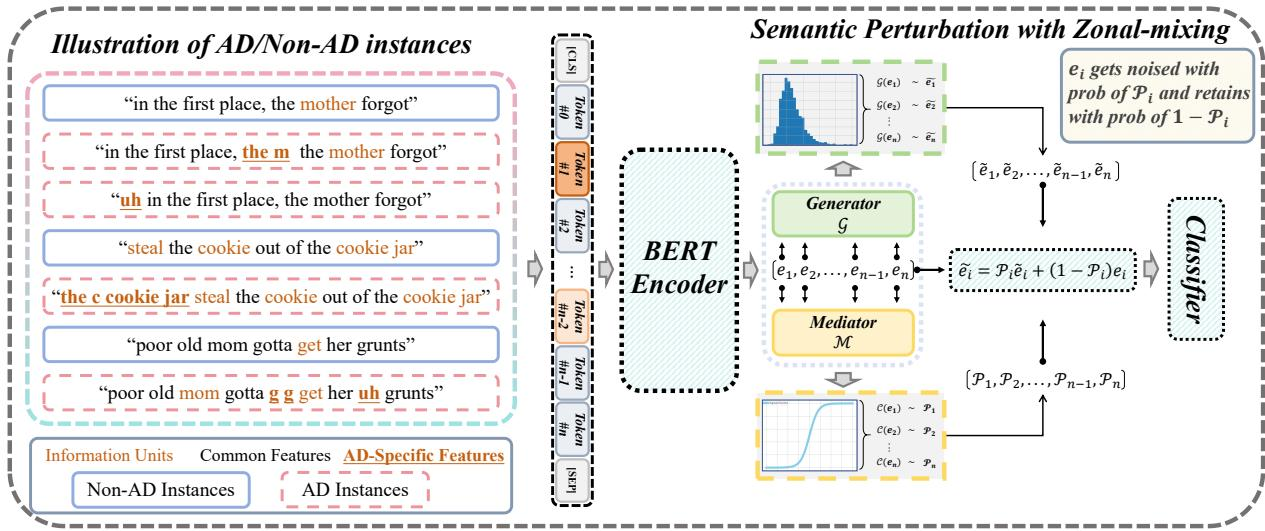
第一条通路将每段转写文本嵌入为 token 级表示,第二条通路为这些表示生成语义扰动,第三条通路学习每个 token 的扰动程度,最后一条通路将原始状态和扰动状态结合用于分类。
对于输入转写文本 T={t1,t2,⋯,tn},作者使用预训练 BERT 编码器作为文本编码器。与仅从 [CLS] token 进行分类的方法不同,该方法使用完整的 token 级输出,排除特殊 tokens [CLS] 和 [SEP]。编码过程为:
E=BERT(T)这会得到上下文化的 token 表示 E={e1,e2,⋯,en},其中每个 ek 捕捉对应词在转写文本中的语义上下文。使用全部 token 表示使模型能够保留关于常见特征、信息单元和 AD 特定线索的细粒度信息。
核心增强机制通过两个模块引入:Generator 和 Mediator。
Generator 用于生成比随机噪声更具结构化的扰动。对于每个 token 表示,方法首先从 Gaussian 分布中采样噪声:
U~={u~1,u~2,…,u~n}∼N(0,σ2)由于 Gaussian 噪声缺乏明确的语义方向,方法将其转换为 Gumbel 噪声:
g=−log(−log(u~+ε)+ε)扰动后的 token 表示随后通过低温度 softmax 获得:
ei′=∑j=1nexp{(ej+gj)/τ}exp{(ei+gi)/τ}其中 τ 控制分布的平滑度。在较低温度下,例如 τ=0.2,扰动会更极端且更具针对性,这有助于暴露可能与 AD 检测相关的特定语言元素。
Mediator 控制每个 token 应在多大程度上偏离其原始状态。它根据原始上下文表示计算连续扰动程度:
pi=1+exp{−(wi⋅ei+b)}1其中,pi 是 (0,1) 区间内的可训练标量,决定施加于 token i 的扰动强度。sigmoid 激活在原始状态和扰动状态之间提供平滑过渡,使训练更稳定。
随后,原始表示和扰动表示通过区域混合操作进行整合:
e~i=(1−pi)ei+piei′这得到最终增强后的表示 E~={e~1,e~2,⋯,e~n}。通过在训练过程中学习混合比例,模型能够自适应判断哪些 tokens 应更接近原始形式,哪些 tokens 应接受更强语义扰动。这种方式在保留大多数转写内容完整性的同时,选择性地增强对潜在有信息量的 AD 相关模式的敏感性。
最终分类器在混合表示上运行。全局最大池化层首先将 token 级信息聚合为固定长度向量,随后接一个 sigmoid 分类层:
z=GlobalMaxPooling(E~) y^=Sigmoid(z)输出 y^ 表示 AD 病例的预测概率。训练期间,作者最小化 binary cross entropy loss:
LBCE=−i=1∑Nyilog(y^i)+(1−yi)log(1−y^i)其中 yi 是真实标签。通过这种端到端优化,BERT 编码器、扰动生成器、Mediator 和分类器共同训练,从而学习对早期 AD 检测既鲁棒又更具判别力的表示。
实验
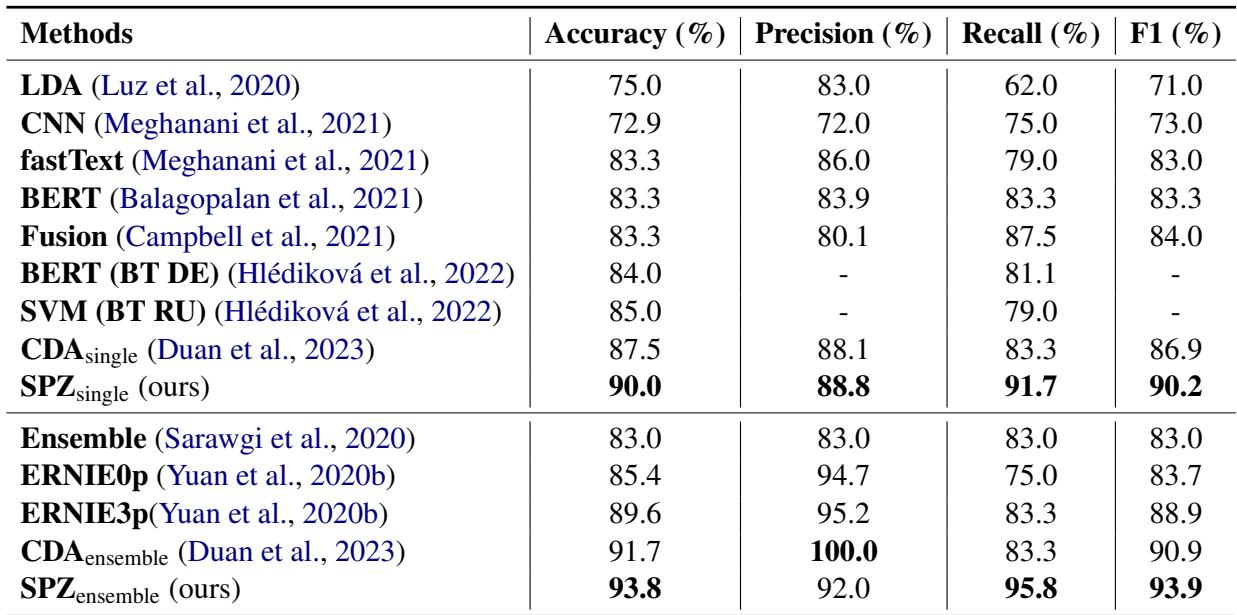
实验通过准确率以及 AD 类的精确率、召回率和 F1,评估 AD 检测效果。所有评估采用多个随机种子上的 10 折交叉验证,并将提出的 SPZ 模型与代表性单模型和集成基线进行比较。主要比较表明,相比标准判别模型和基于数据增强的方法,SPZ 受益于语义扰动和 token 级处理。消融实验显示,Generator 和 Mediator 都增强了 AD 检测效果。进一步的 Mediator 分析表明,扰动程度受到选择性控制:方法保留具有临床意义的 AD 相关语言,对信息量较低的特征施加更高扰动,并对非 AD 病例施加更大的整体扰动。
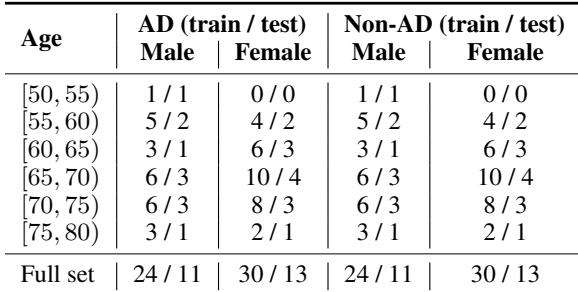
提供的数据集包含 156 个来自英语使用者的 Cookie Theft 图片描述样本,分为 AD 组和非 AD 组。年龄和性别统计显示,在每个男性和女性年龄分段内,AD 组和非 AD 组人数相同,这支持了类别表示平衡以及相对均匀的年龄覆盖。较小的数据集规模被视为鲁棒 AD 分类的一项挑战,也促使作者使用可控语义扰动进行数据增强。在所报告的每个男性和女性年龄分段内,AD 使用者和非 AD 使用者数量均等。多数使用者处于 65 至 75 岁年龄段,最年轻和最年长年龄段的样本较少。
提出的 SPZ 单模型在比较的 AD 检测方法中取得了最强整体性能,具有最高准确率、精确率、召回率和 F1 分数。比较方法差异较大,传统基线表现出较弱或不均衡结果,而数据增强可提升部分模型族。结果显示,SPZ 是该挑战数据集上的有效方法。SPZ 单模型在全部报告指标上均优于所列基线以及现有集成或增强方法。数据增强可提升部分模型,但增强后的方法在整体有效性上仍低于 SPZ 单模型。fastText 在召回率上表现出明显提升,而 BERT 及相关方法相比基线模型提供了更高准确率。
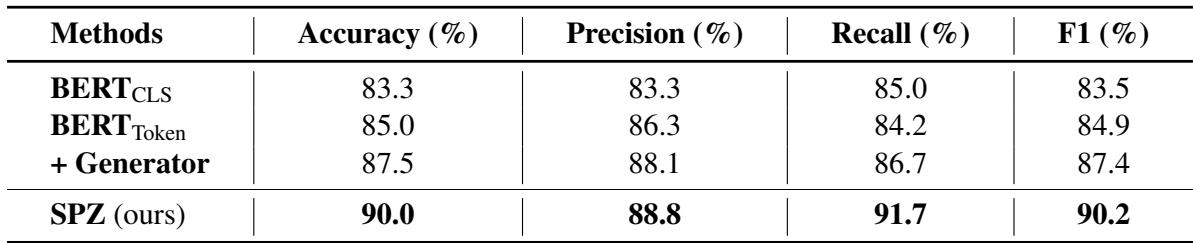
消融实验表明,token 级嵌入在多数指标上优于 CLS token 基线,说明细粒度表示有助于模型。加入 Generator 模块后,性能进一步提升,而包含 Mediator 的完整 SPZ 模型取得最佳整体结果,尤其体现在召回率上。token 级嵌入在准确率、精确率和 F1 上优于 CLS token 基线,但召回率略有下降。Generator 模块相对于 token 级 BERT 带来明显提升,尤其体现在精确率和 F1 上。完整 SPZ 模型取得了报告中最强整体性能,并具有最高召回率。
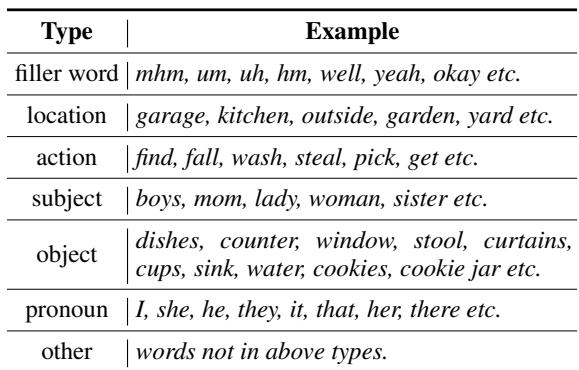
该表定义了七类转写文本词类型,用于分析 Mediator 模块如何扰动语言。它将临床重要内容,例如对象词、地点词和动作词,与区分度较低的形式区分开,例如填充词、代词、主语和其他词。周围分析表明,临床有意义的词被更强烈地保留,尤其在 AD 样本中。对象词、地点词和动作词被视为临床重要的转写特征。填充词、代词、主语和其他词则作为区分度较低的比较类别。词类型分组支持分析 AD 样本与非 AD 样本之间的扰动差异。
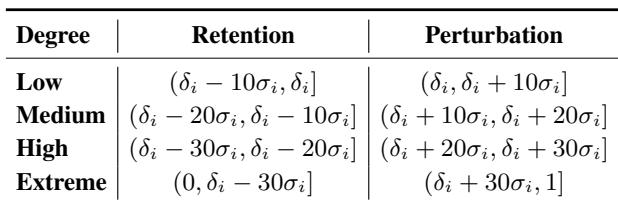
该表根据句子级均值和方差定义了扰动程度类别,将词划分为低、中、高和极高的保留或扰动范围。周围分析表明,Mediator 模块对临床重要的 AD 相关特征施加较低扰动,而对非 AD 或相关性较低的特征使用更高且更不稳定的扰动。扰动类别基于每个句子的平均扰动程度和方差。临床重要特征以较低扰动被保留。非 AD 样本比 AD 样本接受更高且更宽泛的扰动。
实验使用 156 个均衡的 Cookie Theft 图片描述样本,用于比较 AD 检测方法、消融模型组件并检查语义扰动。提出的 SPZ 单模型在总体有效性上最具优势。虽然数据增强对部分基线方法有效,但 token 级嵌入、Generator 和 Mediator 均有助于提升分类性能,且完整模型尤其表现出较强的召回率。扰动分析表明,Mediator 更强烈地保留临床重要的 AD 相关内容,并对相关性较低或非 AD 特征施加更高且变化更大的扰动,这支持了模型的临床有效性。