Command Palette
Search for a command to run...
G-DIG:面向机器翻译的基于梯度的多样化高质量指令数据选择方法
G-DIG:面向机器翻译的基于梯度的多样化高质量指令数据选择方法
Xingyuan Pan Luyang Huang Liyan Kang Zhicheng Liu Yu Lu Shanbo Cheng
摘要
大语言模型(LLMs)在通用场景中展现了卓越的能力,指令微调使其能够在多种任务上与人类对齐。然而,指令数据的多样性与质量仍是制约指令微调效果的两大挑战。针对这一问题,本文提出了一种新颖的基于梯度的方法,用于自动选择高质量且多样化的机器翻译指令微调数据。我们的核心创新在于分析单个训练样本在训练过程中对模型的影响。具体而言,我们利用影响函数并结合一个小规模高质量种子数据集,将对模型产生有益影响的训练样本筛选为高质量样本。此外,为增强训练数据的多样性,我们通过对梯度进行聚类和重采样,最大化训练样本对模型影响的差异性。在 WMT22 和 FLORES 翻译任务上的大量实验证明了所提方法的优越性,深入分析进一步验证了其有效性和泛化能力。
一句话总结
字节跳动研究院提出 G-DIG,这是一种用于机器翻译的基于梯度的指令数据选择方法;该方法在小型种子数据集上使用影响函数来识别高质量示例,并对梯度进行聚类和重新采样以最大化数据多样性,在 WMT22 和 FLORES 基准上展现出优势。
核心贡献
- G-DIG 是用于机器翻译中 LLM 指令微调的基于梯度的数据选择框架,能够在不依赖外部评分模型的情况下选择高质量且多样化的示例。
- 该方法将影响函数与小型高质量种子数据集相结合,以识别具有正向影响的示例;通过对候选梯度进行聚类并从簇中重新采样,来提升多样性。
- 在 WMT22 和 FLORES 上的实验显示翻译性能提升,且人工评估中 LLM 对齐效果更好;分析支持该方法的有效性和泛化能力。
引言
大语言模型依赖指令微调来改进对齐和任务性能,尤其是在机器翻译中。以往数据选择方法往往优先考虑规模,或依赖外部评分模型,这限制了它们对目标模型自身学习行为的捕捉能力,也常常只是间接地平衡数据质量和多样性。论文提出 G-DIG,这是一种基于梯度的选择方法;该方法使用影响函数识别对高质量种子数据产生积极影响的训练示例,然后基于这些数据在模型梯度层面上的影响,通过聚类和重新采样来提升多样性。
数据集
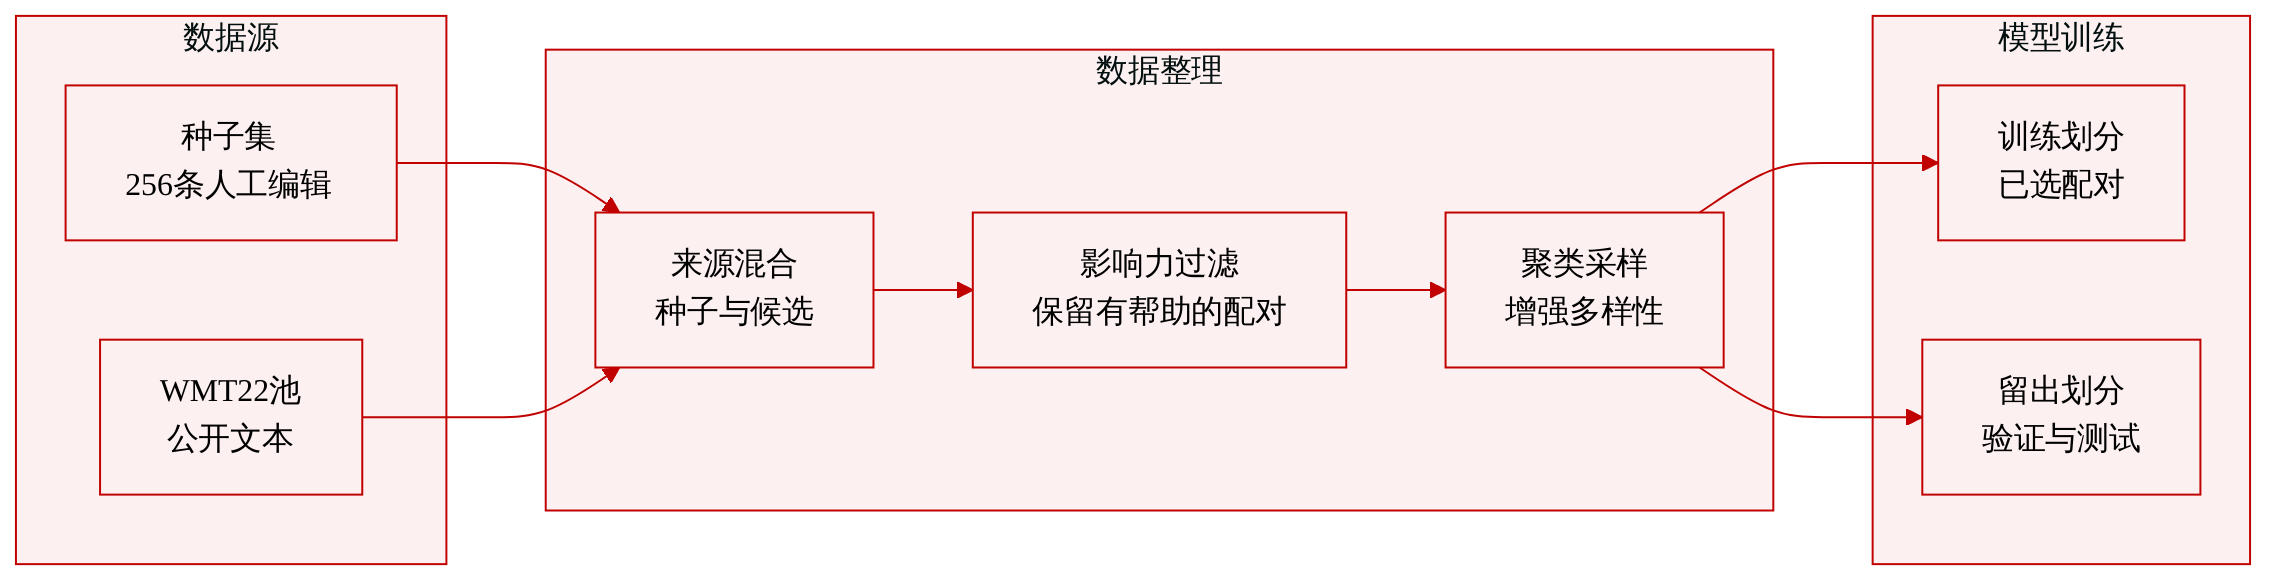
- 作者将翻译微调数据构造为来自平行文本的指令响应对。每个示例使用提示模板 `Translate the following text into {trg_lang}.
Text:
“{src_text}”,响应为相应的目标语言文本。主要构造字段是目标语言标签 trg_lang`。论文没有描述裁剪策略,因此数据选择似乎在完整的源语和目标语平行片段上进行。
-
数据有两个主要子集。首先,人工整理的种子集包含从验证集中随机抽取并由人工译员修订的 256 条平行文本。该种子集作为选择有用训练示例的质量基准。其次,候选池由公开可用的 WMT22 平行文本构成。论文未说明 WMT22 候选池的完整规模。
-
作者使用种子集进行基于影响的筛选,以从候选池中识别高质量示例。只有当候选示例对每个种子示例都具有正向影响时,该示例才会被保留;也就是说,该示例能够降低模型在全部 256 条经人工修订的验证翻译上的损失。
-
在质量筛选之后,作者进一步提升所选数据的多样性。具体做法是:使用与响应损失相关的梯度,在 token 上求平均,通过随机投影将维度降至 400 维,使用 K-means 将示例聚成 512 个簇,并从各个簇中均匀采样,以构建多样化的训练集。
方法
作者为指令微调设计了两阶段数据选择流程。第一阶段选择在小型高质量种子集上提升性能的示例,第二阶段保持对多样化翻译模式的覆盖。参见框架示意图。
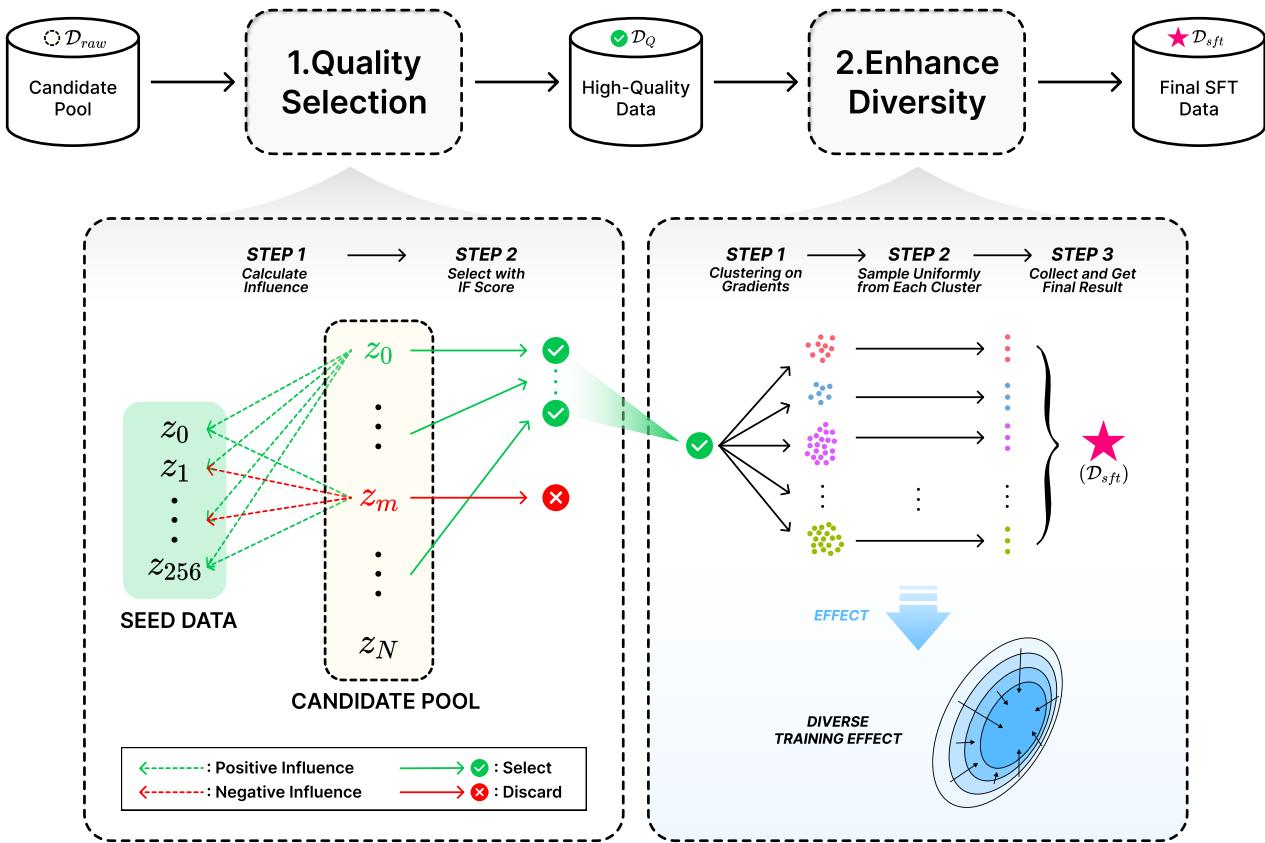
框架从候选池 Draw 开始,并产生最终监督微调数据 Dsft。第一个模块为高质量数据选择,使用影响函数估计候选示例是否能够使模型在种子示例上得到改进。第二个模块为多样性增强,将每个被选示例表示为其梯度模式,对这些表示进行聚类,并从各簇中均匀采样,以避免某一类翻译行为被过度代表。
对于高质量选择,作者首先假设如下形式的微调目标函数
θ∗:=argθminn1i=1∑nL(zi∣θ),其中 zi=(xi,yi) 是一个提示-响应对,θ 表示模型参数。损失仅针对响应部分的语言建模损失:
L(x,y)=−logP(y∣x)=−logj=1∏Tp(yj∣x,y<j).为了衡量一个训练示例如何影响模型在另一个示例上的表现,该方法计算影响分数
I(zm,zt)=−∇θ∣θ∗L(zt)⊤Hθ∗−1∇θ∣θ∗L(zm),其中 Hθ∗ 是在最优参数处训练目标的 Hessian。负的影响分数表示在 zm 上训练能够降低在 zt 上的损失,因此 zm 被视为有利于产生高质量输出。
实际实现通过近似该计算来提升可扩展性。作者使用所选多层感知机层的梯度,具体包括第 3、6、9、12、15、18、21、24、27 和 30 层,并对每个示例内的 token 级梯度求平均,以形成固定大小的表示。作者还使用 Kronecker-Factored Approximate Curvature,即 KFAC,来近似 Hessian 并降低内存成本。
高质量选择步骤随后选择能够改进所有种子示例的候选。种子集 Dseed 是一组小型、人工整理的高质量翻译对。只有当候选 zm 对每个种子示例都具有正向影响时,它才会被保留:
∀zt∈Dseed,I(zm,zt)<0.这会得到一个缩减后的数据池 DQ,其中的示例既相关,又与高质量生成行为正相关。
在该筛选步骤之后,方法进一步控制多样性。对于每个剩余示例,作者计算响应损失相对于最后多层感知机层的梯度,并对 token 级梯度求平均。然后使用欧几里得距离比较这些梯度表示。梯度相似的示例被理解为具有相似的训练效果,而距离较远的梯度向量对应更具区分度的影响模式。
为使聚类可处理,梯度向量通过随机投影降至 400 维。投影后的表示使用 K-means 聚类,实现中使用 512 个簇。最后,从每个簇中均匀采样示例,并将其收集为最终的指令微调集。该过程在保留质量筛选的同时,确保所得数据覆盖多种翻译模式,而不是过拟合到狭窄的训练效果集合。
实验
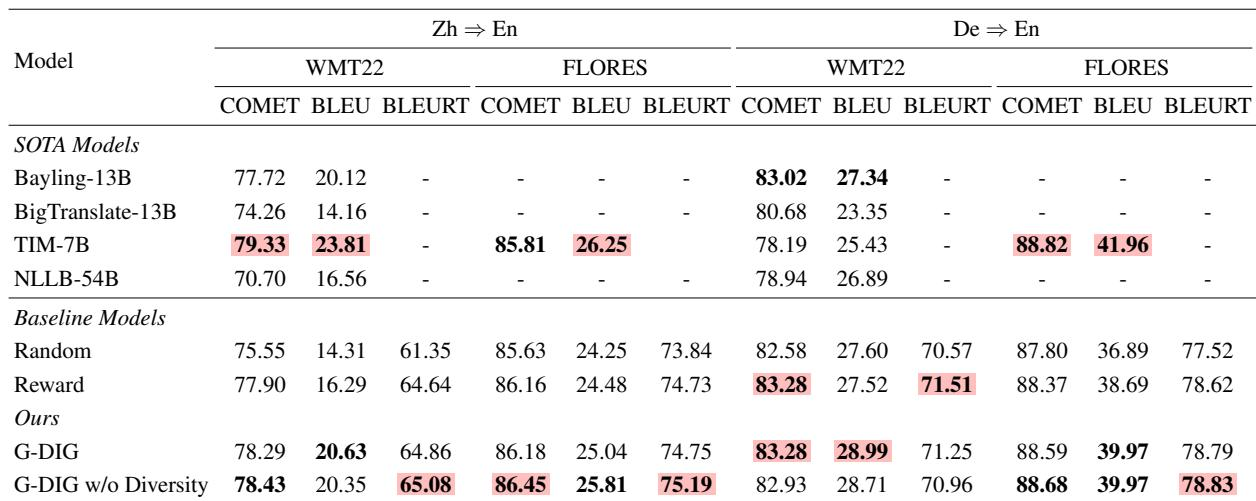
在中英和德英机器翻译上的实验使用 7B LLM、大规模候选池、WMT22/Flores-101 评估、BLEU/BLEURT/COMET,以及包括随机选择、奖励模型选择、TIM 和更大开源模型在内的基线。主要结果验证 G-DIG 在不同数据预算下稳健改进,超过基线,达到具有竞争力且接近 SOTA 的质量,并且与随机选择相比产生人工评分更高的翻译。消融实验进一步验证:在小预算下多样性增强尤其重要,并优于基于嵌入的选择;高质量选择优于奖励模型筛选;超参数设置更偏好适中的种子规模和较多簇数量。
比较涵盖中文到英文和德文到英文翻译结果,跨越多个自动指标。G-DIG 通常优于基线方法,并在与所引用的最先进系统比较时具有竞争力或更强,包括与规模相当和规模更大的参考模型比较。不含多样性的变体并非均匀更差,因为在德英翻译中仍相对奖励模型基线表现出明显的 BLEU 优势。相比所比较基准中报告的基线,G-DIG 在几乎所有情况下均超越基线。其 7B 结果与 TIM-7B 相当,并优于列出的 Bayling、BigTranslate 和 NLLB 参考系统。
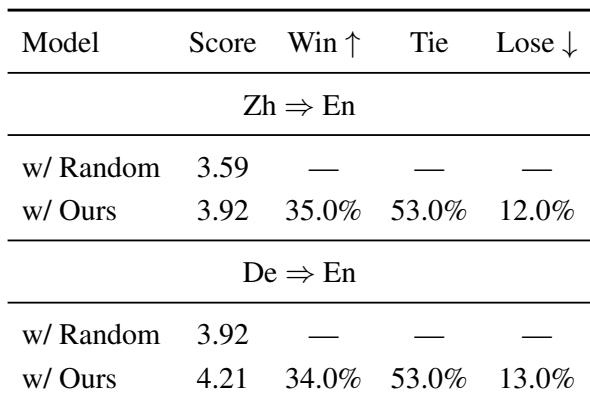
人工评估在抽样得到的中英和德英句子上比较随机子集模型与提出的 G-DIG 子集模型产生的翻译。评审对 G-DIG 翻译给出更高评分,并且比随机子集翻译更偏好 G-DIG 翻译。这些结果支持如下主张:所选训练数据产生更符合人类偏好的翻译。在中英和德英中,G-DIG 翻译获得的平均人工评分均高于随机子集翻译。人工评审更常选择 G-DIG 翻译为更好,而不是选择随机翻译为更好。相当一部分评估结果为平局,但整体偏好仍然支持所提出方法优于随机选择。
这些示例比较了被选中的翻译与随机选择的训练文本。被选中的中英和德英配对忠实、自然且结构完整,而随机配对表现出遗漏、额外细节或目标语陈述不完整。这支持如下主张:该方法选择更可靠的平行训练数据。被选中的配对保留源语含义并生成可读的目标语句子;随机配对可能省略重要细节,或包含源语中没有的内容;质量差异在中英和德英示例中均可见。
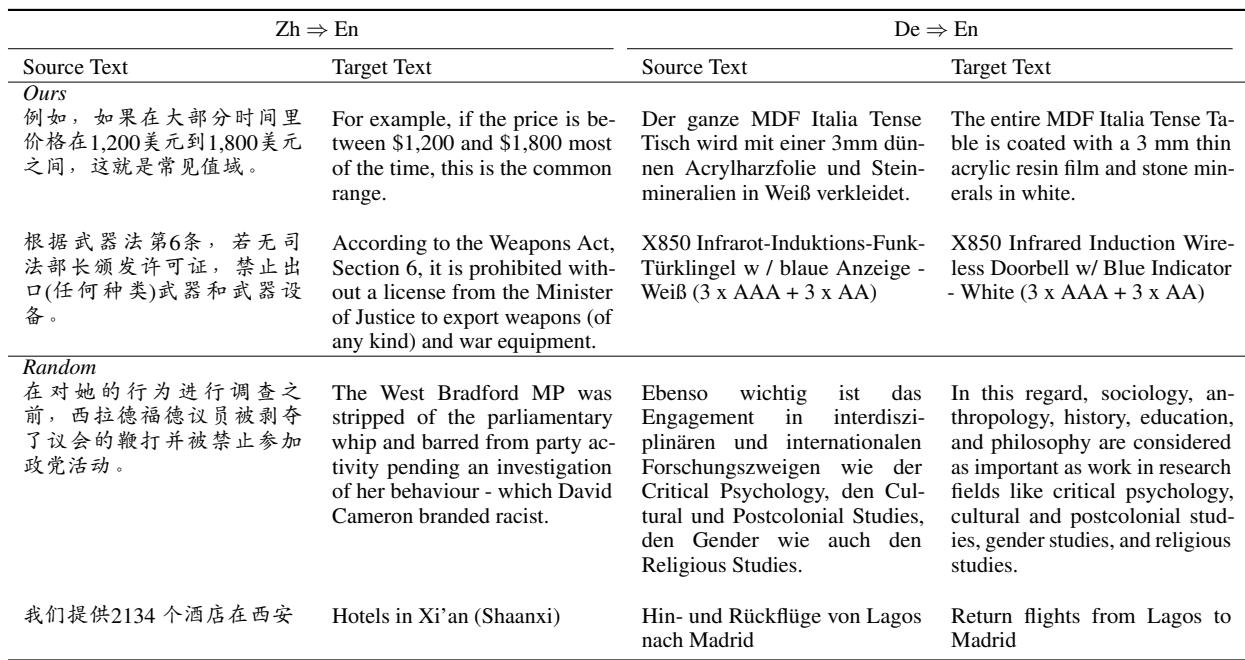
实验使用自动指标、人工评分和定性示例评估提出的方法,用于中文-英文和德文-英文翻译。该方法总体优于基线方法,与强参考系统保持竞争力,并显示多样性组件在大多数设置下带来额外收益。人工评估进一步表明,使用所选数据训练的翻译比使用随机数据训练的翻译更受偏好;定性示例也显示,所选配对比随机配对更忠实、更自然。