Command Palette
Search for a command to run...
Do Llamas Work in English? On the Latent Language of Multilingual Transformers
Do Llamas Work in English? On the Latent Language of Multilingual Transformers
Chris Wendler Veniamin Veselovsky Giovanni Monea Robert West
摘要
We ask whether multilingual language models trained on unbalanced, English-dominated corpora use English as an internal pivot language—a question of key importance for understanding how language models function and the origins of linguistic bias. Focusing on the Llama-2 family of transformer models, our study uses carefully constructed non-English prompts with a unique correct single-token continuation. From layer to layer, transformers gradually map an input embedding of the final prompt token to an output embedding from which next-token probabilities are computed. Tracking intermediate embeddings through their high-dimensional space reveals three distinct phases, whereby intermediate embeddings (1) start far away from output token embeddings; (2) already allow for decoding a semantically correct next token in middle layers, but give higher probability to its version in English than in the input language; (3) finally move into an input-language-specific region of the embedding space. We cast these results into a conceptual model where the three phases operate in "input space", "concept space", and "output space", respectively. Crucially, our evidence suggests that the abstract "concept space" lies closer to English than to other languages, which may have important consequences regarding the biases held by multilingual language models. Code and data is made available here: https://github.com/epfl-dlab/llm-latent-language.
一句话总结
EPFL 研究人员跟踪了 Llama-2 多语言 transformer 各层中的中间 embeddings,揭示了一种三阶段演变过程:从输入空间经过概念空间到输出空间。其中,概念空间更接近英语而非其他语言,这提示了多语言模型中语言偏见的一个关键来源。
核心贡献
- 提供了一种实证诊断方法,用于检验 Llama-2 是否将英语作为内部枢轴语言。该方法通过构造具有唯一正确单 token 续写的非英语 prompt,并跟踪各 transformer 层中的中间 token embeddings 来实现。
- 提出了一种三阶段的多语言生成概念模型:embeddings 从输入空间经过概念空间到输出空间,并表明中间概念空间比输入语言空间更接近英语,提示了一种潜在的语言偏见来源。
- 发布了用于 embeddings 跟踪分析的代码和数据,使人们能够复现该研究,并进一步研究多语言语言模型如何通过依赖语言的内部状态处理非英语输入。
引言
大多数现代大型语言模型都是在以英语为主的语料库上训练的,但它们在许多非英语语言中表现良好。这提出了一个重要问题:LLM 在处理非英语 prompt 时是否隐式地将英语作为内部枢轴语言?这一答案很重要,因为隐式的英语枢轴可能会在词汇、语法、隐喻、情感语气和推理中引入以英语为中心的偏见;如果不存在这种枢轴,则说明模型依赖其他机制来实现较强的多语言性能。
前人多语言模型研究通常假设这种内部英语枢轴存在,而早期方法也会显式地使用英语作为翻译或推理桥接。然而,直接检验这一假设是困难的,因为 LLM 将内部状态表示为高维数值向量,而不是离散的语言 token。机制可解释性工具提供了一定程度的模型内部可见性,但诸如 tuned lens 之类的方法可能通过学习和解来擦除中间英语状态本身的信号,从而模糊这一问题。
作者通过在其他 Llama-2 模型上使用 logit lens 来填补这一空白。他们解码中间层的 token 概率,并跟踪在不同层中哪种语言占主导地位。他们发现,中间层常常会在模型最终生成正确的非英语输出之前,先产生预期下一个 token 的英语形式。他们还直接分析潜在 embeddings,并认为模型的行为更适合用中间层中偏向英语的概念空间来解释,而不是用回到英语的字面翻译步骤来解释。
数据集
-
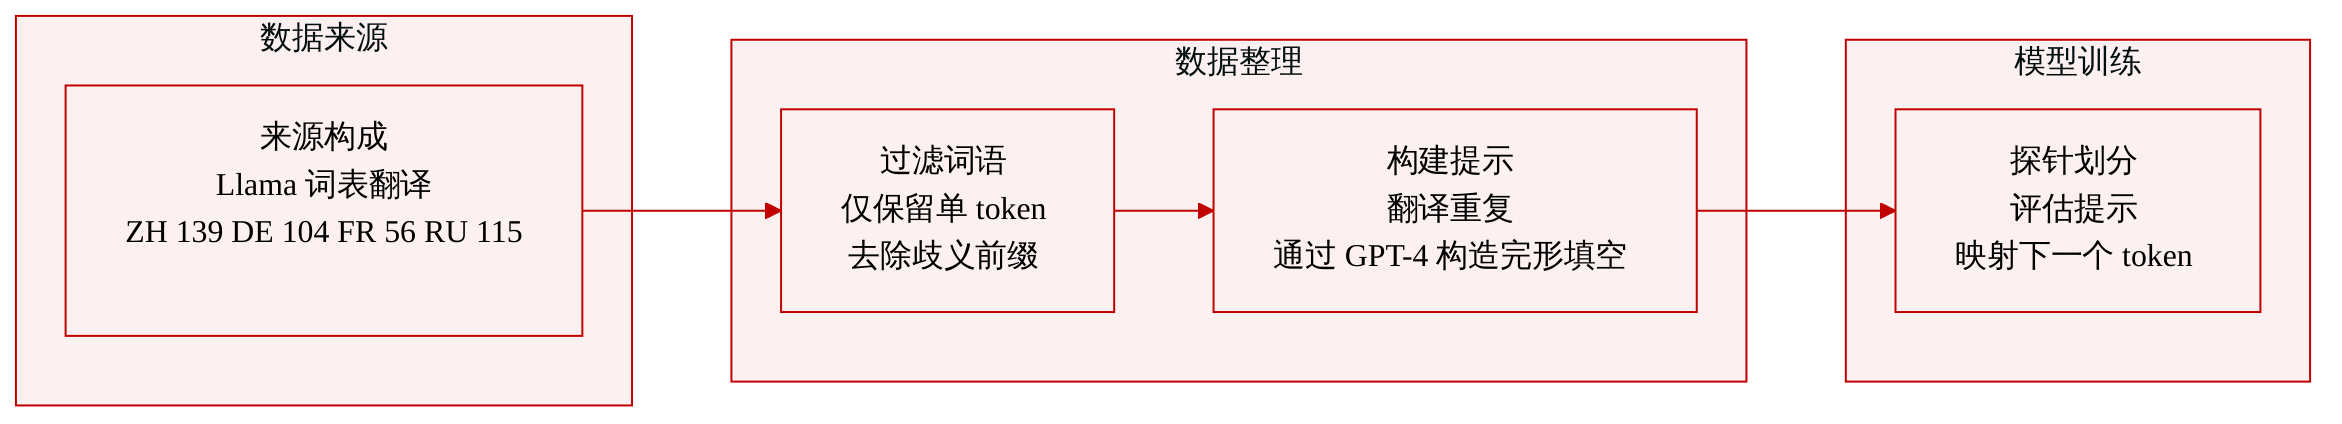
作者创建了一个小型、基于任务的 prompt 数据集,而不是大型自然语言语料库。该数据集的设计目的是探查 Llama-2 的内部状态,方法是让模型生成一个易于推断并明确归属于目标语言的下一个 token。
-
主要来源:Llama-2 的词汇表。对于中文,他们选择单 token 中文词,多为名词,其英语翻译也是单 token。这使得中文词及其英语对应词的下一个 token 概率可以直接比较。
-
额外语言:德语、法语和俄语。中文和英文词被翻译成这些语言,并且任何与英语版本共享 token 前缀的翻译词都会被移除,以避免语言检测出现歧义。
-
规模:139 个中文词、104 个德语词、56 个法语词和 115 个俄语词。
-
任务组成:基于这些词构造了三类 prompt。翻译 prompt 展示四组词对,并要求补全缺失的翻译。重复 prompt 要求模型重复最后一个词。完形填空 prompt 要求模型在翻译后的句子中填入被掩码的目标词。
-
prompt 构造:对于翻译和重复任务,示例从同语言中剩余词中随机采样。对于完形填空,先由 GPT-4 生成以目标词开头的英语句子;随后掩码目标词,将该句子翻译成目标语言,并从剩余词中采样两个示例。
-
prompt 结构:每个示例包括目标语言、一系列 prompt token、一组示例或一个掩码句子,以及一个应揭示潜在语言的预期下一个 token。
-
用法:作者使用该数据集将潜在向量和下一个 token 分布映射到特定语言,而不是仅依赖 token 分布这类通用工具,因为许多 token 在语言上具有歧义。该数据集用于在中文、德语、法语和俄语上的探查和评估,而不是作为训练混合数据。
方法
作者使用 Llama-2,这是一种自回归、仅解码器的 transformer。该架构通过一个学习得到的嵌入字典,将每个输入 token xi∈V 表示为潜在向量 hi(0)∈Rd。在 m 层中,每个潜在向量通过一个残差 transformer block fj 更新,
hi(j)=hi(j−1)+fj(h1(j−1),…,hi(j−1)),其中每个 fj 包含掩码自注意力、前馈网络和 RMSNorm(均方根归一化)。由于这种归一化,每个潜在向量都位于半径为 d 的 d 维超球面上。在预训练期间,transformer blocks 被调整,使得最终潜在向量 hi(m) 能够预测下一个 token。在推理阶段,最终潜在向量乘以 unembedding 矩阵 U∈Rv×d,得到 logits zi=Uhi(m),softmax 运算产生
P(xi+1=t∣x1,…,xi)∝ezit.为了进行解释,作者使用 logit lens。由于各层潜在向量具有相同的形状,可以把中间潜在向量当作最终层潜在向量来处理。将 unembedding 矩阵应用于 hn(j),会得到位置 n 和层 j 处的过早下一个 token 分布。为了将这些分布解释为特定语言的结果,作者构造了能够强制产生清晰下一个 token 的 prompt,并将目标 token 明确绑定到一种语言。他们使用了三个受控任务:翻译、重复和完形填空。每个 prompt 包含少量示例,随后是使下一个词可预测的目标上下文。目标词汇表经过过滤,使得目标语言中的正确下一个 token 及其英语对应项都是单 token 条目,同时排除与英语形式共享 token 前缀的词。这使得可以直接从 token 概率中读取语言证据。
然后,该方法将中间 logits 转换为语言概率。对于目标语言 ℓ,用 tℓ 表示该语言中正确的单 token 词,作者定义
P(lang=ℓ∣hn(j)):=P(xn+1=tℓ∣hn(j)).这些数值不会跨语言归一化,因此它们的和可能小于一。这种构造使流程能够逐层比较潜在向量是偏向输入语言、英语还是其他语言。
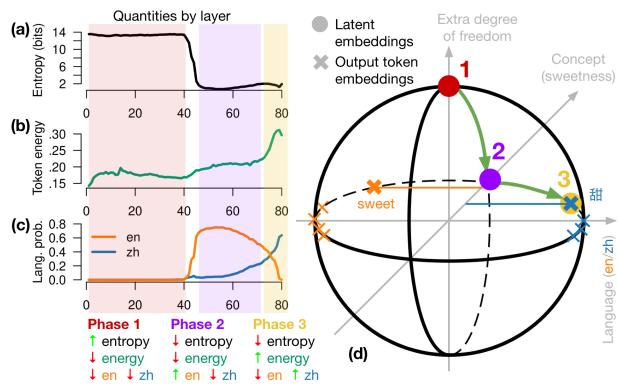
为了解释这种随深度变化的演化,作者刻画了潜在向量在 embeddings 空间中的轨迹。他们跟踪 logit-lens 分布的熵、token energy 以及各层的估计语言概率。token energy 衡量潜在向量与输出 token embeddings 的对齐程度,表示该潜在向量对下一个 token 预测的准备程度。该分析通过三个阶段来描述。第一阶段中,潜在向量会构建对当前输入的更丰富特征表示,并且基本与输出 token 空间无关,因此产生高熵和低 token energy。第二阶段中,潜在向量进入抽象的概念空间,在其中变得更接近于跨语言表达同一概念的输出 embeddings,因此产生低熵,同时仍保留上下文和语言信息。由于模型经过以英语为主的预训练,英语输出 embeddings 在此阶段更接近概念表示,因此英语 token 在此阶段往往获得更高概率。第三阶段中,潜在向量将该概念映射到目标语言中的具体输出 token,并丢弃对即时预测用处较少的信息,这会使 token energy 升高。下图对这种三阶段视角进行了可视化,其中潜在轨迹在超球面上表示,同时显示各层的熵、token energy 和语言概率。
实验
实验使用 logit lens 检查各层中的下一个 token 概率,并使用几何化潜在分析来刻画中间表示,在不同语言和规模上考察 Llama-2 模型在翻译、完形填空和重复任务上的表现。结果显示了一致的模式:早期层总体不偏向某一语言,中间层越来越偏向与英语相关的表示,后期层则转向目标语言;同时,降维路径显示出似乎经过类似英语子空间的绕行。总体而言,这些结果支持英语偏置的内部组织,但表明这种枢轴更宜理解为语义概念空间,而非纯粹的词法英语,并且该效应会因任务和 tokenization 而变化。
logit lens 表明,中间层会解码目标含义的英语形式,而最终层则对正确的中文词排序,说明潜在空间中存在英语绕行。相关上下文将更强的英语绕行与更不利的 tokenization 覆盖相关联,并指出单 token 目标词会降低这种效应。中间层在最终中文输出之前会揭示与英语 flower 相关的 token。特定语言 token 的可得性与较弱的英语绕行相关。
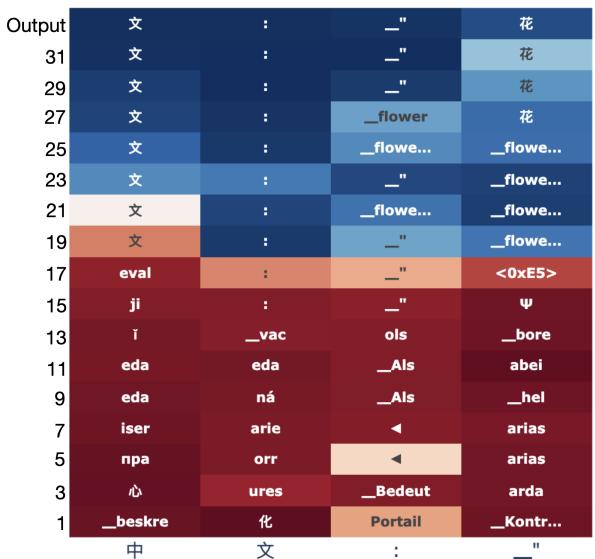
使用 logit lens 探查实验考察了在生成中文输出时,目标含义在各层中的表示方式。他们发现,中间层常常会在最终层选择正确中文词之前浮现出与英语或英语相关的 token,这支持潜在空间中英语绕行的存在。当特定语言 token 更容易获得时,尤其对于单 token 目标词,这种绕行会变弱,这表明 tokenization 覆盖会影响内部翻译路径。