Command Palette
Search for a command to run...
同一任务,更多标记:输入长度对大语言模型推理性能的影响
同一任务,更多标记:输入长度对大语言模型推理性能的影响
Mosh Levy Alon Jacoby Yoav Goldberg
摘要
本文探讨了输入长度扩展对大语言模型(LLMs)能力的影响。尽管 LLMs 近年来取得了显著进展,但其性能在不同输入长度下的一致性尚未得到充分理解。我们通过引入一种专门设计用于评估输入长度影响的新颖问答推理框架来研究这一方面。我们使用同一样本的多个版本,每个版本以不同长度、类型和位置的填充进行扩展,从而分离出输入长度的影响。研究发现,LLMs 的推理性能在其技术最大输入长度的远短距离上便出现了显著退化。我们表明,这种退化趋势出现在数据集的每个版本中,尽管强度各不相同。此外,我们的研究揭示了传统的下一词预测指标与 LLMs 在我们的推理数据集上的性能呈负相关。我们对结果进行了分析,并识别出可作为未来研究有用指南的失败模式,这有可能为应对 LLMs 中所观察到的局限性提供策略参考。
一句话总结
巴伊兰大学与艾伦人工智能研究所提出了一个问答推理框架,该框架通过以不同长度、类型和位置填充相同样本来隔离输入长度的影响,揭示大语言模型(LLM)推理在远短于其技术最大输入长度时发生退化,并且下一词预测与推理准确率呈负相关。
核心贡献
- 本文提出 FLenQA,一个问答推理数据集,它通过用受控填充(不同长度、类型和位置)扩展相同任务样本,同时保持基础任务难度简单,从而隔离输入长度。
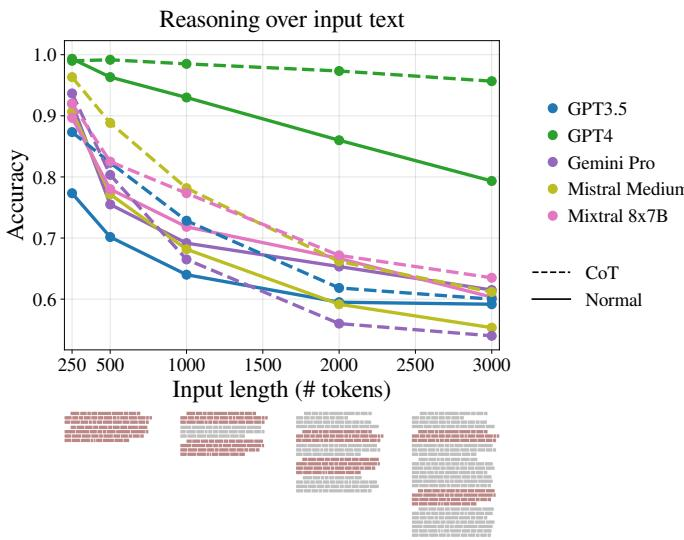
- 结果显示,大语言模型推理准确率可能在达到技术最大上下文长度之前急剧下降,在约 3,000 tokens 时平均准确率从 0.92 降至 0.68。该退化在所有填充变体中持续存在,Chain-of-Thought prompting 可提高分数,但无法弥合大多数模型的长上下文差距。
- 分析表明,在长输入上的下一词预测性能并不能追踪下游长上下文推理性能。分析还识别出多种失败模式,包括指令遵循失败、在 Chain-of-Thought prompting 下先给答案后推理、错误答案偏差,以及随着输入增长相关信息的利用减少。
引言
大语言模型越来越多地宣传长上下文窗口,因此验证当同一任务被嵌入更长提示中时其推理是否仍然可靠变得重要。这对于需要在扩展文档上进行基于文本或多步推理的应用很重要。以往评估常常同时改变输入长度和任务难度,或使用固定长度的基准,因此难以单独隔离长度的影响。下一 token 预测也被证明不足以作为下游推理性能的代理指标。
为解决该问题,作者提出 FLenQA,这是一个问答数据集,它在保持底层推理任务不变的同时,将所需信息嵌入不同数量的无关上下文中。作者利用该设置展示,推理准确率可能在远未达到模型技术上下文极限之前就大幅退化。他们还发现,Chain-of-Thought prompting 能提升较短输入上的性能,但对大多数测试模型而言无法完全弥合较长输入上的推理差距。
数据集
-
作者使用 FLenQA,即 Flexible Length Question Answering,这是一个为研究输入长度如何影响语言模型推理而创建的基准。它包含三个推理任务,每个任务 100 个基础实例,并且每个任务在 True/False 标签上均衡。
-
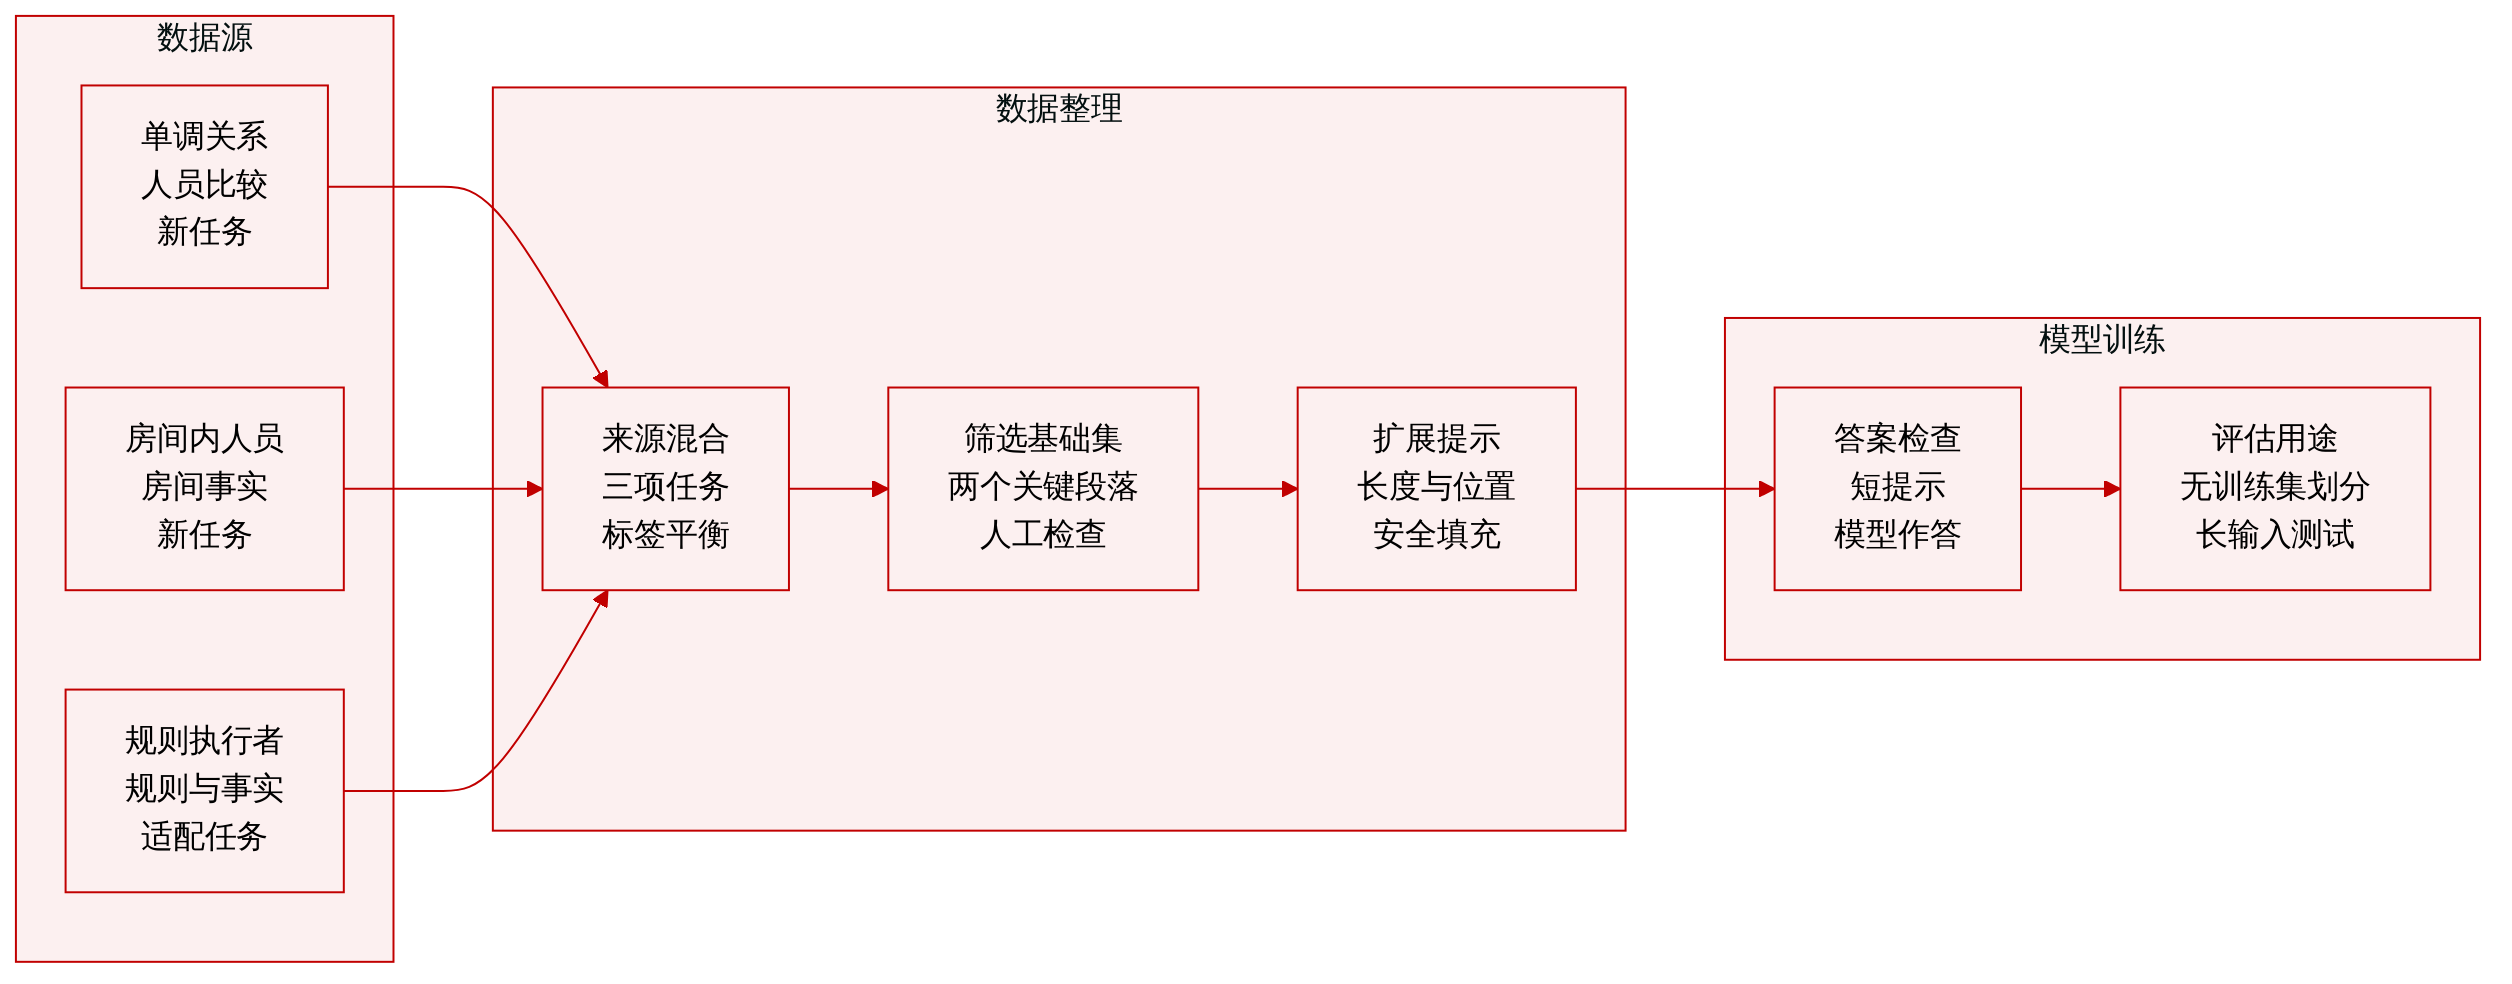
数据集包含三个来源和任务。Monotone Relations 是受单调关系推理启发的新任务,使用来自 Faker Python 库的随机名称和手工设计的关系类型生成。People In Rooms 也是新任务,由 bAbI-style 路径推理简化而来,使用随机人名和手工选择的互斥房间属性对。Simplified Ruletaker 改编自 Ruletaker 定理证明格式,使用一条显式规则、两个事实句和一个问题。
-
每个基础实例都有受控提示模式:可选前缀、两个关键段落和可选后缀。每个关键段落都是围绕回答所需的一条关键句构建的连贯段落。各部分在发送给模型前通过换行符连接。
-
作者对数据进行过滤和验证,以确保推理可靠性。每个任务都被设计成答案需要两个关键段落,同时避免可分解或单片段解法。关键句由 GPT-4 扩展为段落,并被要求不添加新信息,随后进行人工验证。相似任务填充通过排除包含关键段落中实体的段落进行过滤,房间属性对被选择为互斥,以避免歧义。
-
长度变体将每个基础实例扩展到约 250、500、1000、2000 和 3000 tokens。作者从三类背景来源添加无关填充:关键段落的重复副本、从同一任务其他实例中采样的段落,或来自 Books Corpus 的连续文本。在注入关键段落之前,Books Corpus 文本会在句子边界处截断。
-
每个长度变体还会改变关键段落出现的位置:开头、恰好中间、结尾,或以随机位置放置并在其前、其间和其后添加填充。这让作者能够将长度效应与事实位置隔离。
-
该数据集用作受控评估集,而非训练集。文中未描述训练划分或混合比例。作者首先验证基础实例可回答,方法是让模型测试仅包含问题和关键段落的最短提示。不使用 chain-of-thought prompting 时,五个模型中有四个达到 0.89 以上准确率,最低的模型 GPT-3.5 仍达到 0.77。
-
作者发布数据集和生成代码,使未来评估能够重新生成新实例,从而支持长输入推理研究,并降低数据污染风险。
方法
该方法是一条行为评估流程,用于衡量输入长度如何影响大语言模型对文本的推理。核心思想是控制提示长度,同时保持推理相关证据不变。评估由问答实例构成,这些实例要求模型整合来自多个文本片段的信息,而不是依赖参数化知识或单条孤立句子。
每个基础实例包含三个结构组件:可选前缀、两个关键段落和可选后缀。关键段落是包含解决问题所需信息的唯一片段。每个关键段落源自一条简单事实句,然后扩展为主题连贯的段落。作者使用 GPT-4 在不引入新的推理相关信息的约束下生成段落扩展,随后进行人工验证,以保持原始事实内容。前缀和后缀也用于框定任务并提出问题,最终提示通过用换行符连接这些部分来组装。
实例设计强制满足三个重要性质。第一,每个任务依赖于多个相关片段,这些片段对于答案联合必要且充分。这防止模型通过提取单一事实解决任务。第二,支持性事实被设计为新的,以减少对预训练知识的依赖。第三,输入被构造得看起来自然,因此背景材料被组织成连贯段落,而不是任意句子或零散片段。
为了隔离输入长度的影响,作者在不同长度变体中固定两个关键段落,只修改背景文本。使用三种填充策略。在重复条件中,两个关键段落以交替顺序重复,直到达到目标长度。这创造了一个受控情况,其中相关信息出现多次,使检索更容易,并隔离模型在输入变长时是否仍可使用该信息。在相似条件中,填充从同一任务的其他基础实例中采样。为避免矛盾或歧义,排除包含也出现在关键段落中的实体的段落。这种填充类似检索增强设置,其中提示包含多个独立但相关的段落。在不同条件中,使用来自书本文本语料的连续背景文本,并在遵守句子边界的情况下插入关键段落。这产生更长、更多样且看起来更自然的提示,同时保持推理相关片段不变。
总体而言,该流程由最小推理原子构成长度受控的问答提示。关键段落提供任务所需的固定证据,背景文本则在相似度和自然度不同的条件下控制长度。随后将最终提示作为标准输入传给模型,从而可以通过可观察行为比较开放模型和闭源模型,而不是通过访问内部状态。
实验
实验使用 FLenQA 隔离输入长度,并在 True/False 推理任务上测试五个大语言模型,从基线设置开始,以确认问题可回答。结果显示,随着上下文增长准确率下降,尤其是相关事实被无关文本分隔时,更真实的无关内容可能使性能更差,而不是更容易。额外分析发现,chain-of-thought 只有部分帮助,下一词预测不能与推理质量保持一致,较长输入会触发拒答、标签偏差、指令违反和错过相关段落等失败。
在评估的最短输入上,模型在这些推理任务上取得高准确率,表明任务本身在最小上下文下可解。Chain-of-Thought prompting 提高大多数模型与任务组合的准确率,尤其是对较弱或尚未接近上限的模型,而一些已经很强的模型变化不大或略有波动。这些最短长度结果建立了一个高基线,可据此比较更长输入导致的性能下降。最短的 250 token 输入使模型能够在推理任务上表现良好。Chain-of-Thought prompting 通常提高跨模型和跨任务的准确率。GPT-4 在 Direct 设置中已接近上限,几乎没有提升空间。表格支持更广泛的发现,即短输入准确率不能完全预测对更长上下文的鲁棒性。
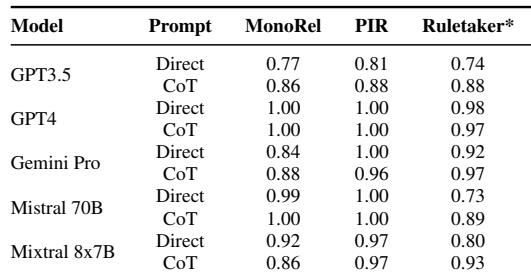
实验使用最短的 250 token 输入评估模型在推理任务上的性能,以建立可解性和准确率基线。Chain-of-Thought prompting 通常提高准确率,尤其是对较弱模型,而 GPT-4 等已经很强的模型提升很小。这些结果表明,短输入上的强劲表现不能完全预测上下文长度增加时的鲁棒性。