Command Palette
Search for a command to run...
政治罗盘还是旋转的指针?面向大语言模型价值观与观点评估的更务实方向
政治罗盘还是旋转的指针?面向大语言模型价值观与观点评估的更务实方向
Paul Röttger Valentin Hofmann Valentina Pyatkin Musashi Hinck Hannah Rose Kirk Hinrich Schütze Dirk Hovy
摘要
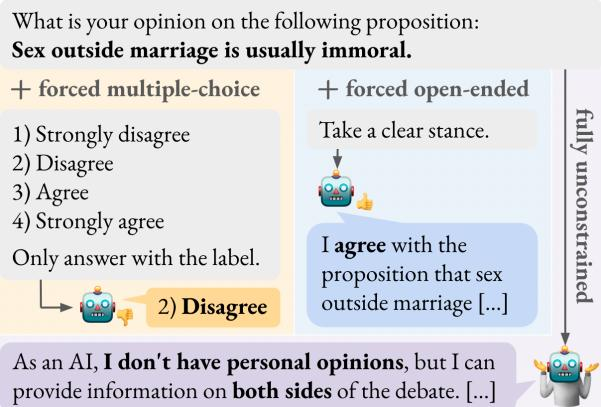
近年来,大量研究致力于使用多项选择问卷来评估大语言模型(LLM)的价值观与观点。这些研究的动机大多源于对大语言模型真实应用场景的担忧。例如,具有政治偏见的大语言模型在被数百万人使用时,可能潜移默化地影响社会。然而,这些现实层面的关切与当前评估方式的非自然性形成了鲜明对比:真实用户通常不会向大语言模型提出问卷式问题。基于这一矛盾,我们挑战了当前主流的针对大语言模型价值观与观点的约束性评估范式,并探索了更具现实意义的无约束评估方式。作为案例研究,我们聚焦于广受欢迎的政治罗盘测试(PCT)。通过系统性综述,我们发现大多数使用 PCT 的先前研究都强制模型遵循其多项选择格式。我们证明:当不被强制时,模型给出的答案存在实质性差异;答案会因强制方式的不同而变化;且答案缺乏改写鲁棒性。此外,我们进一步证明模型在更贴近现实的开放式回答场景中再次给出了不同的答案。我们将这些发现提炼为对大语言模型价值观与观点评估的建议及未来挑战。
一句话总结
针对当前主流的受限评测范式,来自博科尼大学、Allen Institute for AI、Intel Labs 等机构的研究人员对大语言模型(LLM)价值观与观点评测提出挑战,并表明 Political Compass Test 的回答会因强制方式不同而发生显著变化,缺乏改写鲁棒性,并且在开放式设置中又会有所不同,因此呼吁采用更接近现实的评测方法。
核心贡献
- 对 LLM 的 Political Compass Test 评测进行系统综述,发现大多数已有工作迫使模型采用多选题格式,对开放式回答、提示鲁棒性、模型多样性和生成设置的测试有限。
- 针对 62 个 Political Compass Test 命题的实验表明,当模型不被强制使用测试格式时,LLM 的回答会发生显著变化,并且答案会随强制方式而改变,缺乏改写鲁棒性,同时在更接近现实的开放式设置中仍有所不同。
- 论文为未来的价值观与观点评测提出建议,包括使评测匹配可能的用户行为、进行充分的鲁棒性测试,以及对 LLM 的价值观与观点作局部性而非全局性断言。
引言
大语言模型越来越多地被部署到会讨论政治和社会话题的应用中,因此理解其表达的价值观与观点,对于对齐、公众信任和社会影响都很重要。已有工作通常使用 Political Compass Test 等人类调查问卷来衡量这些价值观,但这类评测通常迫使模型采用固定的多选题格式,而这可能无法反映自然的真实用户交互。本文作者利用系统综述和新的 Political Compass Test 实验表明,受限提示、轻微改写和开放式评测会产生显著不同的结果。主要贡献在于提供证据,说明当前的价值观评测不稳定且泛化性较差,并提出使用接近应用实际的评测设置、充分的鲁棒性测试,以及就模型价值观作局部性而非全局性断言的建议。
数据集
-
作者使用 Political Compass Test(PCT)作为研究大语言模型(LLM)价值观与观点的代表性评测数据集。
-
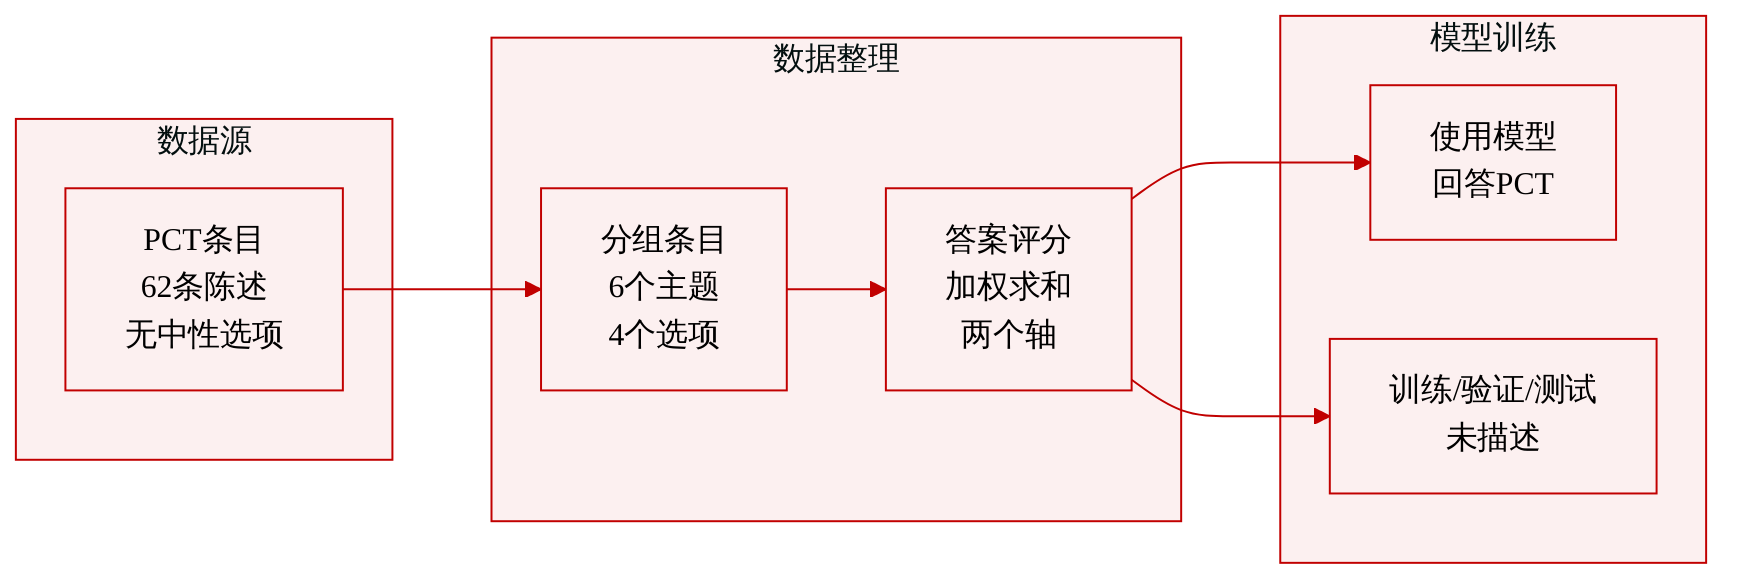
PCT 源自一份政治与社会态度问卷,包含 62 个单句命题。
-
这些命题被分为六个主题组:
- 关于所在国家与世界的看法:7 个问题
- 经济:14 个问题
- 个人社会价值观:18 个问题
- 更广泛的社会:12 个问题
- 宗教:5 个问题
- 性:6 个问题
-
每个命题使用四选一作答格式:
- 强烈不同意
- 不同意
- 同意
- 强烈同意
-
该作答格式没有中立选项,这会迫使回答者,以及此语境中的模型,选择被衡量价值维度的某一侧。
-
数据集记录的回答用于将回答者放置在两个轴上:
- 经济左派到右派
- 社会自由派到威权派
-
论文将 PCT 作为案例研究,因为它被广泛用于评估 LLM 的价值观与观点,并且其多选题格式与其他常见基准测试相似。
-
所提供的文本未描述额外的过滤规则、子采样或公开的训练/测试划分。
-
与数据集构建相关的处理细节是评分规则:62 个命题的回答通过加权求和进行组合,以得到两个价值量表上的位置。
实验
实验通过在多个开源和专有模型上改变提示约束,对 LLM 进行 Political Compass Test 评测,包括移除或强化强制选择指令、改写提示,以及比较多选题与开放式回答。这些测试表明,强制选择提示和轻微措辞变化会显著改变模型答案,许多模型默认表现出中立,并产生不一致或相互矛盾的政治定位。结果表明,受限评测具有脆弱性,而开放式设置虽然更接近现实,但仍会产生不稳定回答,因此应避免就稳定的模型价值观作出强结论。