Command Palette
Search for a command to run...
自然语言可满足性:探索问题分布与评估基于 Transformer 的语言模型
自然语言可满足性:探索问题分布与评估基于 Transformer 的语言模型
Tharindu Madusanka Ian Pratt-Hartmann Riza Batista-Navarro
摘要
近年来,将基于 Transformer 的语言模型(TLMs)应用于自然语言推理任务取得了日益显著的成功。在这一领域中,可满足性判定是最基础的任务,几乎所有其他任务都可以归约到它。然而,从逻辑学角度来看,可满足性问题在多个维度上存在差异,这可能会影响 TLMs 学习求解这些问题的能力。自然语言中的可满足性问题实例可以根据其表达所使用的语言片段归属于不同的计算复杂度类。尽管已有研究探讨了自然语言可满足性问题,但上述方面尚未得到充分讨论。因此,我们研究了来自不同计算复杂度类且具有不同语法结构的问题实例如何影响 TLMs 学习推理规则的能力。此外,为了对 TLMs 进行忠实评估,我们开展了一项实证研究来探索可满足性问题的分布。
一句话总结
曼彻斯特大学与奥波莱大学研究跨越不同计算复杂度类别和语法构造的可满足性问题实例如何影响基于 transformer 的语言模型学习推理规则的能力,并开展了一项关于自然语言可满足性问题分布的实证研究,以支持忠实的模型评估。
核心贡献
- 该论文识别出涵盖限定词、系动词、及物动词、关系从句和约束变量回指的英语可满足性片段,然后从经验确定的相变区域采样的数据构造数据集。
- 该论文评估了基于 transformer 的语言模型在不同计算复杂度片段上的自然语言可满足性表现,发现模型性能明显受到可满足性问题底层复杂度的影响。
- 该论文研究了这些可满足性任务的零样本表现,并表明模型可能无法适应分布偏移并泛化到训练分布之外,提示它们可能无法将数据集模式与推理规则分离。
引言
基于 transformer 的语言模型常在自然语言推理中被评估,方法是测试它们能否识别不依赖常识背景知识的严格逻辑蕴含。这一点很重要,因为此类任务旨在探测模型能否学习推理规则、理解逻辑意义并模拟算法推理。
早先关于可满足性和蕴含的神经研究大多聚焦于命题逻辑或窄定义的人工语言片段。这限制了表达能力,使底层复杂度大多固定在 NP 完全问题,并常常产生未采样最难实例的数据集。作者通过定义与不同一阶逻辑片段关联的英语片段、识别相变区域以构建挑战性可满足性数据集,并分析计算复杂度如何影响模型性能(包括零样本设置)来应对这一问题。
数据集
-
作者为若干语言片段构造合成的自然语言可满足性数据集。每个数据点包含来自某片段的一组句子 Φ 和一个二值标签,Y 或 N,指示 Φ 是否可满足。
-
数据来源不是外部语料库。作者从语言模板生成示例。每个句子通过选择片段模板并均匀采样普通名词、以及必要时及物动词来创建。
-
每个示例集合 Φ 的基数为 m。采样使用 n1 个普通名词,以及对于关系片段使用 n2 个及物动词。生成过程重复 m 次以形成一个输入实例。
-
标签自动生成。句子被映射到一阶逻辑公式模板,定理证明器 Z3 判定可满足性。
-
作者只在经验确定的临界区域 λ_L 内采样 m、n1 和 n2。这确保密度比 α = m / n1 和 β = m / n2 落入临界区域内。
-
对于片段 S 和 W,训练示例的 n1 从 6 到 16 采样。对于片段 ν、z 和 A,训练示例的 n1 从 3 到 8 采样,n2 从 3 到 8 采样。
-
对于每个语言片段,作者构建包含 120K 个示例的平衡训练集、包含 10K 个示例的评估集和包含 10K 个示例的测试集。
-
按片段划分的数据集用于微调并评估 transformer 语言模型在自然语言可满足性任务上的表现。
-
数据集平衡包含相等数量的可满足与不可满足实例,并以准确率作为评估指标。
-
为测试较简单片段是否有助于模型泛化到较复杂片段,作者还创建了混合所有片段示例的联合数据集。这些数据集包括总计 600K 个示例且每个片段 120K 个示例,以及总计 120K 个示例且每个片段 24K 个示例。
-
为测试规模不变性和泛化性,作者在包含比训练数据更多谓词或变量的数据集上评估模型。
-
对于零样本评估,作者生成更小的基准数据集。对于 S 和 W,n1 从 5 到 10。对于 ν、z 和 A,n1 从 3 到 5,n2 从 2 到 5。
-
对于零样本评估,作者为每个片段创建 1200 个问题实例,并使用基于模板的提示流程将它们放入提示中。
方法
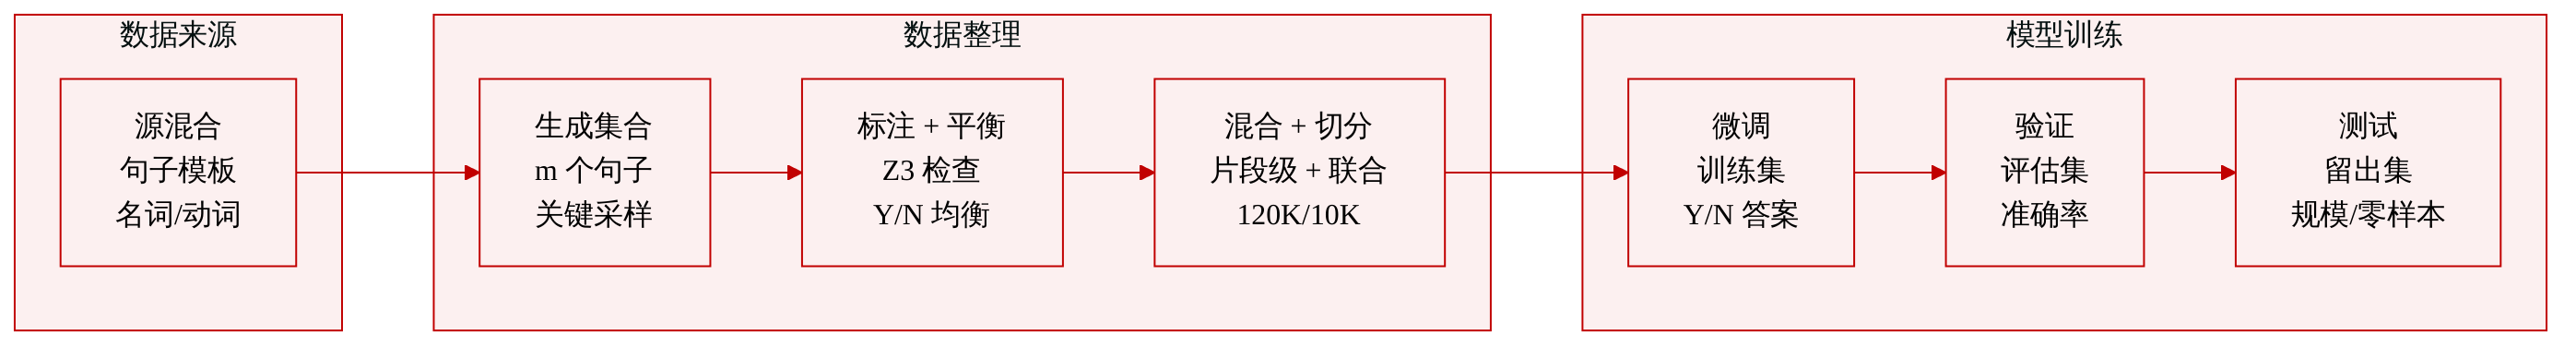
作者将该任务形式化为在英语形式化片段上的自然语言推理对基于 transformer 的语言模型进行受控评估。核心方法思想是定义若干语义封闭的语言片段,将其句子翻译为一阶逻辑,在相变边界附近生成具有挑战性的可满足性实例,并使用外部定理证明器自动为每个实例标注。所得数据随后用于对 TLM 进行微调并在二值逻辑决策问题上评估。
流水线的第一个组成部分是语言片段定义。每个片段由有限集自然语言句子模板指定,例如 “Every p is a q”、“Some p is a q”、“No p is a q” 和 “Some p is not a q”,其中模式变量取值于普通名词;在更强的片段中,取值于及物动词和关系从句结构。每个句子模板都与一个一阶公式模板配对,后者提供其真值条件语义。例如,基本量化名词短语模式可翻译为:
Every p is a qSome p is a qNo p is a qSome p is not a q⇒∀x(p(x)→q(x))⇒∃x(p(x)∧q(x))⇒∀x(p(x)→¬q(x))⇒∃x(p(x)∧¬q(x))全称句子被解释为不包含存在预设。这一语义设定给出了良定义的模型论有效性与可满足性概念。所研究的片段范围从经典三段论的受控版本,扩展到包含关系从句、及物动词、量化宾语位置和约束变量回指的更丰富语言。对于给定片段 L,作者研究判定问题 Sat(L),其输入是一组有限句子 Φ,输出是 Φ 是否可满足。
第二个组成部分解决如何向 TLM 提供真正困难而非极易预测实例的需求。作者观察到,类似命题 k-SAT,许多随机生成的逻辑实例几乎必然可满足或几乎必然不可满足。在名词短语片段中,关键参数是比值
α=n1m,其中 m 是集合 Φ 中的句子数量,n1 是使用到的不同普通名词数量。当 α 较小时,自由度较多,可满足性很可能成立;当 α 较大时,约束不断累积,可满足性变得不太可能成立。具有挑战性的区域出现在可满足概率约为 0.5 的点附近。对于包含及物动词的片段,作者还引入
β=n2m,其中 n2 是使用到的不同及物动词数量。在这些情况下,相变区域是 (α,β) 平面中的一个二维区域。
为了将该概念操作化,作者将每个片段 L 的相变区域 λL 定义为满足经验可满足概率位于区间 [0.35,0.65] 的参数组合集合。该区间通过随机采样经验确定。只有当数据点的 (α,β) 坐标,或在仅名词片段中其 α 坐标,落在 λL 内时,才生成数据点。这一过滤步骤至关重要,因为对所有参数进行均匀采样会产生许多可通过简单统计规律而非逻辑结构猜测答案的实例。
数据构造模块将过滤后的参数组合转化为具体的监督示例。对于每个示例,系统采样 n1 个普通名词,对于包含动词的片段还采样 n2 个及物动词。然后,系统从目标片段语法中采样句子模板,并使用采样得到的名词和动词实例化其模式变量。重复该过程 m 次会生成一组句子 Φ={ϕ1,…,ϕm}。相应的一阶公式模板也从相同模板列表和相同采样词汇生成。
每个句子集的标签由对翻译后的一阶表示应用 Z3 定理证明器自动产生。如果 Z3 判定公式集可满足,则数据点获得标签 Y;否则获得标签 N。这会产生一个带有机器验证逻辑真值标准的大规模自然语言推理问题数据集。对于每个片段,作者构建包含 120K 个示例的训练集、包含 10K 个示例的评估集和包含 10K 个示例的测试集。该协议被设计为可复用于任何通过句子模板和公式模板定义的语言片段。
TLM 训练流程使用这些数据集进行监督微调。模型接收 Φ 的自然语言句子作为输入,并被训练预测与该集合关联的可满足性标签。由于输入和标签直接由形式化片段生成,监督信号反映逻辑有效性或可满足性,而不是表面风格线索。作者还通过从相同片段构造额外问题实例、从指定范围选择名词和动词集合、并将句子嵌入基于模板的提示中,来评估零样本和基于提示的设置。定理证明器为评估提供目标标签。因此,总体方法将形式语义脚手架、考虑相变的实例过滤、自动定理证明器标注,以及对 TLM 在逻辑相关自然语言任务上的受控微调或提示结合起来。
实验
该研究通过微调 T5 和 DeBERTa 于平衡语言片段、联合混合片段、测试未见过的谓词数量,同时在零样本设置下探测 ChatGPT、GPT-4 和 LLaMA-2,来评估 transformer 语言模型在自然语言可满足性上的表现。微调后的模型在较简单片段上处理得更有效,但性能随着逻辑和语言复杂度增加而下降;只有当数据量足够时,联合训练才有助于复杂片段。模型通常无法泛化到更大实例,而零样本模型,尤其是 GPT-4,仅相对于随机猜测有适度提升,并且仍对提示格式和变量数量敏感,表明它们未能可靠学习底层推理规则。
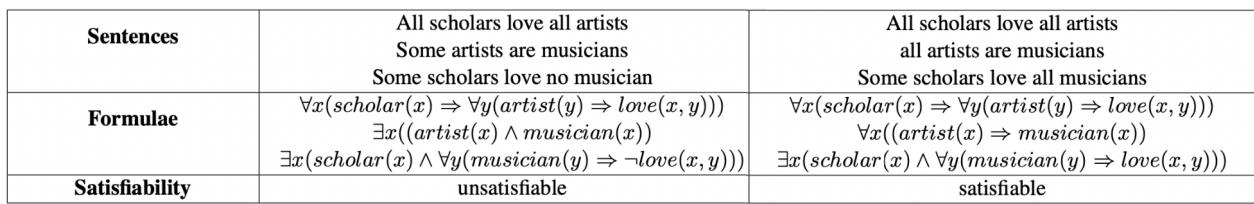
两个自然语言逻辑示例显示,量化语句中的微小变化即可使矛盾情景变为一致情景。相关实验报告 GPT-4 是所评估模型中最强,且是唯一明显高于随机猜测的模型。报告的准确率在问题使用更多变量时下降,这表明更大的搜索空间和更长的输入带来了更高难度。一个示例不可满足,因为一名学者必须既爱某位音乐家又避免爱所有音乐家。另一个示例可通过假设存在学者、所有艺术家都是音乐家、且每个人彼此相爱来满足。GPT-4 被描述为优于其他评估模型,并更擅长严格输出格式。
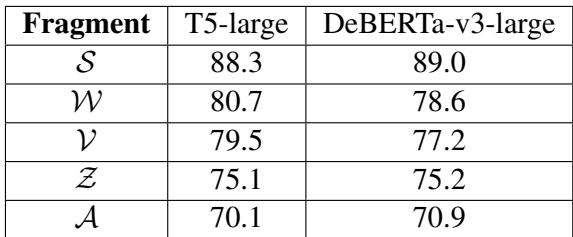
微调后的 transformer 语言模型在较简单片段中比在较困难片段中更准确地求解自然语言可满足性问题。其准确率在从最简单片段移动到下一个片段时下降最陡峭,随后随着复杂度增加而更平缓地下降。两个被评估模型表现出大体相似的行为,表明计算复杂度而非模型选择主要决定性能。准确率在最简单片段最高,在最复杂片段最低。性能差距在最简单片段与下一个片段之间最大,后续下降幅度较小。
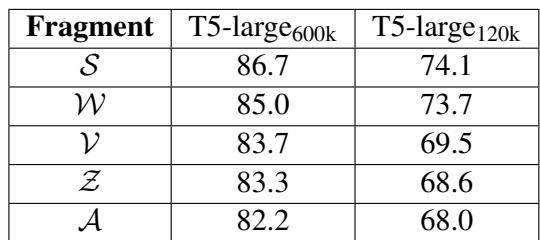
当 T5-large 在所有片段的实例上训练时,更大的混合训练数据集在每个语言片段上都提升了测试准确率。使用更多训练数据带来的准确率提升在各片段之间一致,而各片段之间的性能仍然较为接近。600K 混合训练变体在所有报告的片段上都优于 120K 变体。在所有片段数据上训练会产生跨片段较为接近的准确率,而不是显著的片段特异性差异。
当 T5-large 在更小规模的问题上训练并在更大规模的问题上评估时,其准确率未能良好迁移。性能下降出现在所有语言片段中,包括模型此前取得相对较高准确率的片段,表明系统性泛化能力有限。在包含比训练数据中更多谓词和从句的问题上评估时,准确率下降。泛化失败并不仅限于最复杂片段。结果表明,T5-large 更依赖训练分布模式,而非已学到的推理规则。
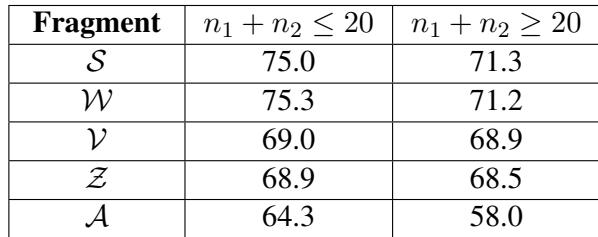
实验评估了模型在自然语言可满足性任务上的表现,包括量化推理示例和复杂度递增的语言片段。GPT-4 优于被评估模型,并且是唯一明显高于随机猜测的模型,而准确率通常随着问题涉及更多变量和更高逻辑复杂度而下降。使用更大的混合数据集训练可提升跨片段性能并减少片段特异性差异;而在更小问题规模上训练、在更大问题规模上评估则导致显著下降,表明系统性泛化有限。