Command Palette
Search for a command to run...
大语言模型能否成为优秀的情感支持者?缓解情感支持对话中的偏好偏差
大语言模型能否成为优秀的情感支持者?缓解情感支持对话中的偏好偏差
Dongjin Kang Hyunsouk Cho Sunghwan Kim Youngjae Yu Taeyoon Kwon Dongha Lee Seungjun Moon Jinyoung Yeo
摘要
情感支持对话(ESC)旨在通过日常对话缓解个体的情绪困扰。鉴于该任务固有的复杂性和非直观性,ESConv 数据集引入了支持策略以促进恰当回复的生成。近年来,尽管大语言模型(LLMs)展现出卓越的对话能力,已有研究表明它们往往难以为用户提供有效的情感支持。因此,本文首先分析了 LLMs 在 ESConv 上的表现,揭示了其在正确策略选择方面的困难以及对特定策略的显著偏好。基于此,我们探讨了 LLMs 中固有偏好对情感支持的影响,发现对特定策略表现出高偏好会阻碍有效的情感支持,并削弱其在预测恰当策略方面的鲁棒性。此外,我们开展了一项方法论研究,以期为 LLMs 成为合格的情感支持者提供必要途径的见解。研究结果表明:(1)对特定策略的低偏好会阻碍情感支持的推进;(2)外部辅助有助于减少偏好偏差;(3)仅凭现有 LLMs 无法成为优秀的情感支持者。这些发现为未来提升 LLMs 情感智能的研究提供了有前景的方向。
一句话总结
延世大学和亚洲大学分析了 LLM 在情感支持对话中的偏好偏见,表明对特定支持策略的过度偏好会削弱稳健性,外部辅助可以缓解这种偏见,而仅依赖现有 LLM 还不能成为胜任的情感支持者。
核心贡献
-
在 ESConv 情感支持任务上分析大语言模型,提出了策略熟练度、偏好和偏好偏见指标,揭示模型会偏向某些策略,而偏好偏见会影响稳健的策略预测。
-
一项方法研究将探索、安慰和行动阶段中的偏好偏见与有效的情感支持联系起来,并且其与接触假说的关联表明,外部辅助可以降低偏好偏见。
-
与心理学家共同制定的标准以及广泛的人工评估表明,较低的偏好偏见与更高分和更少的低质量回复相关,这表明降低偏好偏见能够提升情感支持的感知有用性。
引言
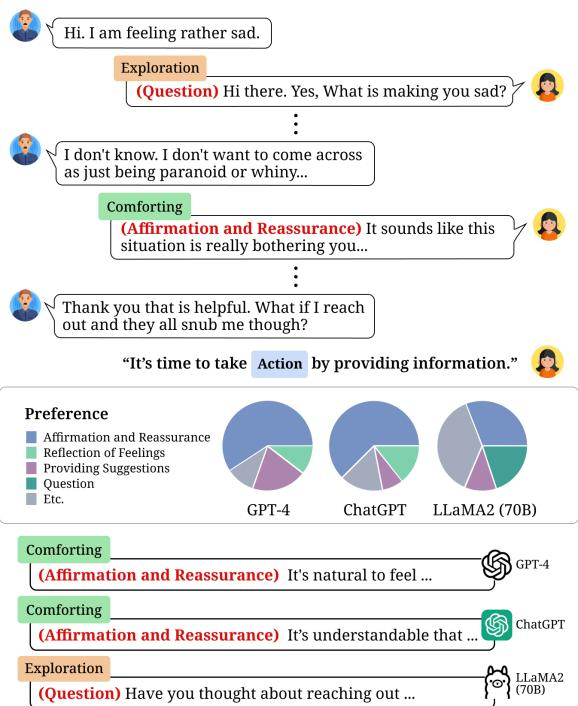
情感支持对话系统需要利用八种支持策略,引导处于痛苦中的用户经历探索、安慰和行动阶段,因此策略选择是否恰当非常重要,因为糟糕的回复可能加剧情绪困扰。此前工作通过架构改动或微调来改进这些系统,但这类方法不易应用到大语言模型;近期 LLM 展现出很强的对话能力,但在预测支持策略方面仍然较弱,部分原因是它们对少数策略存在偏好偏见。作者分析了不同 LLM 中的这种偏好偏见,引入了聚焦策略的熟练度、偏好和偏见指标,并证明符合接触假说的外部辅助能够降低偏见。他们还与心理学家共同构建评估标准,并表明较低的偏好偏见会通过减少低质量回复来提升情感支持质量。
数据集
-
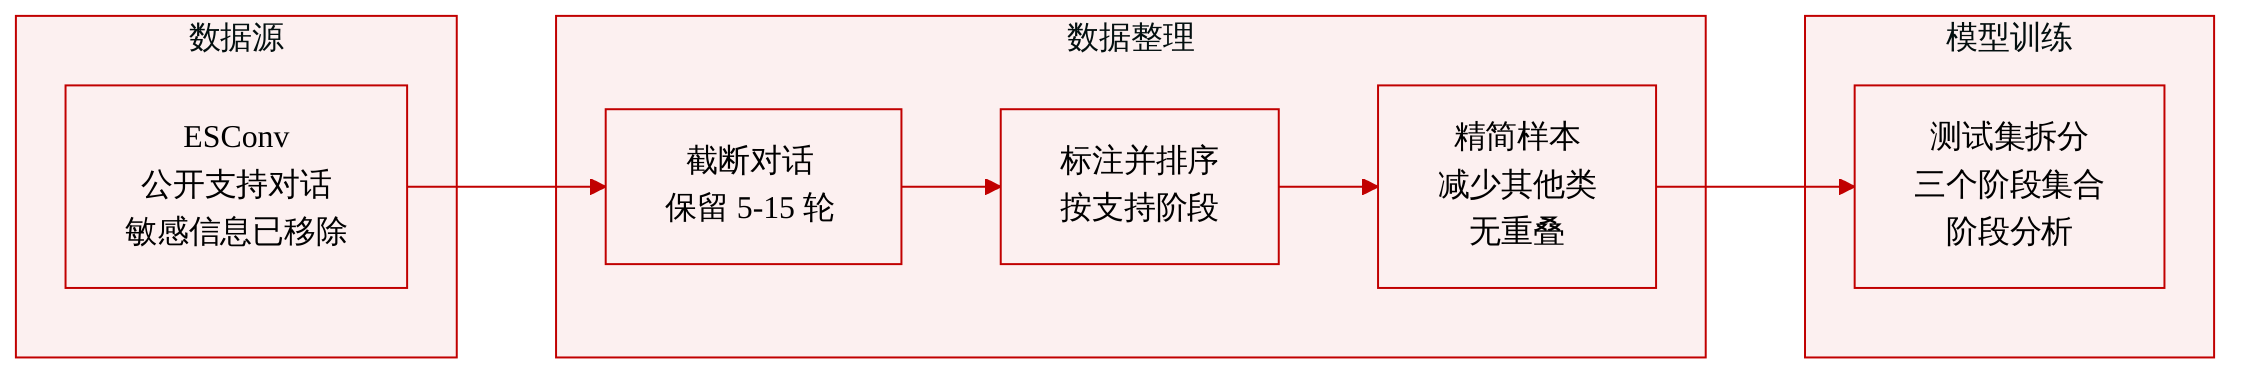
作者使用 ESConv 作为评估集的来源,这是情感支持对话的公开基准。ESConv 由雇佣的众包工作者采集,并在数据集构建过程中过滤了敏感或隐私信息。
-
为进行更全面分析,作者基于 ESConv 中定义的阶段构造了三个测试集,记作 Dt。
-
为构建每个测试集,作者随机将 ESConv 对话截断为包含 5 到 15 轮的样本。
-
每个截断样本都会标注一个 ESConv 阶段,随后样本按照该阶段进行分类。
-
作者降低与策略 “Others” 相关的样本比例,以减少与情感支持相关性较低的回复。
-
作者进一步移除部分样本,以确保各测试集之间不存在对话重叠。
-
这些评估集被用作分阶段分析的测试数据。原文未说明训练集划分、混合比例,或除上述对话截断与过滤之外的其他裁剪策略。
方法
作者围绕“接触”这一降低偏好偏见的机制组织缓解研究。在这一框架下,当模型重新审视自身初始回复,或获得能够拓展回复上下文的辅助证据时,偏见可以得到减弱。为检验这一思想,研究评估了两类代表性大语言模型:作为闭源系统的 ChatGPT,以及作为开源系统的 LLaMA2-70B。所提出的缓解方法分为两大类:自接触方法仅依赖模型内部生成与修正能力;外接触方法则通过外部知识或规划信号增强生成。
自接触流程将模型视为自身的评审者和推理者。对于用户查询或对话上下文 x,模型先生成初始回复
y0=M(x).在 Direct-Refine 变体中,随后要求同一模型直接修正该回复:
y1=Refine(x,y0).该方法不会引入新信息或外部反馈。它只测试第二次处理模型自身答案时,能否降低最初带有偏见的偏好。
Self-Refine 变体增加了显式反馈循环。生成第一次回复后,模型会生成对自己答案进行批评或评估的反馈,
f=Feedback(x,y0),然后基于原始回复和反馈生成修正后的答案:
y1=Refine(x,y0,f).这为方法提供了与模型自身失效模式之间的内部“接触”。模型会在生成最终回复前,被鼓励对初始答案进行反思。
Emotional-CoT 方法改变推理路径,而不是事后进行修正。模型不会直接生成回复,而是先生成用户内在状态或情绪状况的表示,
z=EmotionalState(x),然后基于该状态生成最终回复:
y1=Generate(x,z).这一设计旨在让模型对情绪线索更敏感,并通过将回复建立在关于用户处境的显式推理步骤之上,减少带有偏见或过于简单的回复。
外接触流程超越了纯内部修正。作者引入外部信号,使目标模型能够基于更广泛的上下文指导进行回复,而不仅依赖内部先验。一个组件使用外部常识知识,即 COMET,以提供额外的情境或社会信息。另一个组件使用经过 LLaMA2-7B 微调得到的策略规划器,根据对话上下文建议系统下一步应采取的支持性行动。在该设计中,规划器不会直接生成最终答案,而是给出策略方向,
s=Planner(x,k),其中 k 表示外部知识输入,最终 LLM 会基于原始上下文、外部知识和所选策略生成答案:
y1=Generate(x,k,s).这在策略选择和回复生成之间形成了更清晰的分离。规划器将回复约束到更具适应性的支持性行动,而主语言模型负责流畅表达。
外接触流程还包括提示增强。作者通过随机选择四个示例来增加上下文示例数量,对应 n=4,并将扩展后的提示用作生成设置的一部分。这为模型提供了额外示范,能够稳定其行为,并使其接触到更广泛的可接受回复模式。总体而言,该方法结合了两种缓解思路:一种依赖模型内部的迭代自身修正,另一种在最终回复合成之前,通过外部证据和显式规划模块来丰富生成过程。
实验
实验评估将情感支持回复生成建模为“先进行策略预测,再进行回复生成”,使用基于阶段的测试集以及策略熟练度和偏好偏见指标,比较闭源与开源 LLM。实验表明,偏好偏见会导致情感支持各阶段表现不均,并削弱稳健性;自接触方法往往会加深偏见并降低结果,而策略规划器和示例扩展等外接触方法能够降低偏见并提升一致性。人工评估进一步证实,降低偏好偏见能够提升求助者满意度,并减少低质量回复,这表明稳健的策略选择是有效情感支持的核心。
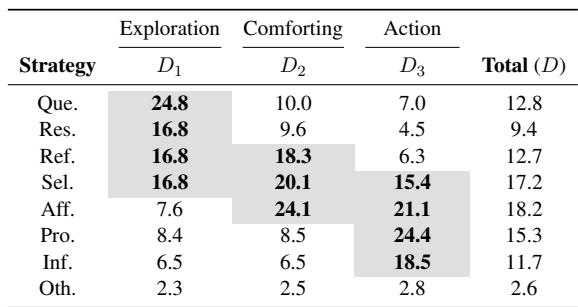
测试集比例显示,情感支持对话在不同阶段包含不同组合的支持策略。提问(Questioning)和复述(Restatement)在探索阶段相对更常见;安慰样本更加重视肯定(Affirmation)和自身披露(Self-Disclosure);行动阶段样本更常与提供(Provision)或建议(Suggestion)策略相关联,同时肯定仍然重要。提问在探索阶段最突出。安慰样本强调肯定,行动样本强调提供。
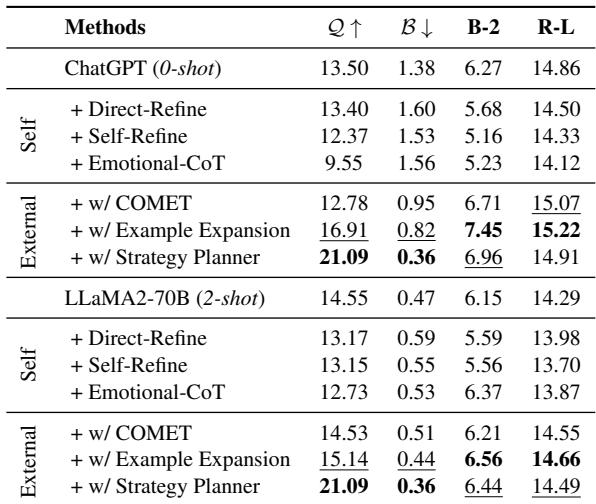
比较显示,内部修正方法往往会降低熟练度,并相对于基础模型加剧偏好偏见,这表明依赖模型自身推理并不能可靠地改善情感支持。提供外部策略信息的方法通常能提升测得指标,其中策略规划和示例扩展尤为突出。这些结果表明,直接的外部指导比常识知识或反复内部修正更有用。内部修正方法相比基础模型会降低熟练度并强化偏好偏见。外部策略辅助会降低偏好偏见并提升回复质量指标。策略规划在熟练度和偏好偏见方面带来最明显的提升,示例扩展也有助于自动质量指标。
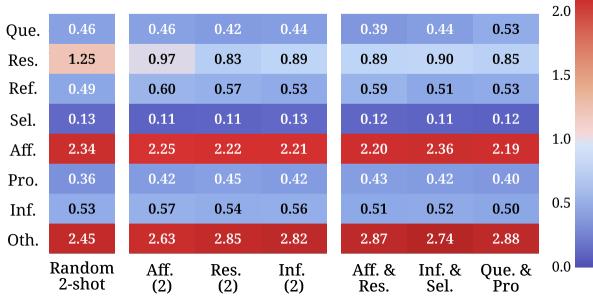
在测试的 ChatGPT 2-shot 设置中,策略偏好并不均匀。偏好模式显示对某些策略存在更强偏见,而另一些策略,尤其是以选择为导向的策略,获得的偏好相对较少。这种不均匀分布支持了更广泛的结论:偏好偏见会削弱情感支持中稳健的策略预测。相比 Selection,偏好更集中于 Others 和 Affirmation 等策略。在不同策略组合中,偏好分布相对稳定,但仍不均匀。观察到的偏好偏见与更广泛趋势一致,即降低偏好偏见会提升情感支持的稳健性。
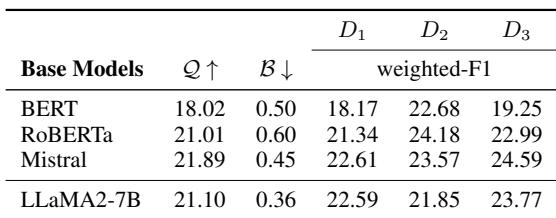
所比较的基础模型在统一策略数据集上进行微调,但在策略选择熟练度与偏好偏见之间表现出不同的权衡。Mistral 在所列模型中取得最强的总体加权 F1,同时保持相对较低的偏见;LLaMA2-7B 的偏见最低,但总体 F1 低于 Mistral。阶段级分数也存在差异,说明总体准确率未能完全反映模型在情感支持各阶段上的稳健性。Mistral 在所列基础模型中给出了最佳总体平衡,其 F1 高于 BERT、RoBERTa 和 LLaMA2-7B,偏见分数也相对较低。LLaMA2-7B 在所列基础模型中偏好偏见最低,但总体 F1 落后于 Mistral。RoBERTa 在总体 F1 上优于 BERT,但偏见更高,这表明熟练度和偏好偏见并不总是同向变化。
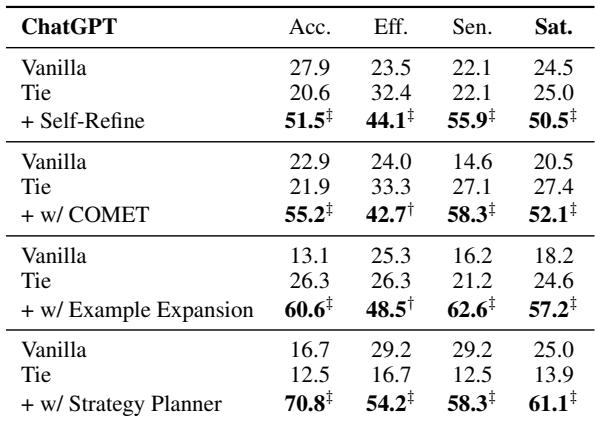
人工评估在接受度、有效性、敏感性和求助者总体满意度方面,比较原生 ChatGPT 与加入额外方法后的系统。自修正和外部辅助都提升了相对原生 ChatGPT 的胜率,但带有 COMET 的外部辅助总体更强,并在接受度和敏感性上尤其突出。这支持了更广泛的结论:降低偏好偏见有助于 LLM 提供更稳健的情感支持。自修正在所有测量的支持维度上,都比原生 ChatGPT 获得更多胜出票。COMET 在提升求助者总体满意度方面超过自修正,同时也提升敏感性。更强的结果对应较低的偏好偏见和更好的情感支持质量。
实验从支持阶段、策略预测模型和人工评估回复等方面评估情感支持对话。研究发现,支持策略会随阶段变化,模型输出也常表现出策略偏好不均,这可能损害稳健的支持预测。与内部修正相比,外部策略指导通常能提升回复质量并降低偏好偏见,而不同基础模型在策略熟练度和偏见之间存在权衡。人工评估进一步表明,能够降低偏好偏见的方法,尤其是外部策略辅助,能够带来更被接受、更敏感且更令人满意的支持。