Command Palette
Search for a command to run...
MultiLegalPile:一个 689GB 的多语言法律语料库
MultiLegalPile:一个 689GB 的多语言法律语料库
Joel Niklaus Veton Matoshi Matthias Stürmer Ilias Chalkidis Daniel E. Ho
摘要
大规模高质量数据集对于训练大语言模型(LLMs)至关重要。然而,目前面向法律等关键专业领域的数据集仍然稀缺,且现有数据集往往规模较小并仅包含英文。为填补这一空白,我们整理并发布了 MultiLegalPile,一个涵盖 24 种语言、来自 17 个司法管辖区、规模达 689GB 的多语言法律语料库。MultiLegalPile 包含多样化的法律数据源,支持在合理使用框架下预训练自然语言处理模型,其中大部分数据采用极为宽松的许可证。我们以多语言方式预训练了两个 RoBERTa 模型和一个 Longformer 模型,并在每种语言的专属子集上分别预训练了 24 个单语言模型,随后在 LEX-TREME 基准上对其进行了评估。此外,我们还在 LexGLUE 基准上评估了英文和多语言模型。我们的多语言模型在 LEX-TREME 上刷新了最优性能(SotA)纪录,英文模型在 LexGLUE 上同样取得了最优性能。我们以尽可能开放的许可证发布了数据集、预训练模型及全部代码。
一句话总结
来自伯尔尼大学、伯尔尼应用科学大学、斯坦福大学及其他合作者的研究者推出 MultiLegalPile,这是一个覆盖 24 种语言和 17 个法域的 689GB 多语言法律语料库,支持在合理使用下预训练 NLP 模型,并在 LEX-TREME 和 LexGLUE 基准上取得新的最先进结果。
核心贡献
- 论文提出 MULTILEGALPILE,这是一个来自 17 个法域、覆盖 24 种语言的 689GB 法律预训练语料库,源自多种法律数据源,支持在合理使用下预训练,且多数数据采用宽松许可。
- 对 XLM-R 检查点继续预训练,得到两个多语言 RoBERTa 法律模型、一个面向长文档的多语言 Longformer,以及基于语言特定子集训练的 24 个单语法律模型。
- 继续预训练在 LEX-TREME 上取得新的最先进 base 和 large 结果,其中 Longformer 在四项任务上达到最先进水平,并获得最高的数据集汇总分数。单语模型在五种语言上将特定语言的最先进水平最多提升 11 个 macro F1 百分点,而英语模型在七项 LexGLUE 任务中的五项上达到最先进水平,且 large 模型取得最高汇总分数。
引言
大语言模型在多样基准甚至专业考试上取得快速进展,但其训练数据仍高度以英语为中心、主要来自网页,且法律许可状况常常不明确。这对法律等专业领域尤为重要,因为法律文本广泛由公共机构产生,并常以宽松许可提供,但大规模多语言法律预训练语料库仍然稀缺。先前的法律语言模型大多聚焦英语,或依赖远小于公共法律体系所能支撑规模的语料库。
研究者针对这一缺口整理 MULTILEGALPILE,这是一个覆盖 24 种语言和 17 个法律体系的大规模多语言法律语料库,大多采用宽松许可。他们在这些数据上继续预训练 XLM-R 和一个 Longformer 变体,得到 LegalXLMs。这些模型在 LEXTREME 和 LexGLUE 上取得新的最先进结果,表明开放、领域专用、多语言预训练能够显著提升法律语言理解。
数据集
-
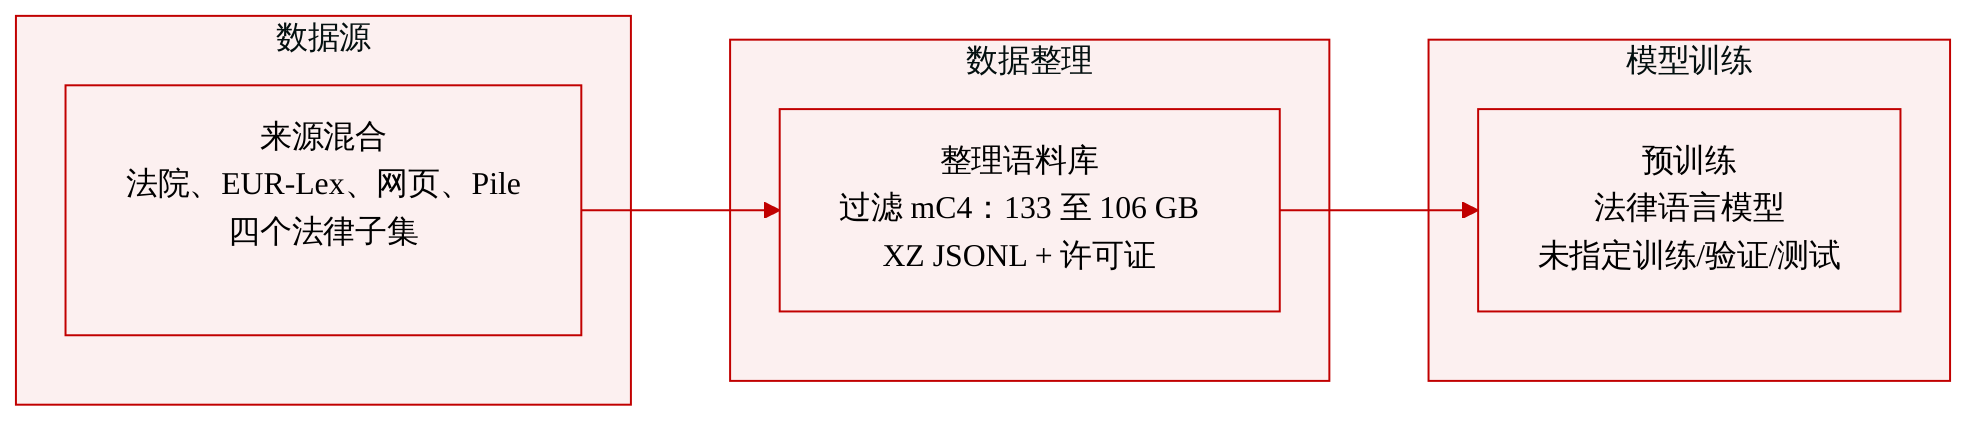
研究者使用 MULTILEGALPILE,这是一个用于预训练法律语言模型的多语言法律语料库,以 XZ 压缩的 JSONL 格式发布,便于高效流式读取。
-
语料库包含四个主要子集:
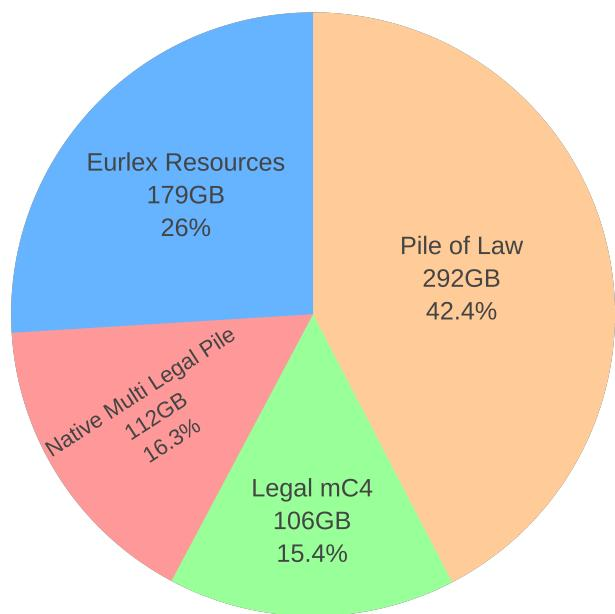
- Native Multi Legal Pile,112 GB,通过抓取法院、行政机关及其他公共或开放资源中的法律来源整理而成。附录描述了 29 个许可证各异的来源,从 CC0 到 CC BY-NC-SA。
- Eurlex Resources,179 GB,来自 EUR-Lex,使用 eurlex R 包生成 SPARQL 查询并下载数据,随后使用 Python 转换为适合大规模处理的格式。
- Legal mC4,106 GB,源自多语言网络爬取数据 mC4,并通过过滤保留法律内容。
- Pile of Law,292 GB,一个已有的以英语为主、主要关注美国的法律语料库,被整合进最终语料库。
-
Legal mC4 子集通过对 mC4 应用正则表达式构建,以识别包含法律引用的文档,例如法条引用或条文标记。研究者将法律引用作为法律内容的信号,对五种语言检索到的文档进行审阅,并通过多次精确率检查改进正则表达式。这使过滤后的语料库从 133 GB 减少到 106 GB。研究者指出,mC4 页面中大约只有千分之一包含法律内容。
-
对于 Native Multi Legal Pile,研究者从可用的法律文本集合中,以宽泛且非完整的方式收集来源。对格式不一致的数据转换为统一格式,例如 JSONL。某些来源需要特定于任务的后处理,例如从 XML 标签中提取文本。
-
语言分布和文本类型主要由少数来源主导。由于整合了 Pile of Law,英语占比超过一半。判例法占比超过一半,部分原因是法院判决广泛可得,尤其在普通法国家。公开可用的合同占比不足 10%。
-
研究者在数据集文档中保留来源级许可信息。MULTILEGALPILE 的整体发布被描述为采用 CC BY-NC-SA,但各子集保留上游许可,包括过滤后 Legal mC4 的 CC BY-NC-SA、CC0、CC BY 和 ODC-BY。
-
在评估方面,论文使用外部法律基准,例如 LEXTREME 和 LexGLUE,涵盖法律分类、合同不公平检测、主题标注、命名实体识别和法院判决预测等任务。这些基准数据集未被描述为 MULTILEGALPILE 训练语料库的一部分。
-
所提供的文本未指定 MULTILEGALPILE 的训练划分、混合比例、模型特定的采样权重或裁剪策略。它主要描述语料库构建、过滤、格式标准化、许可,以及面向法律 NLP 预训练的用途。
方法
研究者采用两阶段流程:首先构建 MULTILEGALPILE 作为法律预训练语料库,随后使用它继续预训练基于 Transformer 的法律语言模型。语料库阶段将所有来源转换为 xz 压缩的 JSONL。来源组成如下图。
对于网页派生部分,流程从 mC4 开始,使用正则表达式定位包含法律标记的文档,例如成文法或判决引用。研究者通过若干语言中由专家协助的精确率检查来改进正则表达式规则。这种过滤有意比学习型分类器更简单,因为在大规模网页语料库上运行正则表达式更快,而法律引用为法律文本提供了高信号指标。本土法律材料通过抓取公共来源、统一格式,并从 XML 等结构化容器中提取文本进行整理。Eurlex 数据通过 SPARQL 查询生成,并转换为相同处理流程,同时现有的英语法律语料库作为额外来源被整合。
模型阶段通过复用现有 XLM-R Transformer 检查点来训练 Legal-XLM-R。这种初始化在法律特化之前提供多语言语言知识。研究者还在法律语料库上训练新的 128K BPE tokenizer。与 XLM-R 重叠的 tokens 复用原始嵌入,而新引入的法律或语言特定 tokens 获得初始化嵌入。该设计保留通用多语言表示,同时增加面向法律术语的词表容量。架构仍为采用掩码语言建模和共享输入输出嵌入的 Transformer 编码器。
该法律语料库在语言和来源之间严重不均衡,因为整合的英语法律语料库贡献了大量 tokens,在总 tokens 中占较大份额。语言分布如下图。
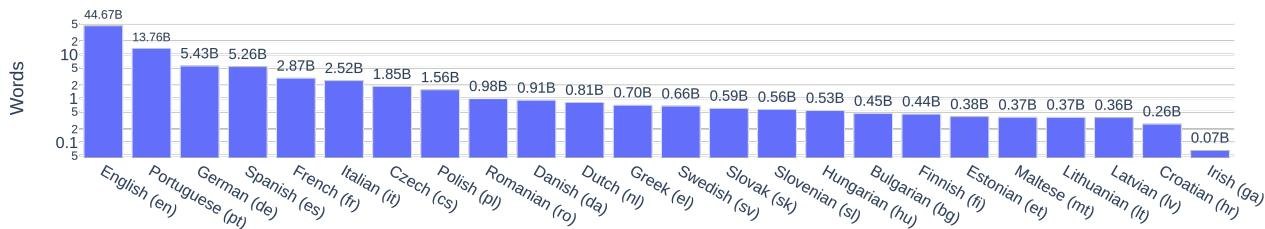
这种不均衡直接影响训练过程。研究者在 tokenizer 训练和继续预训练中,使用带有子语料库采样率指数平滑的句子采样器,目标是保留较小语言和较小法律来源的表达能力,而非让占多数的英语数据主导更新。模型使用混合大小写训练。使用掩码语言建模,并将 base 规模模型的掩码率提高到 20%,将 large 规模模型的掩码率提高到 30%,所有预测均在被掩码的 tokens 上进行。
继续预训练使用 512 条序列的批量。base 规模模型训练一百万步,large 规模模型训练 50 万步。学习率在总步数的前 5% 内线性预热至 ηmax=10−4,随后按余弦调度衰减。在训练的前 2.5% 期间,Transformer 编码器被冻结,只更新嵌入,以稳定从通用多语言嵌入向法律专用词表的过渡。
对于更长的法律文档,研究者将基础多语言模型扩展至 4096 token 上下文,并使用窗口大小为 128 token 的窗口注意力。这一长上下文阶段运行 50,000 步,使用 15% 的掩码概率,并在衰减前将学习率设为 3×10⁻⁵。研究者还在语言特定子集上训练 24 个单语 base 规模模型,使用更小的 32K 词表和 200,000 步,使低资源语言可以多次遍历,并对英语进行扩展训练。
实验
实验在两个长文档法律 NLU 基准 LEXTREME 和 LexGLUE 上评估预训练法律编码器,采用适合任务的设置和宏观 F1 分数。结果表明,法律领域预训练在多语言分类、NER 和案例分析任务中带来广泛增益,其中紧凑的 base 模型可与规模大得多的通用编码器竞争,若干模型创造新的最先进水平。这些发现也表明存在任务敏感性和语言敏感性:长文档模型在某些数据集特定任务上表现最佳,但在高度多语言的汇总指标中表现较弱;单语模型有助于低资源语言;当预训练数据中合同较少时,面向合同的任务收益较少。
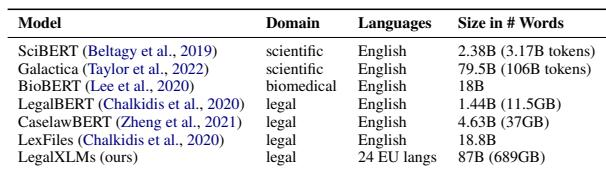
该表总结了先前的领域特定预训练语料库,并显示法律语料库在规模上差异很大,从较小的英语法律集合到更大的科学和多语言法律数据。与此前法律语料库相比,本次引入的法律预训练语料库明显更大,且覆盖语言多得多,支持多语言法律语言建模。所引用的实验表明,在该语料库上预训练的模型与通用基线相比具有竞争力或更好,在若干法律任务和低资源语言上尤其有明显增益。该多语言法律预训练语料库比此前法律语料库更大,语言覆盖也更广。预训练法律模型在许多任务上优于通用基线,但某些任务因超参数或领域覆盖而落后。
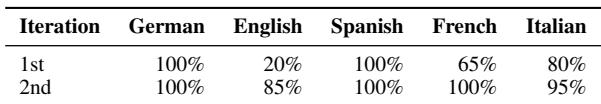
经过两轮人工评估,经正则表达式过滤的法律 mC4 文档在语言之间显示出显著差异。第一轮中,德语和西班牙语的精确率已经很高,英语则低得多。在第一次审阅后改进正则表达式,提高了英语、法语和意大利语的精确率,同时保持德语和西班牙语已经很强的结果较高。改进后的过滤减少了语料库规模,但使检索到的法律内容更具体。德语和西班牙语的法律引用始终以高精确率被检测出。在正则表达式经过改进后,英语精确率大幅提升。法语从第一轮的中等精确率提升到第二轮的完美结果。意大利语精确率在第二轮评估中从较高提升到非常高。
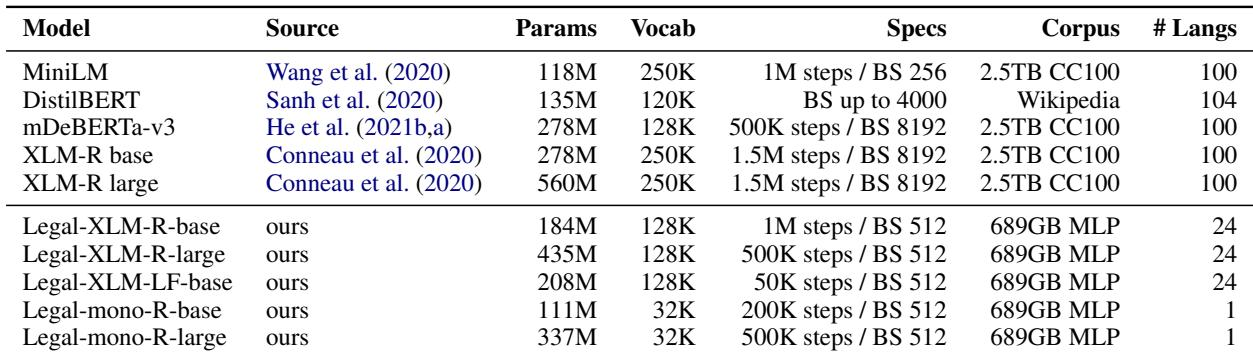
模型对比表明,Legal-XLM-R 变体是在覆盖 24 种语言的法律语料库上训练的法律专用编码器,不同于在远更广泛语料库上训练的通用多语言模型。它们相比若干强基线使用更少参数和更小词表,却达到等于或优于更大通用模型的结果,其中大型法律模型带来较小的总体优势。法律 Longformer 在序列处理方面是例外,支持比其他模型长得多的输入。Legal-XLM-R-base 达到与规模大得多的通用模型相当的结果。这些法律模型用更广泛语言覆盖换取 24 种语言上的法律领域特化。法律 Longformer 支持比短上下文模型长得多的文档输入。
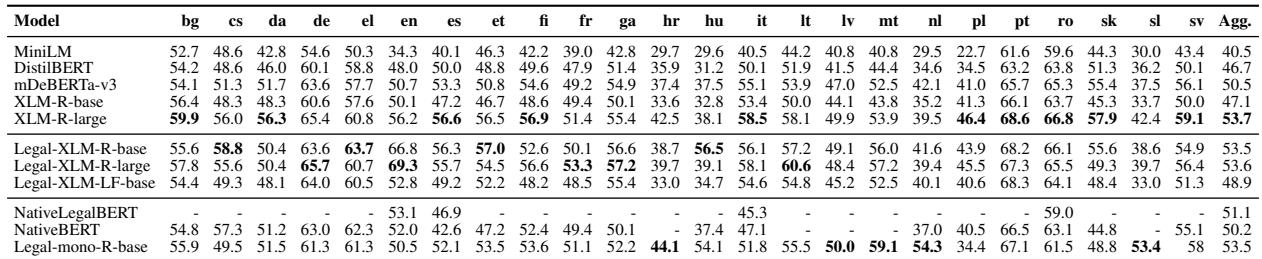
总体宏观 F1 结果显示,法律模型非常接近 XLM-R-large,其中 base 模型几乎匹配更大的基线,尽管仅使用约三分之一的参数。Legal-XLM-R-large 是总体最强的法律变体,而各语言列显示增益在不同设置中并不均匀。这表明法律领域预训练能够提供具有竞争力的总体表现,但未能完全超过大型通用多语言模型。Legal-XLM-R-base 在使用远少于 XLM-R-large 的参数时,仍具有竞争力。Legal-XLM-R-large 在法律变体中领先,但语言层面的增益仍然混杂。
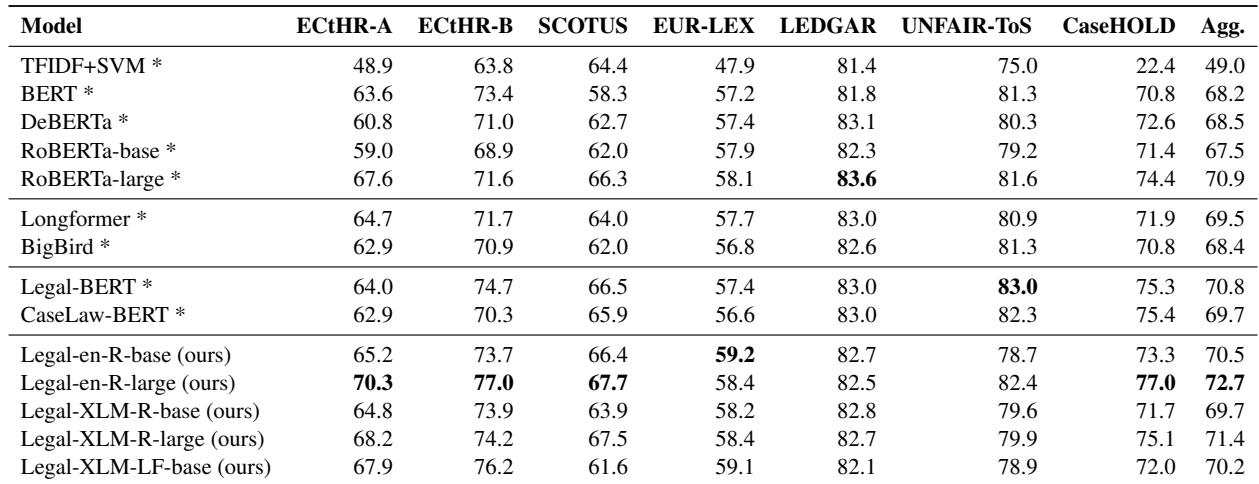
这些结果比较法律领域模型与通用编码器在法律分类任务上的表现。法律模型在 ECtHR、SCOTUS、EUR-LEX 和 CaseHOLD 上取得新的最佳结果,同时在 LEDGAR 和 UNFAIR-ToS 上匹配通用编码器。在所列基线中,Transformer 模型明显强于 TFIDF+SVM,而 RoBERTa-large 总体最强。法律模型在 ECtHR、SCOTUS、EUR-LEX 和 CaseHOLD 上创造新的最佳分数。LEDGAR 和 UNFAIR-ToS 上的法律模型增益较弱,可能与合同覆盖有限有关。在所列通用基线中,RoBERTa-large 的总体分数最高。
实验针对法律分类和汇总任务,评估一个大型多语言法律预训练语料库和 Legal-XLM-R 编码器相对于通用多语言基线的表现。数据质量检查表明,经过改进的过滤在各语言中产生更精确的法律内容,尤其是在迭代人工审阅之后,同时保留初始精确率较高语言的强结果。总体而言,法律领域预训练能够实现与更大通用模型相当甚至更好的性能,其中 base 模型表现出显著效率,长上下文变体支持更长输入,但增益在不同语言之间仍不均衡,且某些合同相关任务收益有限。