Command Palette
Search for a command to run...
IRCoder:中间表示使语言模型成为鲁棒的多语言代码生成器
IRCoder:中间表示使语言模型成为鲁棒的多语言代码生成器
Indraneil Paul Goran Glavaš Iryna Gurevych
摘要
代码生成已迅速成为语言模型(LM)最流行的应用之一。然而,关于代码语言模型(Code-LM)多语言方面的研究——例如不同编程语言之间的跨语言迁移、语言特定的数据增强、模型事后适配,以及对原始文本内容以外数据源的利用——远比自然语言模型领域稀疏。特别是,大多数主流 Code-LM 仅在源代码文件上进行预训练。在本工作中,我们探索利用易于获取的编译器中间表示(IR)——该表示在不同编程语言间共享——来提升 Code-LM 的多语言能力并促进跨语言迁移的前景。为此,我们首先构建了 SLTrans,这是一个由近 4M 个自包含源代码文件及其对应中间表示组成的平行数据集。接下来,我们从多种基座 Code-LM(参数规模从 1.1B 到 7.3B 不等)出发,在 SLTrans 上进行持续的因果语言建模训练,迫使 Code-LM(1)学习 IR 语言,(2)将 IR 构造与各种编程语言中的对应构造进行对齐。所得模型被命名为 IRCoder,在各种代码生成任务和指标上展现出显著且一致的性能提升,包括提示鲁棒性、多语言代码补全、代码理解和指令遵循。
一句话总结
德国达姆施塔特工业大学的 UKP Lab 与维尔茨堡大学提出 IRCoder,这是一组代码语言模型,通过在 SLTrans 这一近乎 4M 规模的并行数据集上进行继续因果语言建模训练得到;该数据集将自包含源文件与其编译器中间表示配对,以在不同编程语言之间对齐 IR 构造,从而提升多语言代码生成、跨语言迁移和 prompt 鲁棒性。
核心贡献
-
引入 SLTrans,一个包含 26.2B token 的并行数据集,覆盖 12 种编程语言的近 400 万个自包含源文件及其编译器中间表示,将源代码到 IR 的对齐从短函数片段扩展到完整文件级程序。
-
通过在 1.1B 到 7.3B 参数的基础 Code-LM 上对并行源代码与中间表示数据进行继续预训练来开发 IRCoder,迫使模型学习 IR 生成,并将 IR 构造与多种编程语言中的构造对齐,且不改变架构或增加辅助目标。
-
证明 IRCoder 在 prompt 鲁棒性、多语言代码补全、代码理解和指令遵循方面带来一致提升,表明即使使用规模较小的继续预训练数据集,共享中间表示也能提升多语言代码模型性能。
引言
作者针对代码语言模型中的一个核心缺口展开研究:尽管代码语言模型有潜力自动化软件开发,但基准测试和性能优化长期集中于 Python 等高资源语言,而真实代码库中包含许多流行但表示不足的语言。这种失衡具有重要意义,因为编程语言流行度变化迅速,某些关键语言可能在预训练语料中稀缺或缺失,从而使模型在异构软件生态中的可靠性下降。
以往工作通过多语言或面向跨语言翻译的基准部分暴露了这些缺口,但跨语言性能仍然不均衡,并且关于编程语言对齐的研究有限。现有使用编译器工件的工作通常关注狭窄任务、短上下文或特定工具链,尚未充分说明共享代码表示能否在不改变模型架构的情况下广泛提升鲁棒性和多语言迁移能力。
作者提出一种语言无关的方法,将编译器中间表示作为源代码理解的中介语。他们引入大规模并行源代码和 IR 数据集 SLTrans,并通过在混合并行和单语数据上继续预训练构建 IRCoder 模型系列。实验结果显式 IR grounding 可以提升 prompt 鲁棒性、多语言代码补全、代码理解和指令遵循。
数据集
-
数据集: SLTrans 是一个从源代码到 LLVM IR 的翻译并行数据集。作者使用它来学习和评估编程语言源代码与 LLVM 中间表示之间的翻译。
-
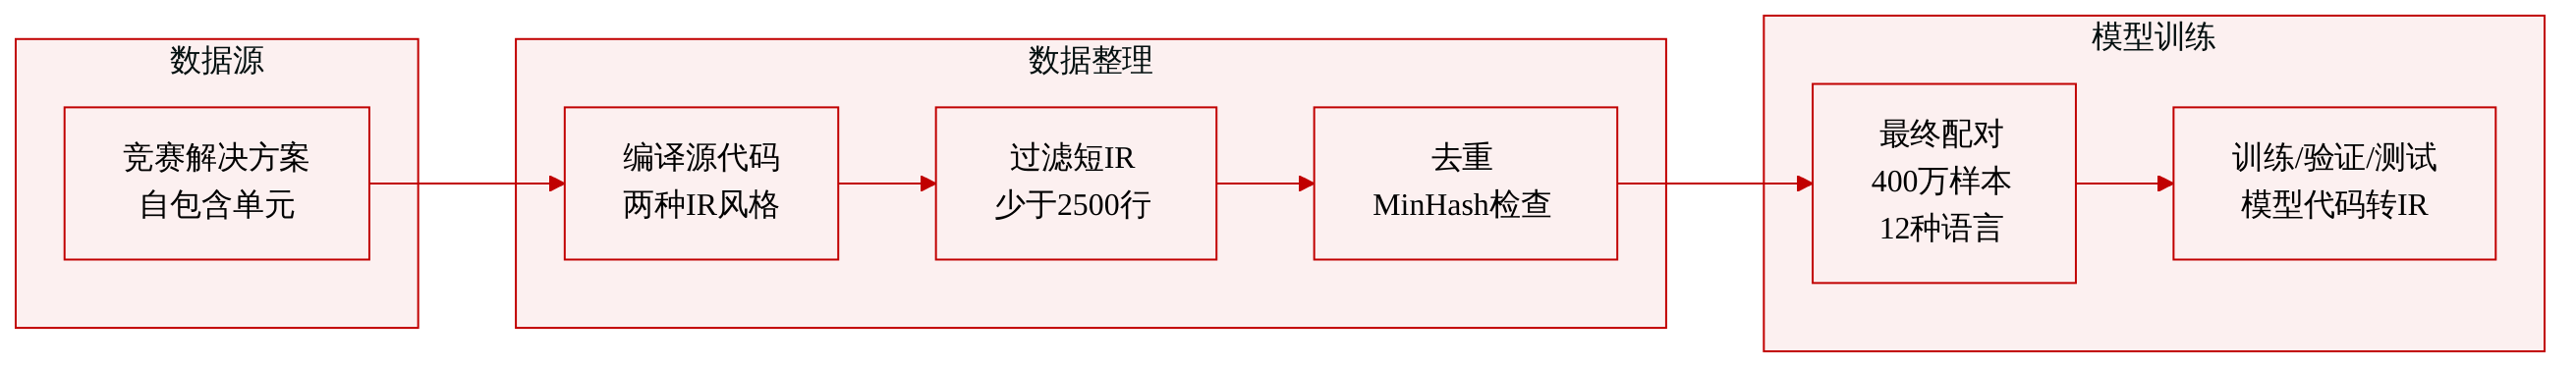
数据来源: 数据来源于编程竞赛问题的被接受解答。作者选择这些数据,是因为它们通常是自包含编译单元,并且避免了使自由形式 GitHub 代码难以编译的依赖追踪问题。
-
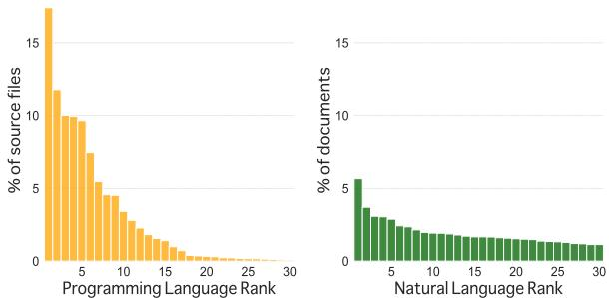
语言覆盖: 数据集覆盖低、中、高资源编程语言的混合样本。总体包含约 400 万个样本,覆盖 12 种编程语言,总计 26.2 billion tokens。
-
IR 目标: 每个源文件会被编译为两种 LLVM IR 变体:相当于
-Oz优化级别的大小优化 IR,以及相当于-O3优化级别的性能优化 IR。文中说明,大小优化变体更适合更大的推理上下文窗口,并在不同语言之间更统一;性能优化变体则更常见于开放域代码语料。 -
过滤规则: 作者仅保留 IR 短于 2500 代码行的样本。这限制了序列长度,使数据更容易被语言模型处理。
-
去重: 由于编程竞赛解答常常包含近似重复内容,作者在构建最终数据集之前使用基于 MinHash 的去重来降低冗余。
-
处理重点: 数据管线强调完整、可编译、无依赖的源单元以及并行 IR 抽取。这避免了文件或仓库级依赖问题,并允许作者收集完整编译单元,而不只是片段或函数。
-
数据集用途: 作者将 SLTrans 作为源代码到 LLVM IR 建模的并行翻译对。通过收集大小优化和性能优化两种 IR,他们可以在语言建模过程中研究不同 IR 风格并进行权衡。
方法
方法通过将编译转化为结构化数据生成管线,来构建并行源代码和 LLVM IR 语料。作者选择 LLVM IR 作为目标表示,因为 LLVM IR 被编译器前端广泛支持,具有稳定且可读的结构,并可以被视为语言建模的可学习序列。该管线不会从任意仓库文件中采样,而是聚焦于可以在不执行大量依赖解析的情况下可靠编译的自包含程序。
数据管线的第一个模块从被接受的编程竞赛解答中收集完整编译单元。这些单元很有用,因为它们通常独立运行,并避免跨文件导入或外部包依赖,而这些都是编译大型软件仓库爬取代码时常见障碍。这一选择步骤降低了特定语言依赖追踪的需求,并使整程序编译成为可能,而不是依赖孤立函数或片段。
第二个模块将每个所选源文件编译为两种 LLVM IR 变体:一种大小优化变体,对应与 -Oz 类似的优化级别;一种性能优化变体,对应与 -O3 类似的优化级别。这种双重编译策略捕捉同一程序的两种互补视图。大小优化 IR 更紧凑,可能更适合长上下文建模;性能优化 IR 更能代表现实世界编译器工作流中常见遇到的 IR。
第三个模块应用过滤,保留适合训练和推理的样本。超过 2500 代码行的 IR 输出会被丢弃。这一步骤避免过长编译结果主导数据集,并帮助保持更容易在模型训练和部署期间处理的序列长度。
最后阶段使用基于 MinHash 的去重来移除近似重复程序。编程竞赛解答通常包含许多结构相似提交,因此这一步过滤在保留语言构造和编码模式有用覆盖的同时减少冗余样本。这些步骤共同构成一个可重复工作流,通过受控编译、优化配置、长度过滤和近似重复抑制,将可执行源文件转换为对齐的 source-to-IR 训练对。
实验
作者在配对的源代码和 LLVM IR 上继续预训练多个代码语言模型,然后将其与仅用源代码或未配对 IR 数据训练的模型在代码补全、prompt 扰动、多语言理解和指令遵循任务上进行比较。实验显式通过共享 IR 对齐不同语言代码比仅仅让模型接触 IR 更有益,收益扩展到鲁棒 prompt 处理、多语言代码生成和理解以及指令遵循,尤其对低资源语言。总体而言,IR grounding 似乎有助于模型捕捉语义和数据流结构,而非表面线索,从而在各类评估中带来一致提升。
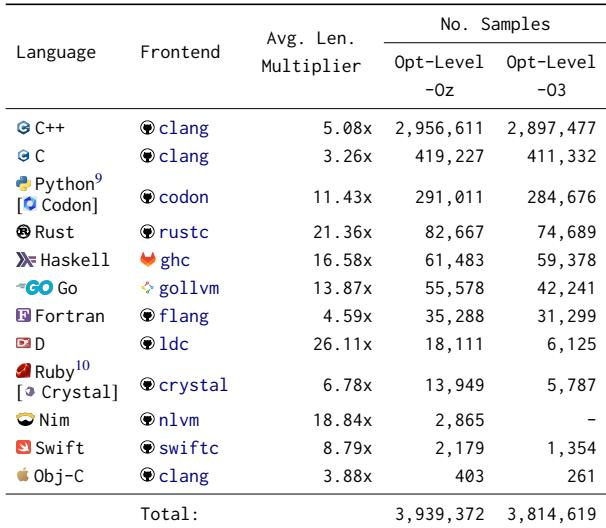
表格显示 SLTrans 使用不同编译器前端将多种编程语言源代码与 LLVM IR 配对。C++ 和 C 提供最大的样本集合,而 Rust、Haskell 和 Python 贡献较小但仍相当可观的集合。生成 IR 相对长度在不同语言之间差异很大,Rust 每个源单元产生的 IR 最长,C 或 C++ 产生的 IR 短得多。C++ 的并行样本数量最多,其次为 C。Rust 的 source to IR 长度倍数最大,但贡献样本数远少于 C++。改变优化级别通常保持样本数量不变,但 Go 在不同级别之间显示出最明显的下降。
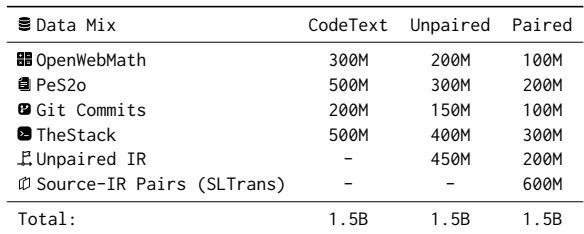
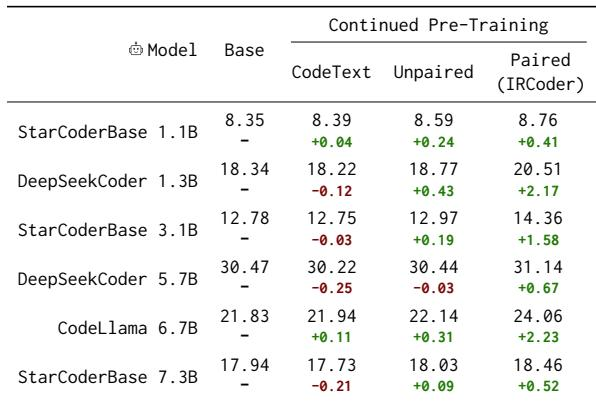
表格比较三种总规模相同的训练混合,通过在不同组成之间移动数据来比较代码、文本、未配对 IR 和配对 source-IR 数据。Paired 混合因其包含对齐 source-IR 样本并减少其他数据成分以容纳这些样本而具有特色。Unpaired 混合测试未配对的 IR 暴露,而 CodeText 混合不包含任何 IR 数据。只有 Paired 混合包含 source-IR 配对。Unpaired 混合加入未配对 IR,但不保留任何对齐 source-IR 样本。CodeText 混合仅依赖代码和文本源,不包含 IR 组件。
在所有测试的基础代码模型上,添加配对源代码和 IR 数据在多语言代码补全基准上带来最大 pass@1 提升。添加未配对 IR 数据也有帮助,但提升较小;仅继续用额外源代码数据训练收益很少,甚至可能轻微损害某些模型。这表明将源代码与 IR 对齐比简单让模型接触 IR 或更多代码更有用。所有测试模型变体中,配对源代码和 IR 训练优于基础设置和未配对设置。与基础模型相比,未配对 IR 训练只带来适度提升,表明仅接触 IR 不够。在若干模型上,仅继续用源代码训练的效果与基础设置相似或略差。
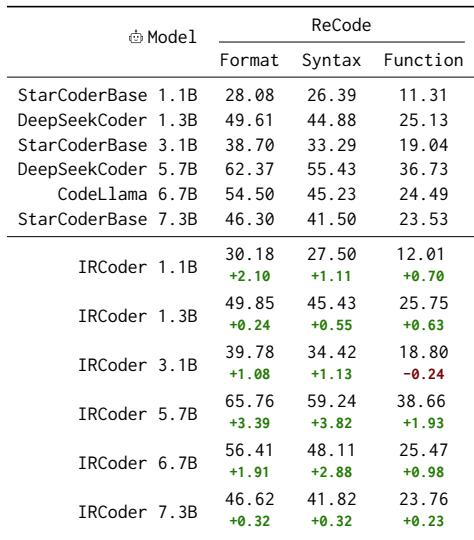
ReCode 修复结果比较 IRCoder 及其基础模型在格式、语法和函数扰动上的平均 pass@1。基础模型分数显式格式扰动最容易处理,语法扰动较难,函数级修复最具挑战性。所报告比较显式 IR grounding 使 IRCoder 相对相应基础模型有所改善。格式扰动产生最高 pass@1,其次是语法扰动,函数扰动最困难。同一模型家族中更大的基础变体通常取得更强修复性能。IR-grounded IRCoder 与基础模型一起评估,并在 ReCode 修复任务上显示收益。
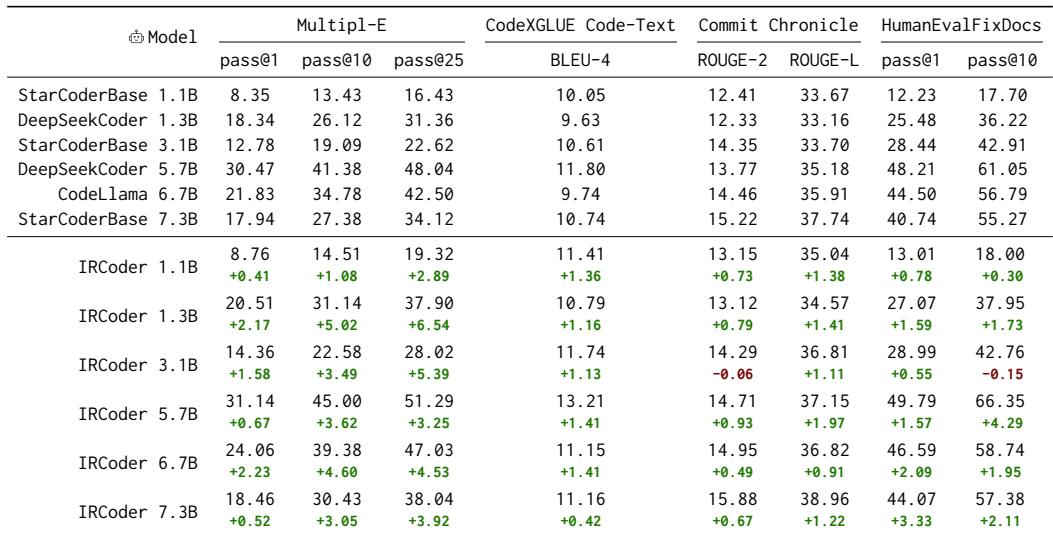
表格显式 IRCoder 在代码补全、code-to-text 和指令遵循评估中相对于相应基础 Code-LMs 提升多语言代码性能。增益跨模型家族和规模出现,最大提升通常出现在更大或更强的基础模型上。结果支持这样的观点:将源代码 grounding 在 IR 中有助于模型跨编程语言和更高层代码概念泛化。IRCoder 在多语言代码生成和代码理解任务中持续优于相应基础 Code-LMs。最大性能提升观察到于更强的基础 Code-LMs。改进扩展至多个多语言基准,包括代码补全、code-to-text 和指令遵循。
实验在多种语言上构建 SLTrans 配对,并比较规模相同的训练混合,以评估对齐 source-IR 数据、未配对 IR 暴露,或额外源代码和文本数据对代码模型的最大收益。结果表明,配对 source-IR 训练在多语言补全、修复和理解任务上始终带来最大定性提升,而未配对 IR 收益较小,额外仅源代码训练效果有限或负面。总体显式将源代码 grounding 在 IR 中有助于提升泛化和鲁棒性,对更大或更强的基础模型收益尤其明显。