Command Palette
Search for a command to run...
为什么敏感函数对 Transformers 而言如此困难?
为什么敏感函数对 Transformers 而言如此困难?
Michael Hahn Mark Rofin
摘要
实证研究已经识别出 Transformers 的一系列可学习性偏差和局限性,例如在学习简单形式语言(如 PARITY)方面存在持续的困难,以及对低次函数的偏好。然而,理论理解仍然有限,现有的表达能力理论要么高估、要么低估了实际的泛化能力。我们证明,在 Transformer 架构下,损失景观受到输入空间敏感性的约束:输出对输入字符串中多个部分敏感的 Transformers 占据了参数空间中的孤立点,从而导致泛化中的低敏感性偏差。我们从理论和实证两方面表明,该理论统一了关于 Transformers 泛化能力与偏差的大量实证观察结果,例如其向低敏感性和低次函数的泛化偏好,以及在 PARITY 上的长度泛化困难。这表明,理解 Transformers 的归纳偏置不仅需要研究其理论表达能力,还需要研究其损失景观。
一句话总结
萨尔兰大学证明,Transformer 损失格局受输入空间敏感性约束,因为输出依赖于大量输入位置的函数会占据参数空间中的孤立点。这一结果统一了关于低敏感性偏置、次数偏置以及学习 PARITY 困难的实证观察,并表明理解归纳偏置需要在表达能力之外研究损失格局。
核心贡献
- Transformer 损失格局把高输入空间敏感性约束到孤立的尖锐极小值,从而形成向低敏感性的泛化偏置。
- 该理论把输入敏感性与 Fourier 次数联系起来,解释了更容易学习 FIRST 和 MEAN,以及学习 PARITY 和长度泛化更困难的原因。
- 对形式语言函数的实验支持该理论,并将研究重点从原则性表达能力转向定量损失格局分析,以理解 Transformer 偏置。
引言
Transformer 广泛用于序列建模和形式语言任务,但实验揭示了令人意外的学习偏置。特别是 Transformer 常常难以处理高敏感性函数,例如 PARITY,其中翻转任意输入位都会改变输出,并且训练得到的解常常无法从短输入泛化到更长的输入。先前的理论工作主要研究表达能力,表明某些 Transformer 变体原则上可以表示 PARITY,或者单个输入位可能只有有限影响,但这些结果没有解释为什么在梯度下降下学习这些函数仍然困难。作者通过把输入空间敏感性与 Transformer 损失格局关联起来来弥补这一空白。他们证明,达到高敏感性的参数设置是脆弱的,因为很小的参数扰动会在长输入上产生远更不敏感的函数,迫使高敏感性解进入非常尖锐的极小值。这为观察到的低敏感性偏置、训练困难以及 Transformer 中糟糕的长度泛化提供了理论解释。
方法
形式化 Transformer 模型与敏感性分析
作者利用一个简化但理论可处理的 Transformer 模型,来连接模型表达能力、LayerNorm 行为和损失格局几何。任务定义在布尔字符串 x∈{±1}n 上。每个符号通过词嵌入 e(−1),e(+1) 嵌入到 Rd 中,每个位置通过位置编码 p1,p2,…∈Rd 嵌入。位置 i 的初始表示因此是
yi(0):=e(xi)+pi,其中 xi∈{±1} 是第 i 个输入位。
模型具有固定深度 L。在第 k 层,每个位置 i 都有一个激活 yi(k)∈Rd。每层包含 H 个注意力头。对于第 k 层中的头 h,作者使用键矩阵 Kk,h 和查询矩阵 Qk,h 计算 softmax 前的注意力分数:
ai,j(k,h)=(Kk,hyj(k−1))⊤Qk,hyi(k−1).这些分数通过 softmax 操作归一化为注意力权重:
ai,j(k,h)=∑sexp(ai,s(k,h))exp(ai,j(k,h)).头 h 在位置 i 的输出是变换后激活的加权和:
bi,h(k)=j=1∑nai,j(k,h)Vk,hyj(k−1),其中 Vk,h 是值矩阵。头输出求和之后,经过带跳跃连接的前馈模块:
Yi(k):=fMLP(yi(k−1)+h=1∑Hbi,h(k)).作者随后应用 LayerNorm:
LayerNorm(y):=σ2(y)+εy−mean(y),其中 ε≥0 是一个小的稳定常数,σ2(y) 表示向量分量的方差。位置 i 在第 k 层的输出是
yi(k):=LayerNorm(Yi(k)).分析中的一个核心对象是 LayerNorm 归一化因子
Ni(k):=σ2(Yi(k))+ε1.该量衡量 LayerNorm 对归一化前激活进行重新缩放的强度。如果 Yi(k) 的方差较小,那么 Ni(k) 会变大,LayerNorm 可以大幅放大表示的有效幅度。作者用这一机制解释 Transformer 为什么只能通过进入参数空间中的某些区域来表示某些函数,而在这些区域中,小扰动会产生预测上的巨大变化。
最终预测通过取最后一层之后的最后一个位置激活,并用输出向量 νout 投影得到:
T(x):=νout⊤yn(L).分析随后引入敏感性,作为函数复杂性与训练行为之间的桥梁。对于布尔函数,敏感性衡量翻转单个输入位会改变输出的频率。如果 x⊕i 表示通过翻转 x 的第 i 个坐标得到的字符串,那么 x 处的输入敏感性可以写成
s(f,x)=i=1∑n1{f(x⊕i)=f(x)}.平均敏感性是
asn(f)=Ex∈{±1}ns(f,x).像 parity 这样的函数具有高平均敏感性,因为许多位翻转可以改变输出,而像 mean、majority 或 sparse lookup 这样的函数在均匀输入下可以具有小得多的平均敏感性。
理论方法首先界定 Transformer 预测的输入空间 Lipschitz 连续性。引入全局常数 C。它包含一个取决于键查询乘积谱范数的指数项,
exp(4dhmaxi=2∑L∥Ki,h⊤Qi,h∥2),以及一个关于宽度、深度、注意力头数量、模型矩阵谱范数和嵌入范数的多项式因子。经典风格的 Lipschitz 界形式为
s(f,x)≤eL/2Cexp(4dmaxh∥K1,h⊤Q1,h∥2),它显示了对输入层键查询矩阵的潜在指数依赖。作者随后强化这一依赖。通过对注意力权重使用集中性,他们表明,在相当大比例的输入上,大约是全部输入的 1−Hn−2,输入层指数项可以被对数因子替代,从而得到如下形式的界
s(f,x)≤CeL/2logn.这一步很重要,因为它区分了两个困难来源:由 C 刻画的大模型参数,以及大的 LayerNorm 放大。
为了分离第二个来源,作者定义 LayerNorm 爆炸项。在第 k 层和输入 x 处,
τ(k)(x):=w=1,…,nmax{1+Nw(k)(x)}.从输入到输出的总爆炸量是
Blowup(x):=k=1∏Lτ(k)(x).加 1 是技术性的,但当爆炸量很大时,该项由归一化因子 Nw(k) 主导。大的 LayerNorm 爆炸意味着表示被反复用非常大因子重新缩放,因此激活中的微小变化可能变成预测中的巨大变化。
该方法随后把这一爆炸量定位到敏感输入的 Hamming 邻域。作者确立,在关于 x 的选择下以高概率成立,
Cnlogns(f,x)≤Blowup(x)2+n1i=1∑nBlowup(x⊕i)2.对该关系在均匀分布输入上取平均,得到核心权衡:
C⋅E[Blowup(x)2]≥nlognasn(f)−nH.对于较大的 n,H/n 项变小。因此,如果 Transformer 要表示一个具有较大平均敏感性的函数,那么要么参数常数 C 必须很大,要么 LayerNorm 爆炸量必须很大。对于 asn(f)=n 的 parity,界预测
C⋅E[Blowup(x)2]=Ω(lognn),它随输入长度增长。这表明,为越来越长的输入表示 parity 需要要么增大参数,要么增大 LayerNorm 放大。
分析还解释了一些函数为什么更容易,尽管它们对输入长度有非平凡的依赖。对于像 first 这样的稀疏函数,平均敏感性是 O(1),因此下界不要求大的爆炸量。Transformer 可以通过用 logn 缩放注意力 logits 来表示这些函数,这不会强制产生同样尖锐的极小值。对于 mean,局部敏感性在大多数输入上很小,因此预测几乎没有爆炸量。对于 majority,平均敏感性是次线性的,但局部敏感性在平衡输入附近变得很高。该理论预测在这些敏感邻域处或附近需要爆炸量。
第二个主要方法论组件把这种输入空间敏感性转化为参数空间尖锐度。给定 Transformer 参数向量 θ,平均方向尖锐度定义为
Lρ,n(T):=Ex∈{±1}nE∥Δ∥2=ρ(Tθ+Δ(x)−Tθ(x))2.它衡量当参数在随机方向上被半径为 ρ 的小向量 Δ 扰动时,Transformer 输出的期望变化。Lρ,n 越大表示极小值越尖锐。作者在该定义中从 θ 中排除位置编码,因为它们通常是固定的,并且它们的数量随 n 增长,这会使跨输入长度的比较变得复杂。
关键尖锐度结果表明,当 Transformer 宽度 d 足够大于其深度 L 时,对于具有高平均敏感性的函数,小的参数扰动会导致大的输出变化。更精确地,
ρ→0limn→∞liminfLρ,n(T)≥n→∞liminf2nasn(Tθ)−Lexp(−Ω(d)).如果 Transformer 输出是布尔值,那么常数 2 可以移除。当模型相对于深度足够宽时,项 Lexp(−Ω(d)) 可忽略不计,这在实践中常见 Transformer 中是一个常见情形。
因此逻辑链是:敏感函数在输入空间中需要高敏感性;表示这些函数要么需要大的参数范数,要么需要大的 LayerNorm 爆炸量;大的 LayerNorm 爆炸量使输出极易受小的参数扰动影响;因此,拟合敏感函数的参数空间极小值是尖锐的。这种尖锐度有实际后果。随机初始化的 Transformer 往往占据低敏感性的参数区域,因为高敏感性需要参数空间中的一个集中区域。敏感函数的长度泛化也变得困难:即使某个极小值准确表示了一个能进行长度泛化的解,任意小的偏差也可能在足够长的输入上导致失败。
作者还将敏感性框架与布尔立方体上的 Fourier 分析联系起来。任何函数 f:{±1}n→R 都可以在 Fourier 基下写为
f(x)=P⊆{1,…,n}∑λPχP(x),其中
χP(x)=i∈P∏xi.平均敏感性可以用 Fourier 权重表示:
asn(f)=P⊆{1,…,n}∑λP2∣P∣=i=0∑nidi,其中 di 是次数为 i 的单项式上的平方权重。因此,低敏感性偏置等价于偏向远离那些 Fourier 质量位于高次交互作用上的函数。这给出了一个结构性解释,说明为什么经梯度训练的 Transformer 可能偏好简单、低次布尔函数,即使训练集没有明确揭示所有敏感扰动。
最后,该方法把 scratchpad 计算视为减少每个自回归步骤所需敏感性的一种方式。模型不是直接要求 Transformer 将整个自动机输入映射到最终状态,而是可以产生一系列中间状态。这将全局敏感的计算转化为一系列局部简单的计算。在这种情况下,每一步可以具有恒定敏感性,从而减轻施加在单步函数上的尖锐度压力。作者利用这一点来解释为什么中间计算可以让困难的布尔推理问题更容易训练,这不仅是因为它增加了表达能力,也是因为它降低了施加在每个计算步骤上的敏感性负担。
实验
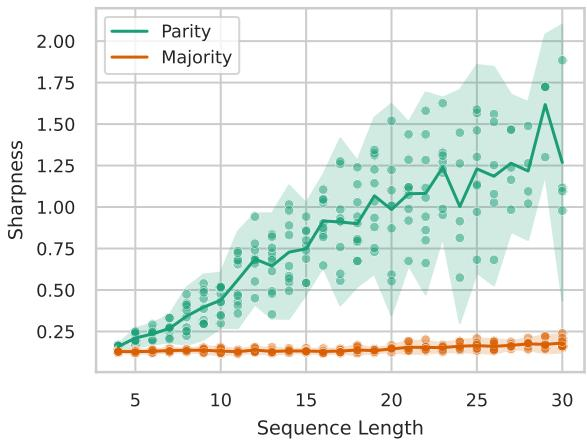
实验训练 PyTorch Transformer 编码器来计算序列函数,并测量尖锐度、参数范数和 LayerNorm 爆炸量。它们确认,较高的敏感性函数(例如 parity)产生更尖锐的极小值,并且这些极小值随序列长度增加;同时参数范数和对数 LayerNorm 爆炸量之间出现权衡。能够泛化的模型往往偏好具有更平坦极小值的低敏感性外推,parity 的 scratchpad 计算通过降低每步敏感性来避免尖锐度增长。训练动态还显示,当模型进入陡峭的 parity 极小值时尖锐度上升,这与 LayerNorm 爆炸量同时发生,并随后出现参数范数降低。