Command Palette
Search for a command to run...
Must NLP be Extractive?
Must NLP be Extractive?
Steven Bird
摘要
How do we roll out language technologies across a world with 7,000 languages? In one story, we scale the successes of NLP further into 'low-resource' languages, doing ever more with less. However, this approach does not recognise the fact that – beyond the 500 institutional languages – the remaining languages are oral vernaculars. These speech communities interact with the outside world using a 'contact language'. I argue that contact languages are the appropriate target for technologies like speech recognition and machine translation, and that the 6,500 oral vernaculars should be approached differently. I share stories from an Indigenous community where local people reshaped an extractive agenda to align with their relational agenda. I describe the emerging paradigm of Relational NLP and explain how it opens the way to non-extractive methods and to solutions that enhance human agency.
一句话总结
查尔斯·达尔文大学北方研究所的研究人员提出关系型 NLP,其以接触语言作为语音和翻译技术的目标,并通过非提取式、社区主导、以原住民主体性为中心的方法,来框定与 6,500 种口传方言的互动。
核心贡献
- 该论文认为,语音识别和机器翻译的主要目标应是接触语言,而不是约 6,500 种口传方言;口传方言需要不同的方法。
- 该论文将关系型 NLP 发展为第三波视角,把语言技术视为社会技术工具,用于增强人类主体性、厚翻译、方言机会以及非提取式的以社区为中心的方法。
- 该论文通过原住民社区叙事以及对三波 NLP 在七个维度上的综合来落实这一主张,展示如何把提取式议程重塑为关系型实践和以社区为中心的设计。
引言
该论文考察面向口传和少数化语言的自然语言处理,认为生成式 AI 和大语言模型常把语言当作标准化文本,而非情境化的人类实践。这很重要,因为大规模多语言系统承诺为说话者提供广泛接入,但世界上大多数语言是口传的,嵌入地方、亲属制度和共享历史中,无法通过抓取语料或翻译成书面规范来完全捕捉。作者认为,第一波符号主义 NLP 和第二波统计 NLP 通过假定有界限的标准化语言、跨文化语义重叠以及忽视主体性、语境和权力的提取式数据流程,限制了自然语言的理解。他们提出作为第三波的关系型 NLP,把语言技术重新定义为增强型、以社区为中心的工具,强化人类主体性而非取代它。
数据集
-
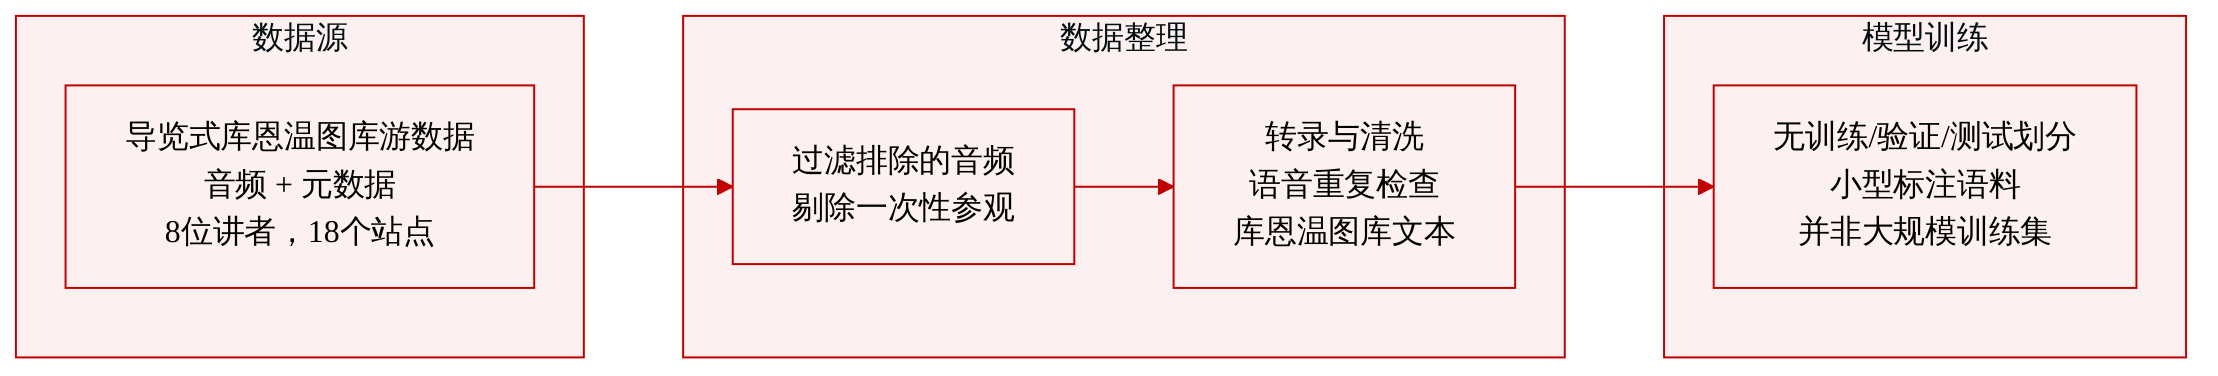
该语料库是一个小型实地数据集,是在阿纳姆地 Kabulwarnamyo 与当地 Kunwinjku 说话者一起的导览步行中创建的。作者利用这些数据展示基于地点、学习者主导的音频如何支持语言学习和记录。
-
早期收集了一段即兴录音,但因包含偶然参与者而被排除。可用数据来自更可控的导览协议。
-
主要音频子集:八名参与者在沿同一社区路径行进时录制。路径有 18 个固定地点,包括露天学校、学校菜园、教师住所、露兜树林、林地、泵房、泉眼、梦幻地、直升机坪、工坊、太阳能电池板、访客营地、护林员办公室、枪柜、社区礼堂、卫星天线、创始人墓地以及主要住地。
-
音频采集细节:录音以 16 bit、16 kHz 单声道音频制作,使用无线领夹麦克风和现场录音设备。
-
参与者元数据和录音架构:每次会话开始由说话者自我介绍,并说明其氏族和 Country。固定导览结构、停留点列表和说话者信息构成数据集的主要元数据框架。
-
引导和标注提示:作者带领导览,并在 18 个地点逐一停留。在含有植物物种的地点,作者用 Kunwinjku 语提示说话者命名植物,并描述已知用途、季节或相关知识。当某个词显得重要时,作者会重复该词,以鼓励说话者进一步说明。
-
并行语言活动:论文描述了一次额外的英语步行活动,作者担任向导,用平实英语进行说明,同时使用 Kunwinjku 语提示。这体现了该活动的双语性和基于地点的性质,尽管所记录语料以 Country 上说的 Kunwinjku 语为中心。
-
重说与转写处理:作者逐句播放自发录音,并用更清晰的近场语音重复,制作仔细重说录音。顾问纠正作者的重复内容,以恢复语音上弱化的语素、词根和词缀。这些重说文件仅用于内部分析和核验,不作为面向学习者的音频。之后使用 Kunwinjku 文字正字法对主语料进行转写。
-
训练使用:论文未报告训练、验证或测试划分,也未报告混合比例。这些数据作为小型标注实地语料呈现,而非大型机器训练集。
-
作者如何使用数据:他们将该语料作为证据,说明 Kunwinjku 语学习如何通过与 Country 的引导互动发生。他们还将其框定为增强型智能应用的原型:移动系统可以检测用户位置,追踪近期语音产出以估计熟练程度,并建议与周边环境相关的 Kunwinjku 语词或短语。
方法
所提方法以情境化、基于地点的录音流程组织。其核心模块是标准化导览。作者不要求孤立词汇或诱导句,而是采用一种既有的社区实践:带访客参观 Country。参与者在社区内沿固定环线带领研究者,在预设的 18 个地点停留,包括学校菜园、露兜树林、泉眼、梦幻地、直升机坪、工坊、护林员办公室和主要住地。相同路线会由多名本地向导重复,形成平行记录,之后可比较、按地点索引或按难度排序。参考下方路线图:
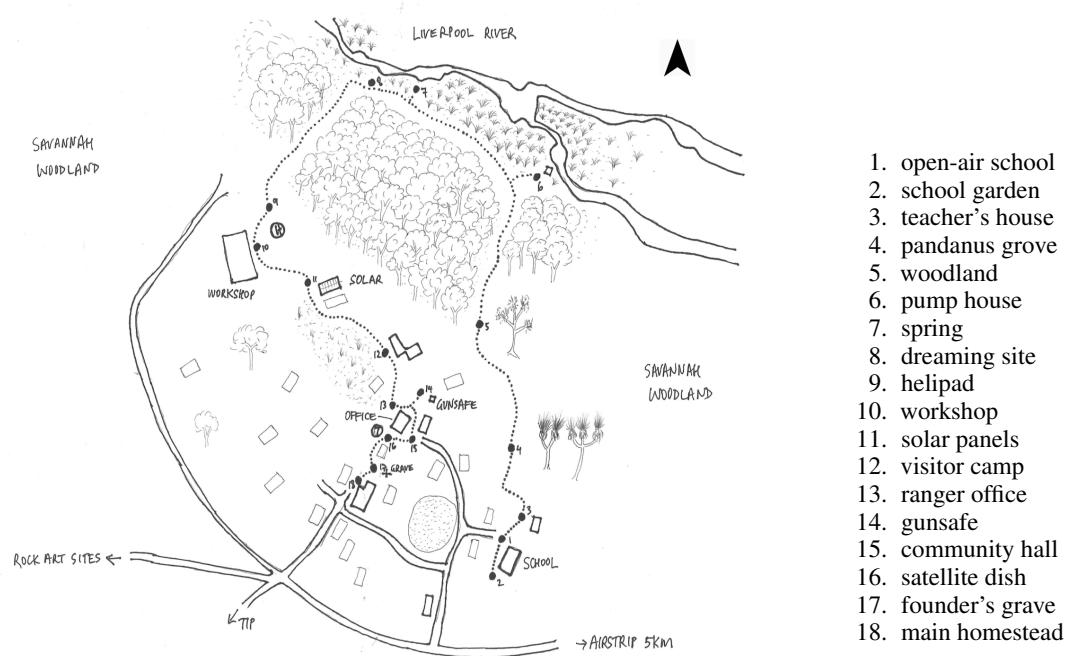
录音协议具有清晰的前端交互模块。每次导览开始时,参与者自我介绍并表明其氏族和 Country。步行期间,向导解释每个停留点可见内容,包括目的、历史、季节意义和植物用途。研究者通过指向物体或重复显著词语引出更多细节,但参与者仍是主要知识来源。该设计把以社交和安全为导向的导览转化为结构化记录任务,同时保持交互的自然性。音频使用专业现场录音设备采集,采用无线领夹麦克风和现场录音器,以 16 bit 和 16 kHz 单声道录制,这使数据保持可管理,同时为后续分析保留足够语音质量。
该流程包含一个采集后的语言规范化模块,称为仔细重说。在这一步中,自发短语被重播,然后在可控近场录音中重复,如同向未来转写者口述。目的是减少流利语音中语音弱化对效果的影响,并使形态结构更显眼。例如,一个弱化表层形式如 [gAwdiri] 可扩展为仔细形式 /gAbiri−jAw−diri/,揭示代词、指小形式和动词词根之间的关系。随后,流利说话者纠正发音、遗漏片段和语素边界。这将重说过程变成验证层,用于在书面转写前识别词根、词缀和可解释释读。
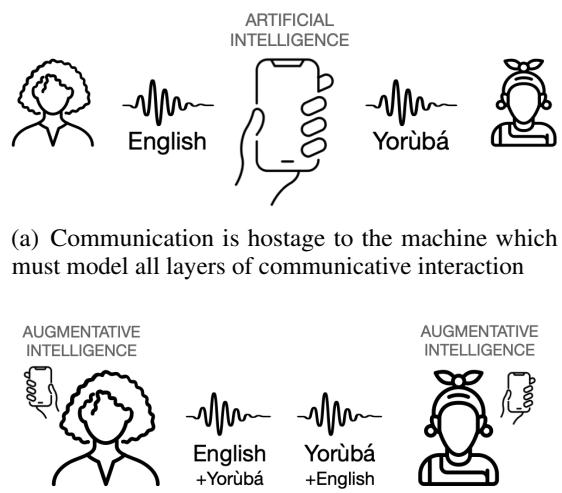
由此产生的语料库有意依赖地点。它并非被设计为独立完整的语言资源。其意义取决于物理地点、社会关系和当地专家的阐释工作。该设计支持后续增强应用层。在一个设想场景中,移动系统可以检测说话者当前位置,分析近期语音产出以估计熟练程度,并建议与所访地点相关的词或短语。系统不会自称能自行翻译或阐释文化内容。相反,它帮助学习者提出更好的问题,并在恰当时刻注意可能的词汇。如图所示:
因此,架构结合位置感知语境跟踪、语音产出分析和建议生成。其目标是增强人类沟通,而不是取代它。导览录音提供语境锚点,而本地说话者对于确认名称、历史和适当用法仍然不可或缺。
实验
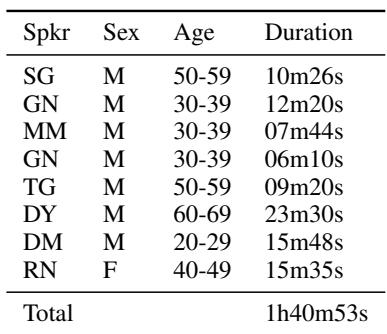
该表描述了七段由男性参与者完成的导览录音,年龄组从 20 多岁到 60 多岁。录音时长差异很大,一些活动不足十分钟,最长超过二十分钟。这种差异说明导览长度不同,而非固定录音时间。所有列出参与者均为男性。导览录音从不足十分钟到超过二十分钟不等。最长录音对应最年长年龄组。
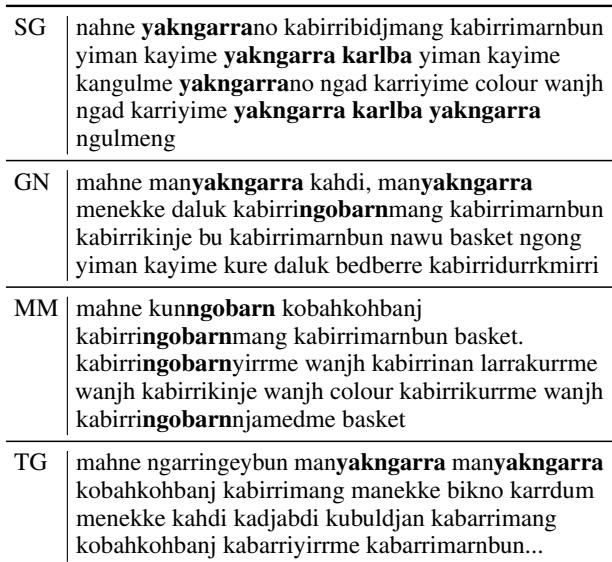
转写样本显示,在露兜树林不同记录中反复出现内容词。若干变体共享对象词和重复词形,而周围词语不同。这表明样本中存在稳定核心词汇与可变短语的组合。重复词形出现在多个转写变体中。篮子和颜色等对象词出现在若干样本中。各变体在措辞和顺序上不同,但保留可识别的内容词。
该框架对比符号、次符号和关系型语言处理方法,从形式代码和机器可读数据转向具身社会实践和人类主体性。它还显示价值和目标的转移,从语言描写和理论充分性,转向可扩展机器学习系统,再转向文化存续和社区控制。每一波对语言的定义不同:形式代码、序列数据,以及最终的具身社会实践。符号方法强调精确性、覆盖面和形式语法;第二波方法强调可扩展数据和高效技术方案。关系型方法以本地所有权、文化存续为核心,并采用与长者和 Country 的故事工作等方法。
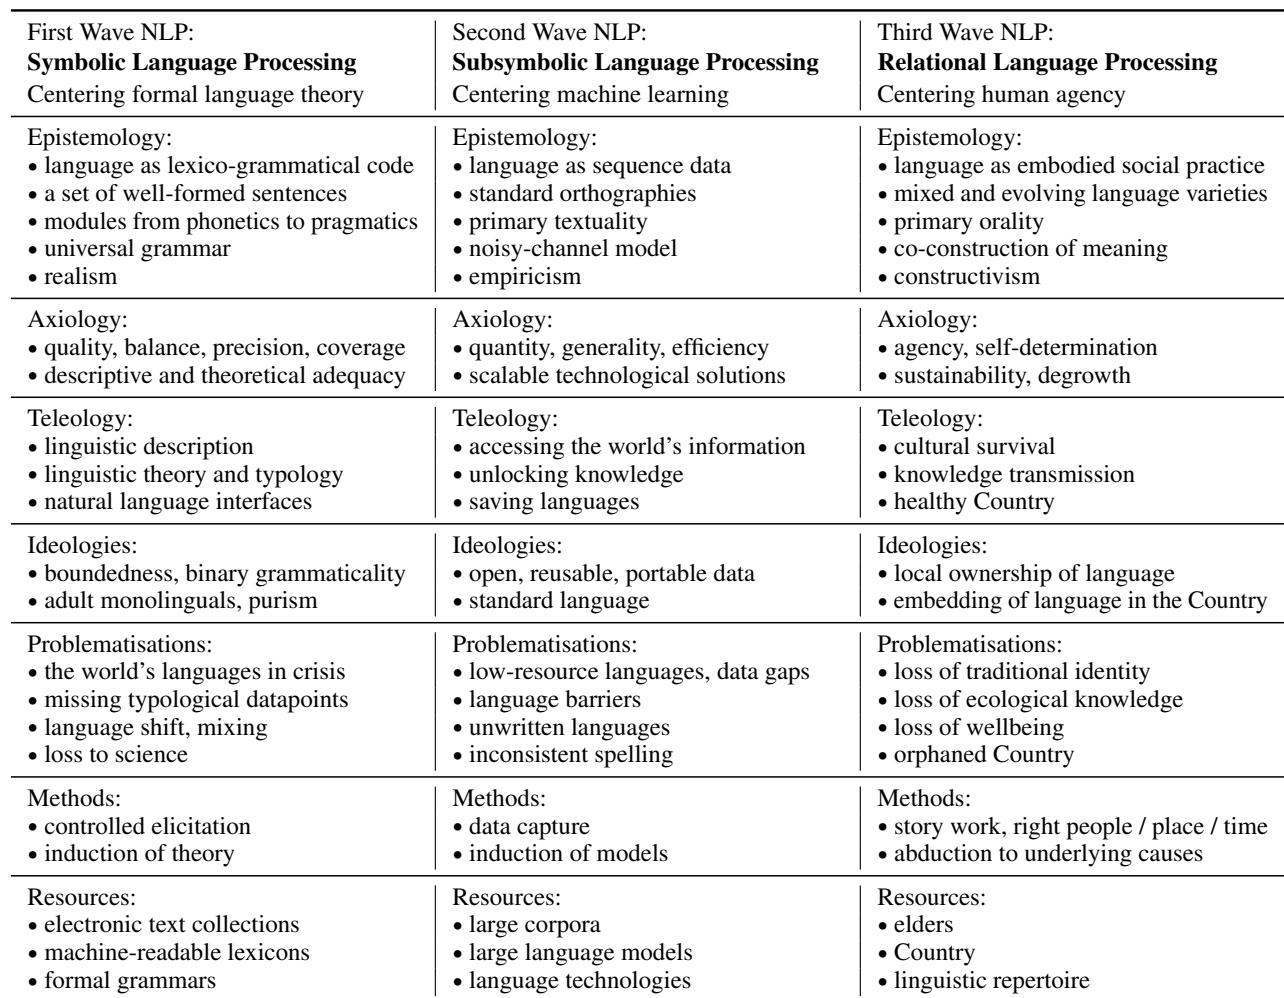
评估检查了七段长度不等的男性导览录音,表明录音时长反映导览长度,而非固定协议;最长活动与较年长年龄组相关。来自露兜树林的转写样本揭示在措辞和顺序不同中反复出现的对象词和内容词,支持可变短语中存在稳定核心词汇。比较框架追溯三种语言处理方法,显示从形式化和可扩展计算目标转向以文化为根基、社区控制的实践。