Command Palette
Search for a command to run...
基于语音基础模型与大语言模型的语音翻译:现状与不足
基于语音基础模型与大语言模型的语音翻译:现状与不足
Marco Gaido Sara Papi Matteo Negri Luisa Bentivogli
摘要
自然语言处理(NLP)领域近期经历了变革性的转变,随着基础模型的出现,尤其是大语言模型(LLM)彻底革新了文本型 NLP。这一范式已扩展至其他模态,包括语音,研究者们正积极探索将语音基础模型(SFM)与 LLM 组合为单一统一模型以应对多模态任务。在此类任务中,本文聚焦于语音到文本翻译(ST)。通过梳理已发表的相关论文,我们提出了一个统一视角来审视迄今所提出的架构方案与训练策略,并揭示其中的异同。基于这一梳理,我们不仅总结了已有经验,还指出了多样化的实验设置与评估方法如何阻碍了对各架构组件和训练选择的最佳方案进行辨识。最后,我们针对未来工作提出建议,旨在更深入地理解 SFM+LLM 方案在 ST 任务中的优势与不足。
一句话总结
Fondazione Bruno Kessler 综述了语音基础模型 (SFM) 与大语言模型 (LLM) 在语音到文本翻译中的集成,提出了架构与训练策略的统一分类体系,指出不一致的评测设置会掩盖最优设计选择,并阐述了改进 SFM+LLM 系统的未来研究方向。
核心贡献
-
该综述提出了一种统一的架构抽象,用于组织结合语音基础模型与大语言模型的语音到文本翻译模型,并将其归纳为五个构建模块:语音表征提取、长度适配、模态适配、prompt 与语音合并、翻译生成。
-
该综述比较了已发表的架构与训练选择,表明不一致的设置、训练配方和评测协议会阻碍确定每个构建模块和训练选择的最佳表现方案。
-
该综述提出了未来工作的建议,包括:与端到端和级联式语音到文本方法进行标准化比较;针对 1 亿到 3 亿参数模型,通过任务感知剪枝、动态层选择和高效解码进行效率评估;以及研究 in-context learning 向语音翻译的迁移。
引言
基础模型重塑了自然语言处理,语音基础模型如今能够实现丰富的语音理解,从而推动了将语音基础模型与大语言模型相结合的多模态语音到文本翻译系统。然而,现有的 SFM+LLM 工作快速发展,且架构、训练配方、数据集、语言和评测方式不一致,使公平比较和可复现性变得困难。缺少标准公开基准、可靠的语义指标,以及与传统级联式或端到端 ST 系统的比较,进一步掩盖了优势、劣势、效率以及 LLM 上下文学习能力的迁移。作者利用对公开可用 SFM+LLM ST 解决方案的系统性综述,识别出共同的五模块架构,整理架构与训练选择,并提出面向标准化训练、评测和未来分析的最佳实践。
数据集
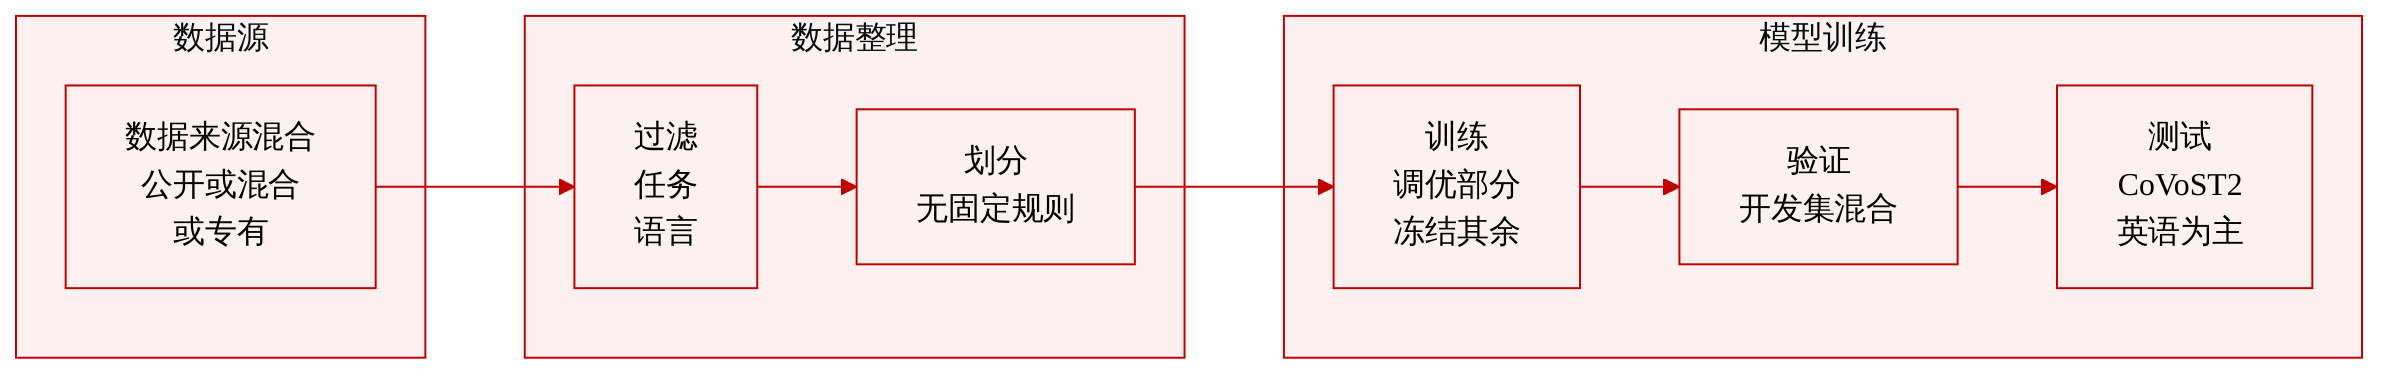
-
该论文描述了 9 篇语音基础模型与 LLM 论文中的数据集使用情况,而非呈现一个统一语料库。作者按公开、混合和专有来源整理数据,并使用 ISO 639 表示法报告语言代码。
-
训练数据差异很大。九篇论文中有五篇仅使用公开数据。LST、COSMIC 和 Conformer-LLaMA 依赖一个或两个数据集。SALM 使用 IWSLT 2023 离线语音翻译共享任务中的全部 11 个语音语料库。SALMONN 使用 12 个数据集。SLM 和 LLM-ST 结合内部数据与开放数据,而 Speech-LLaMa 和 Qwen-Audio 使用专有数据。
-
该论文未提供统一的训练协议。未报告统一的划分、混合比例、扩展实验或数据集级过滤规则,因此被综述模型之间的数据集构建无法直接比较。
-
若干模型的训练样本超越了 ASR 和 ST。SLM 包含指令微调数据。LLM-ST 包含四个翻译相关任务和两个语音相关任务。SALMONN 按阶段任务组训练,先使用 ASR 和 AAC,然后进行包含 12 个任务的指令微调,再进行包含 AQA 和 ABST 等较长响应任务的激活微调。Qwen-Audio 纳入 26 个额外的语音、音频和音乐任务。COSMIC 在训练期间使用 ASR 和 SQA 数据,同时也对 ST 进行测试,而 Conformer-LLaMA 仅使用 ASR 数据。
-
评测数据集也不一致。CoVoST2 是最常用的基准,在 5 篇论文中使用,覆盖 15 个英语到多语种方向和 21 个多语种到英语方向。MuST-C 用于 3 个英语到多语种评测。COSMIC 增加了 TEDLIUM 和 FLEURS。LLM-ST 增加了 GigaST 和私有内部测试集。四篇论文评测英语到多语种方向,两篇评测多语种到英语方向,两篇评测两个方向,一篇未报告评测结果。
-
支持语言以英语为中心。在多语种到英语设置中,Qwen-Audio 覆盖 5 种源语言,Speech-LLaMa 覆盖 21 个 CoVoST2 语言对中的 13 个,SLM 覆盖全部 21 个 CoVoST2 语言对。在英语到多语种设置中,被综述论文仅覆盖 2 到 4 种目标语言,且 LLM-ST 仅覆盖 en-zh。多数报告结果聚焦于 de-en 或 en-de,其次常见的设置是 en-zh。
-
该论文未详述裁剪策略、元数据构建、准确的 token 数量或时长计数,以及其他低层次预处理步骤。
方法
作者将 SFM+LLM 语音翻译系统围绕共同的模块化流程进行组织。即使各论文在模型选择或训练策略上不同,整体架构仍可分解为五个功能组件:语音基础模型、长度适配器、模态适配器、prompt-speech 混合器和大语言模型。请参考框架图。
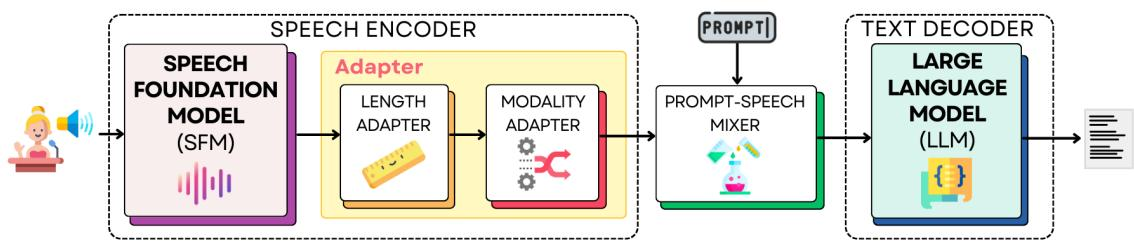
第一个组件是 SFM,它充当音频前端。它将输入语音信号编码为一系列语义嵌入,这些嵌入之后可与 LLM 的文本嵌入空间对齐。在实践中,SFM 通常基于 Transformer 或 Conformer 编码器,并且在训练数据、语言覆盖、支持任务和公开可用性方面可能存在很大差异。一些系统依赖面向 ASR 的编码器,而另一些系统则使用为更广泛语音任务训练的多语言模型。由于 SFM 提供了音频与文本之间的主要语义桥梁,其表征质量直接影响下游语音翻译性能。
第二个组件是长度适配器,用于缩小语音嵌入序列的时间维度。这一步很重要,因为音频序列通常长于对应的文本序列,而基于 Transformer 的 LLM 的自注意力开销随输入长度二次增长。因此,减少音频 tokens 数量有助于限制计算成本和内存需求,同时减少语音与文本之间的模态不匹配。作者讨论了该模块的几种设计。一类设计使用与 CTC 相关的压缩:一种变体对与同一 CTC 预测相关的嵌入求平均,另一种变体移除与 blank tokens 对齐的嵌入。另一类设计使用 Q-Former 风格的适配器。在窗口级变体中,语音序列被划分为大小为 ns 的块,并使用 nq 个学习的查询向量处理每个块,将序列长度缩小 ns/nq 倍。作者指出,长度压缩不仅影响翻译质量,也影响效率,并且不同适配器之间的系统比较仍然有限。
第三个组件是模态适配器。这是一个较小的可训练网络,将适配后的语音表征映射到与 LLM 兼容的嵌入空间。它可以实现为简单的前馈网络、Transformer 层堆叠,或者与长度适配器融合。在某些情况下,完全省略模态适配器。其必要性强烈依赖训练策略。如果 LLM 被微调,模型可能学会直接使用新的嵌入空间,从而减少对独立映射模块的需求。如果 LLM 和 SFM 被冻结,模态适配器变得更加重要,因为它负责对齐两个表征空间。作者强调,该适配器的规模和有效性尚未得到系统分析。
第四个组件是 prompt-speech 混合器。其作用是在将组合序列输入 LLM 之前,将适配后的语音表征与文本指令 prompt 相结合。许多系统使用固定的指令模板,例如一段要求模型从源语言翻译到目标语言的语句。混合可通过在 prompt embeddings 前添加 speech tokens、在 prompt embeddings 后追加它们,或在 prompt 前缀与后缀之间交织 speech tokens 来实现。一些系统也完全省略 prompt,只向 LLM 提供语音表征。作者指出,这些策略的相对收益尚不明确。
最后一个组件是 LLM,它接收混合后的 prompt 与语音序列,并生成文本翻译。该模块负责核心语言理解与生成行为。不同系统使用不同的开源语言模型,通常来自 LLaMa 系列或为指令遵循和对话式生成训练的变体。作者指出,更强的预训练语言模型可以提升语音翻译质量,但该领域缺乏跨 LLM 选择的受控比较,尤其是在周围语音前端和适配器设计保持固定的情况下。
实验
实验分析综述了 SFM 和 LLM 语音翻译系统的训练与评测设置,涵盖数据集、训练任务、微调选择、测试基准和语言对。分析发现,调整 LLM,尤其是通过低秩适配,往往能够改善结果,但这一收益与领域适配混杂,且缺少扩展性研究。将任务扩展到 ASR 和 ST 之外可以增强泛化能力和涌现能力,但对翻译质量的影响在不同语言方向上有所不同。总体而言,异构数据、任务设计、基准和以英语为中心的语言覆盖使跨模型公平比较变得困难。
被综述的 SFM+LLM 系统围绕语音基础模型、适配器、prompt-speech 混合器和 LLM 共享共同结构,但在组件选择和训练配置上差异很大。结果表明,调整 LLM 会带来显著的语音翻译收益,但剩余性能差异的来源仍不清楚。基准和语言覆盖不一致,尽管 CoVoST2 被广泛使用,且方法总体上以英语为中心。不同系统选择多样的 SFM 和长度适配器,在同一框架下缺乏共享实践或受控比较。LLM 适配似乎对语音翻译质量很重要,但它与其他模块设计和训练选择的交互仍不确定。评测在不同测试集和方向上比较分散,其中 CoVoST2 提供了相对常见的基准。支持的翻译设置大多以英语为中心,多语种到英语的覆盖范围往往比英语到多语种更广。
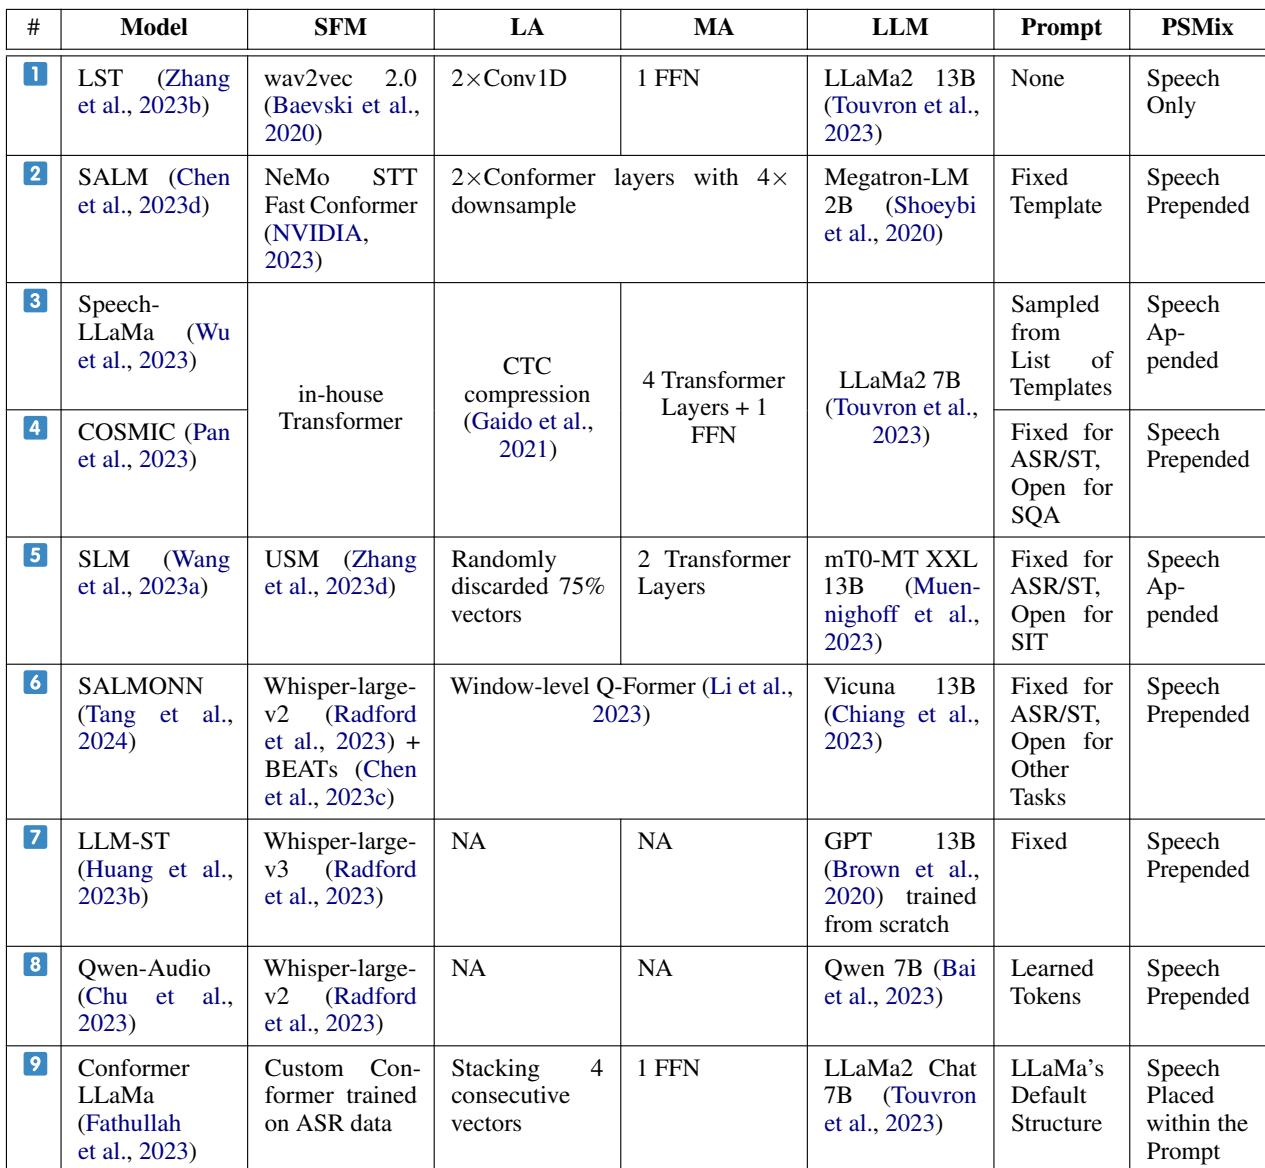
SFM 与 LLM 系统的实验设置在公开与专有训练数据、训练任务广度以及模型适配程度方面差异很大。通常会对 LLM 进行微调,常使用 LoRA,而 SFM 适配不那么一致,研究也更少。评测仍围绕 CoVoST2 和以英语为中心的翻译对分散展开,限制了直接比较。训练数据选择从公开语料到内部或专有数据不等,各系统之间没有共享配方。若干模型的训练范围扩展到 ASR 和语音翻译之外,包括指令微调和多种语音或音频任务。评测集中在 CoVoST2,而语言覆盖以英语为中心,分为英语到多语种和多语种到英语方向。
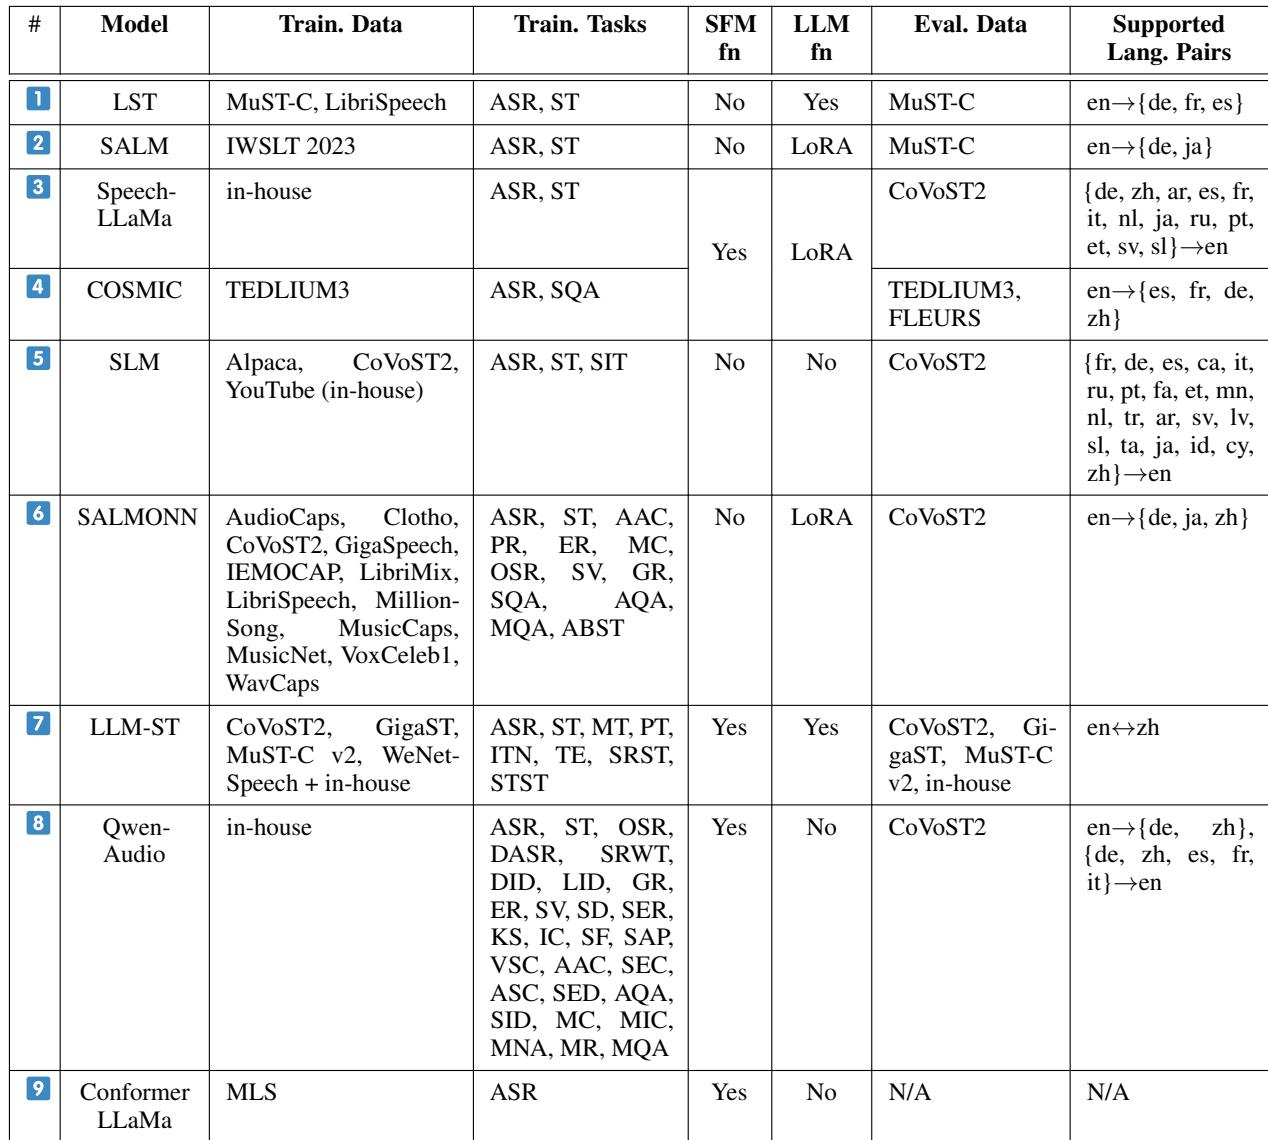
被比较的 SFM+LLM 系统在语音翻译任务上接受评测,这些系统具有不同的架构、训练数据来源、任务范围和适配方法。实验表明,LLM 适配通常通过 LoRA 实现,能带来翻译质量的显著提升,而由于设置很少受到控制,其他组件选择的影响仍不确定。评测围绕 CoVoST2 和主要为英语中心的翻译对分散展开,限制了直接比较,并凸显了基准和语言覆盖的不一致。