Command Palette
Search for a command to run...
不可能任务:语言模型
不可能任务:语言模型
Julie Kallini Isabel Papadimitriou Richard Futrell Kyle Mahowald Christopher Potts
摘要
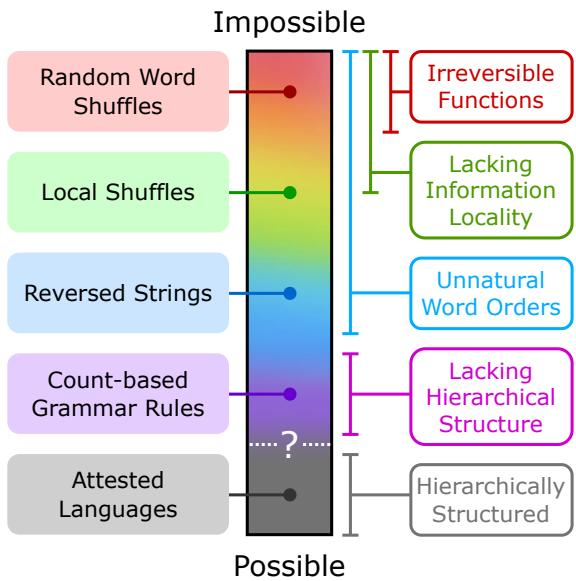
乔姆斯基等人曾非常直接地声称,大语言模型(LLM)同样具备学习人类可能习得和不可能习得的语言的能力。然而,支持这一论断的已发表实验证据极少。本文设计了一套具有不同复杂度的合成不可能语言,每种语言均通过系统性地对英语数据施加不自然的词序和语法规则生成。这些语言分布在一个不可能性连续体上:一端是本质上不可能的语言,例如英语单词的随机乱序和不可逆乱序;另一端则是那些未必直觉上不可能、但在语言学中常被认为不可能的语言,特别是那些基于词位置计数的规则。我们报告了广泛的评估实验,以考察 GPT-2 small 模型学习这些无争议的不可能语言的能力,并且关键在于,我们在训练的各个阶段进行评估,以比较每种语言的学习过程。我们的核心发现是:与作为对照组的英语相比,GPT-2 难以学习不可能语言,这对核心论断提出了质疑。更重要的是,我们期望本方法能开启一条富有成效的研究路径——让不同的 LLM 架构在多种不可能语言上接受测试,从而深入了解如何将 LLM 作为认知与类型学研究的工具。
一句话总结
来自斯坦福大学、加州大学欧文分校和德克萨斯大学奥斯汀分校的研究人员创建了合成的不可能语言,这些语言系统地改变词序和语法规则,以测试 GPT-2 是否像学习英语一样轻松地学习它们。结果发现 GPT-2 在这些语言上表现困难,从而挑战了 LLM 能同等学习人类可能语言与不可能语言的说法,同时将该框架作为一种用于认知语言学和类型学语言研究的工具提出。
核心贡献
- 通过用不自然的词序和语法规则转换英语数据,构建了一组受控的合成不可能语言,范围从随机或不可逆的词打乱到位置计数规则系统。
- 一个实验框架在自然英语对照下评估 GPT-2 small 模型在这些合成语言上的表现,并比较训练过程中多个检查点的性能。
- 结果表明,GPT-2 学习不可能语言的效果不如英语,这挑战了 LLM 能同等学习可能语言与不可能语言的说法,并支持将 LLM 作为研究语言可学习性的工具。
引言
大语言模型越来越多地被用作语言理论的实验工具,但一些研究人员认为,它们无法区分人类可能语言与不可能语言。如果这一观点成立,那么关于 LLM 可以为人类语言学习模型提供依据的说法就会被削弱。
主要挑战在于语言学家对可能语言与不可能语言缺乏精确定义,并且支持这一强声明的证据有限,尤其是在现代 LLM 上。
作者通过创建一套具有不同直观复杂度的合成不可能语言,并在 BabyLM 数据上训练的 GPT-2 模型上进行测试来应对这一问题。他们发现,模型更高效地学习自然语言,对不自然的计数型语法模式反应更强,并且使用的模块化内部表征无法完全捕捉这些不可能规则。这一证据挑战了 LLM 同等擅长学习可能语言和不可能语言的说法,同时也表明模型架构和 tokenization 选择会塑造其语言偏好。
数据集
-
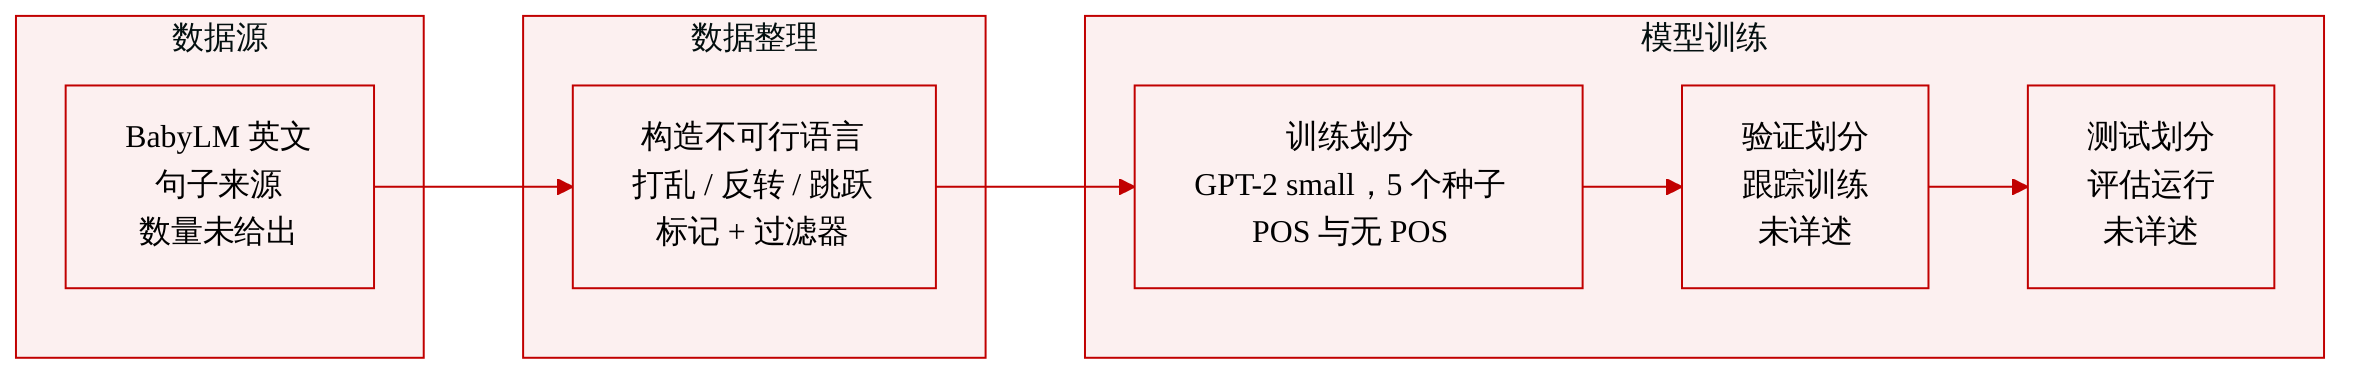
作者使用 BabyLM 英语句子作为源数据,并通过将确定性或随机扰动函数应用于每个句子来合成不可能语言数据集。
-
数据集分为三个语族:SHUFFLE、REVERSE 和 HOP。每个语族包括一种接近正常英语的对照语言,以及若干在局部性、可逆性和语法规则计数方面各不相同的扰动语言。
-
SHUFFLE 语言对 token 化后的句子进行操作:
- NOSHUFFLE 保持原始 token 顺序,并作为英语对照。
- NONDETERMINISTICSHUFFLE 为每个句子独立地随机打乱 token,破坏顺序信息。
- DETERMINISTICS HUFFLE 使用基于 token 序列长度和所选随机种子的固定打乱模式。
- LOCALSHUFFLE 只在固定长度的局部窗口内打乱 token。
- EVENODDSHUFFLE 将所有偶数索引的 token 放在所有奇数索引的 token 之前。
-
REVERSE 语言插入特殊标记 token,并反转句子全部或部分:
- NOREVERSE 在整个数据集的固定位置插入标记,并保持 token 顺序不变。
- PARTIAL REVERSE 插入标记,并反转标记之后的 token。
- FULL REVERSE 插入标记,并反转整个 token 序列。
- 各语言中的标记位置受到控制,以隔离反转本身的影响,而不是标记随机性的影响。
-
HOP 语言修改动词一致信息,以测试基于计数的语法规则:
- NOHOP 对第三人称现在时动词进行 lemma 化,并在动词之后立即放置单数或复数标记。
- TOKENHOP 在动词之后四个 token 处放置相同标记。
- WORDHOP 在动词之后四个词处放置标记,跳过标点。
- 这些标记使用特殊 token 来编码数和时态信息。
-
文中未给出 BabyLM 数据集的确切句子数或 token 数。
-
作者将每个扰动函数应用于每个 BabyLM 句子,从而为相应不可能语言创建转换后的数据集。
-
数据结构主要是由英语输入生成的 token 序列,并在 REVERSE 和 HOP 语言中使用额外的特殊标记 token。
-
为落实每种语言定义,会使用特定于语言的过滤和预处理,但所提供摘录未详述具体过滤规则。
-
作者使用所得数据集在因果语言建模任务上训练 GPT-2 small 模型,并为每种语言使用不同随机种子产生五次模型运行。
-
主要实验使用带有绝对位置编码的 GPT-2 small 模型,作者还训练去除了位置编码的模型,以比较仅从语言建模目标中学习词序的效果。
方法
该方法将 *HOP 语言作为对英语文本的受控扰动引入,以测试 GPT-2 能否学习依赖于位置计数的语法规则。转换流程聚焦于第三人称现在时动词,将其表面屈折形式替换为 lemma 化的动词和一个编码数的显式语法标记。随后,模型根据能否准确预测或处理这种受控表征来接受评估。
对于每个输入句子,流程首先识别所有第三人称现在时动词。每个被识别的动词都会进行 lemma 化,并插入一个特殊标记来表示动词的数。单数动词接收一个特殊 token,例如 S,复数动词接收另一个特殊 token,例如 P。这种设计移除了正常英语的屈折线索,并以人工标记替代这些线索,而人工标记的位置取决于所选的 *HOP 规则。
三个变体只在标记相对于动词的放置位置上不同。
-
NoHOP 在 token 空间中于 lemma 化动词之后立即放置标记。如果动词占据 token 位置 t,标记就插入位置 t+1。该版本最接近英语词序,因为数线索仍然紧邻动词。
-
TOKENHOP 应用与 NoHOP 相同的动词 lemma 化和标记分配,但标记位于动词之后四个 token 处。在这种情况下,即使动词和标记之间可能存在中间的词、空格、标点或子词片段,标记仍与动词相关联。这迫使模型依赖 token 距离计数,而不是局部相邻关系。
-
WORDHOP 也使用相同的动词和标记转换,但在动词之后四个词处放置标记,同时跳过标点。这里的计数单位是语言词,而不是模型 token。测量距离时忽略标点,因此标记的位置取决于词级计数,而该计数可能与 tokenizer 的 token 边界不一致。
以紧凑公式表示,对于动词 v 及其数标记 mv∈{S,P},NoHOP 将 mv 插入 pos(v)+1,TOKENHOP 将 mv 插入 postoken(v)+4,WORDHOP 则在 v 之后四个中间词之后的位置插入 mv,且标点不计入计数。
该模块的目的是创建一类语法,其中句法一致关系通过可变偏移进行编码。NoHOP 测试紧邻动词的标记能否作为常规局部依存被学习。TOKENHOP 测试 GPT-2 能否学习固定 token 计数规则,其中动词与标记之间的距离在 tokenizer 的空间中定义。WORDHOP 测试模型能否学习比 token 更粗粒度且忽略标点的词计数规则。总体而言,这些语言用于探究 transformer 语言模型能否表示那些要求跨越分隔元素对位置进行计数的语法规则。
实验
GPT-2 模型在 BabyLM 的合成不可能语言变体上进行训练,并通过困惑度、基于 surprisal 的动词标记测试和因果干预来评估,以考察它们相对于自然对照语言学习非自然语法的能力。所有实验中,模型学习可能语言模式都比对不可能模式更容易、更可靠;自然的动词标记规则以及更局部或更确定性的扰动产生了更清晰的学习信号。对模型内部机制的探测表明,即使面对非自然计数规则,模型也能形成功能性一致表征,但相对自然语法,这种表征更不稳健、形成更慢,说明模型偏好信息局部、自然语言结构。
示例将英语式对照输出与重排或打乱 token 的合成变体进行对比,展示从熟悉模式到更复杂人工序列的不可能性连续谱。在 GPT-2 实验中,在这些语言上训练的模型在困惑度上出现差异,其中非确定性打乱产生最高困惑度,确定性打乱则产生更可学习的模式。英语式对照语言保留了可识别的词序和 token 模式。确定性打乱语言比非确定性打乱语言更可学习,因为它们的 token 重排遵循一致的规则。
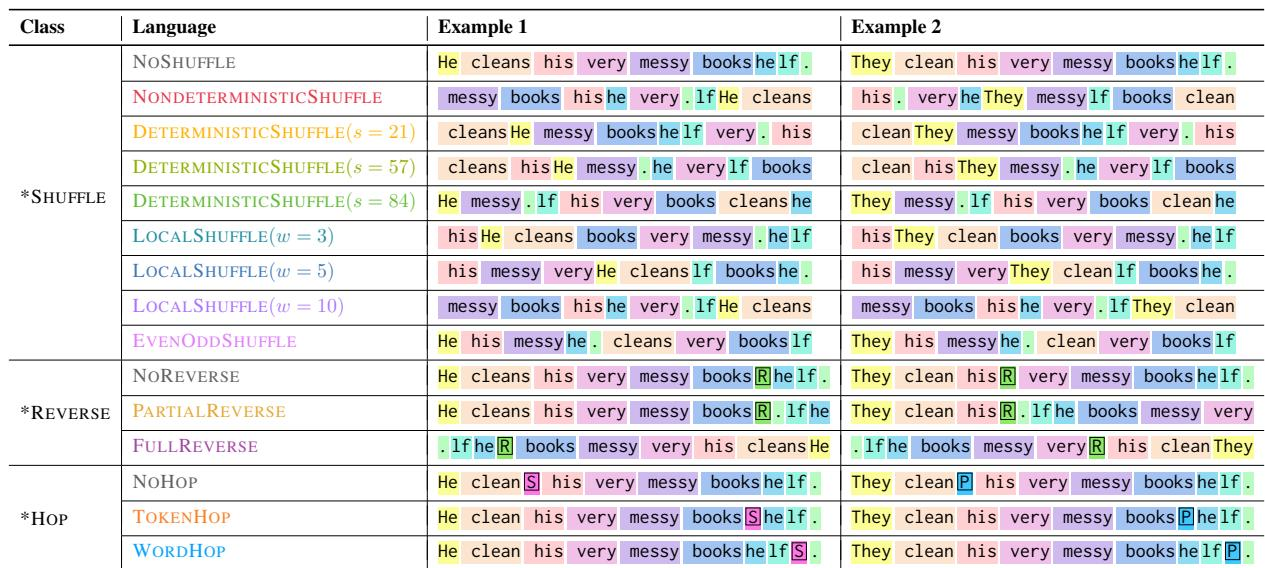
实验评估在英语式语言和施加受控 token 重排的合成变体上训练的 GPT-2 模型,这些变体从可识别模式到打乱序列不等。结果表明,熟悉的英语式词序最易学习,当规则稳定时确定性打乱仍然可学习,而非确定性打乱最难学习,因为它的模式不一致。这支持了句法一致性和可预测 token 关系会塑造模型难度的观点。