Command Palette
Search for a command to run...
拒绝幻觉,选择弃答:通过多LLM协作识别LLM知识缺口
拒绝幻觉,选择弃答:通过多LLM协作识别LLM知识缺口
Shangbin Feng Weijia Shi Yike Wang Wenxuan Ding Vidhisha Balachandran Yulia Tsvetkov
摘要
尽管研究者不断尝试扩展大语言模型(LLM)的知识,但由于知识本身的不断演化,LLM 中缺失或过时的信息——即知识缺口——可能始终存在。本文研究如何识别 LLM 的知识缺口,并在存在知识缺口时选择弃答。我们首先将现有方法适配到模型校准以及通过微调/提示进行模型适应,并分析其在拒绝生成低置信度输出方面的能力。受这些方法在自我反思方面的失败和对留出集的过度依赖所启发,我们提出了两种基于模型协作的新方法,即让 LLM 之间以协作或竞争的方式相互探测知识缺口。在涵盖多种知识领域的四个问答任务上,对三个 LLM 进行了大量实验,结果表明,协作式和竞争式方法在弃答准确率上相较最强基线方法最高可提升 19.3%。进一步分析表明,我们的弃答方法能够精确定位检索增强中的失败案例以及多跳推理中的知识缺口。
一句话总结
来自 University of Washington、UC Berkeley、HKUST 和 CMU 的研究者提出协作式与竞争式多 LLM 协作方法,其中多个 LLM 相互探询以识别知识缺口,并对低置信答案进行弃答,在四个问答任务上相较最强基线将弃答准确率提升至多 19.3%。
核心贡献
-
构建了一个包含 11 种弃答基线方法的分类体系,覆盖校准、训练、提示和自一致性方法,并将其改造为 AbstainQA 机制,用于识别 LLM 知识缺口并防止错误答案。该评估考察了现有不确定性与自我反思方法的边界。
-
提出 COOPERATE 和 COMPETE 两种基于协作的弃答方法,其中一个 LLM 以协作或竞争方式向另一个 LLM 探询缺失或不确定的知识。这些方法通过多 LLM 交互促进机制化反思,旨在实现直接问答、检索增强问答和多跳推理中的鲁棒弃答。
-
在四个问答任务上对三种 LLM 开展实验,结果表明 COOPERATE 和 COMPETE 相较最强基线可将弃答准确率提升至多 19.3%,推进了 AbstainQA 的最新性能。进一步分析表明,这些方法能够定位检索增强问答中的失败案例以及多跳推理中的知识缺口。
引言
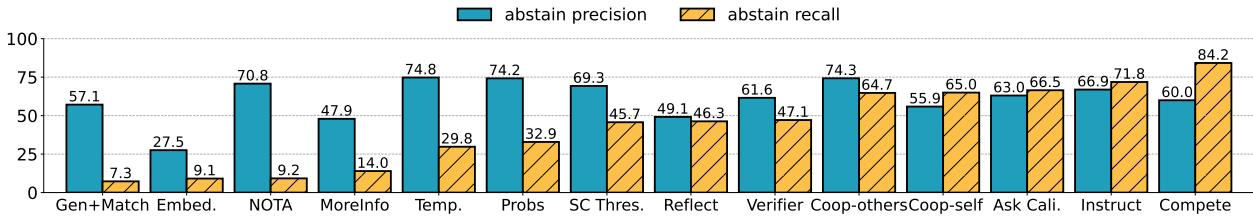
大语言模型编码了大量真实世界知识,但训练数据中的缺口或不可靠的内部知识可能导致自信幻觉和偏差回答。因此在问答中,判断模型何时应弃答而非生成错误回复至关重要。现有弃答方法,例如校准、训练、提示和自一致性方法,通常需要留出数据,或依赖单个模型对自身输出进行评估,这可能限制泛化能力和稳定性。作者构建了包含 11 种现有弃答基线方法的分类体系,并提出 COOPERATE 和 COMPETE 两种多 LLM 协作方法,通过协作式或竞争式反思更鲁棒地检测知识缺口。
方法
作者将 LLM 弃答形式化为对生成答案的可靠性估计问题。给定问题 q 和模型答案 a=LLM(q),目标是决定接受 a,还是拒绝它并弃答。利用留出集 (q,aˉ)∈H 来调整阈值或分类参数,使弃答策略尽可能减少错误的接受与拒绝决策。
一类方法依赖校准。在基于 token 概率的弃答中,LLM 从 token 概率生成置信分数 p(a)。阈值 p∗ 在留出集上通过最小化弃答误差进行选择:
p∗=argp′mina=aˉ∑1(p(a)<p′)+a=aˉ∑1(p(a)≥p′).推理时,当 p(a)<p∗ 时,模型弃答。温度缩放通过标量温度 τ 重塑答案分布,并在留出集上使用交叉熵优化 τ,从而改进校准过程。获得校准温度 τ∗ 后,对温度缩放后的输出应用概率阈值。作者还考虑了语言化置信度,即 LLM 首先生成答案,随后被提示报告答案正确的概率。该语言化分数同样通过阈值进行判断。
基于训练的弃答方法从模型状态或生成答案中学习决策边界。对于隐藏层探针,作者提取问题编码 eq=LLM-hidden(q),并训练线性探针或前馈模块来预测接受或拒绝:
p(ℓ∣q)∝exp(FFN(eq)).探针在留出集上使用交叉熵进行优化,当预测标签表示拒绝时,LLM 弃答。一种外部验证器变体训练一个独立的编码器模型,根据输入对 (q,LLM(q)) 判断生成答案的真实性,通常使用 [CLS] 表示进行分类。基于指令微调的弃答则从留出集构造监督样本。如果生成答案正确,输入对 (q,a) 成为微调样本;如果不正确,则目标被替换为明确的弃答消息。推理时,生成弃答消息即作为弃答信号。
基于提示的方法在不修改模型权重的前提下引导自我评估。可以要求 LLM 判断自身答案为真或假、指出是否需要额外信息,或先生成自由形式答案,再检查该答案是否与某个多项选择选项匹配。在这些变体中,当答案被判为假、需要更多信息,或没有选项与自由生成答案匹配时,模型被指示弃答。基于一致性的方法通过检查模型是否反复生成相同答案来增加额外信号。对于多条推理路径 {(ai,pi)}i=1k,作者定义一个多数指数:
plu(LLM,q,k)=aimaxj=1∑k1(aj=ai).该指数衡量出现频率最高的答案在 k 条生成路径中出现的频率。在留出集上调整阈值 τ∗,当 plu(LLM,q,k)<τ∗⋅k 时,模型弃答。
为了降低对不稳定自我评估和有限留出数据的依赖,作者进一步提出多 LLM 协作框架。框架不再要求单个 LLM 评估自身输出,而是让多个 LLM 交互,为接受或拒绝决策生成外部证据。该框架结合 COOPERATE 和 COMPETE 两种互补机制。
所提出的协作流程如下所示。
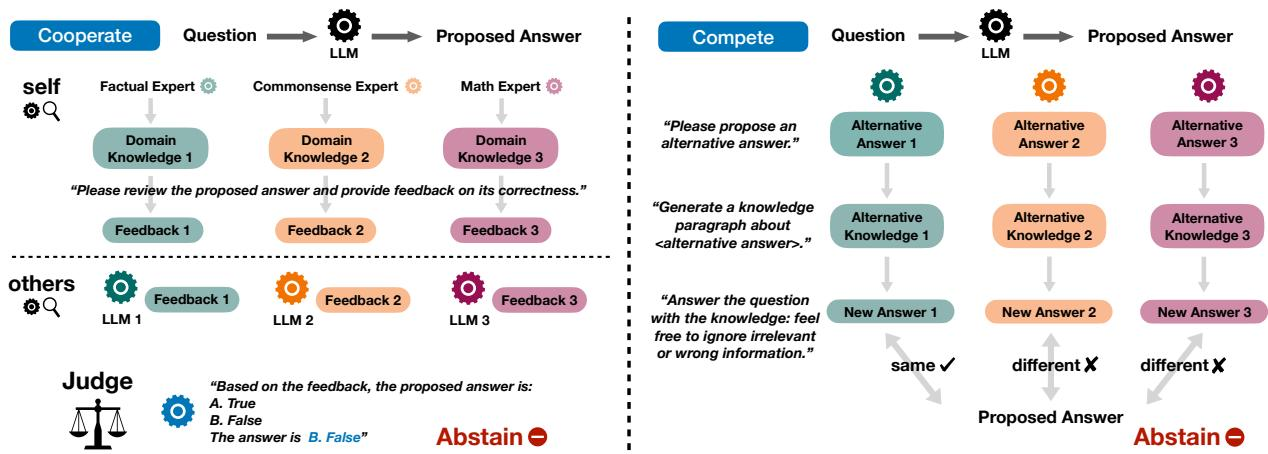
在 COOPERATE 模式中,问题 q 首先由主 LLM 回答,得到 a=LLM(q)。随后,若干专家 LLM 针对该答案提供自然语言反馈 {f1,…,fk}。这些反馈信号由一个裁判 LLM 汇总,生成最终弃答决策:
LLM(q,a,{f1,…,fk})→{accept,reject}.反馈可以以两种模式生成。在自模式中,同一个 LLM 被提示在不同领域进行专业化,首先针对 q 生成领域特定知识段落,随后扮演评审角色评估提出的答案。在他人模式中,不同 LLM 独立生成反馈 fi=LLMi(q,a)。这种设计利用了模型知识覆盖范围的差异,使一个模型内部知识中的缺口能够通过另一个模型的反馈被识别。
在 COMPETE 模式中,弃答由冲突信息下的答案稳定性驱动。从原始答案 a=LLM(q) 出发,其他 LLM 生成替代答案 {a1′,…,ak′} 以及支持性知识段落。随后,原始 LLM 再次被提示,每次结合一个冲突知识段落,生成修正后的答案:
a~i=LLM(knowledgei,q).如果 a~i 仍与原始答案相同,模型表现出一致性。如果答案发生变化,说明模型受到冲突输入影响,表明置信度更低。该过程在多个替代答案上重复执行,当答案在多数试验中发生变化时,LLM 弃答。
实验
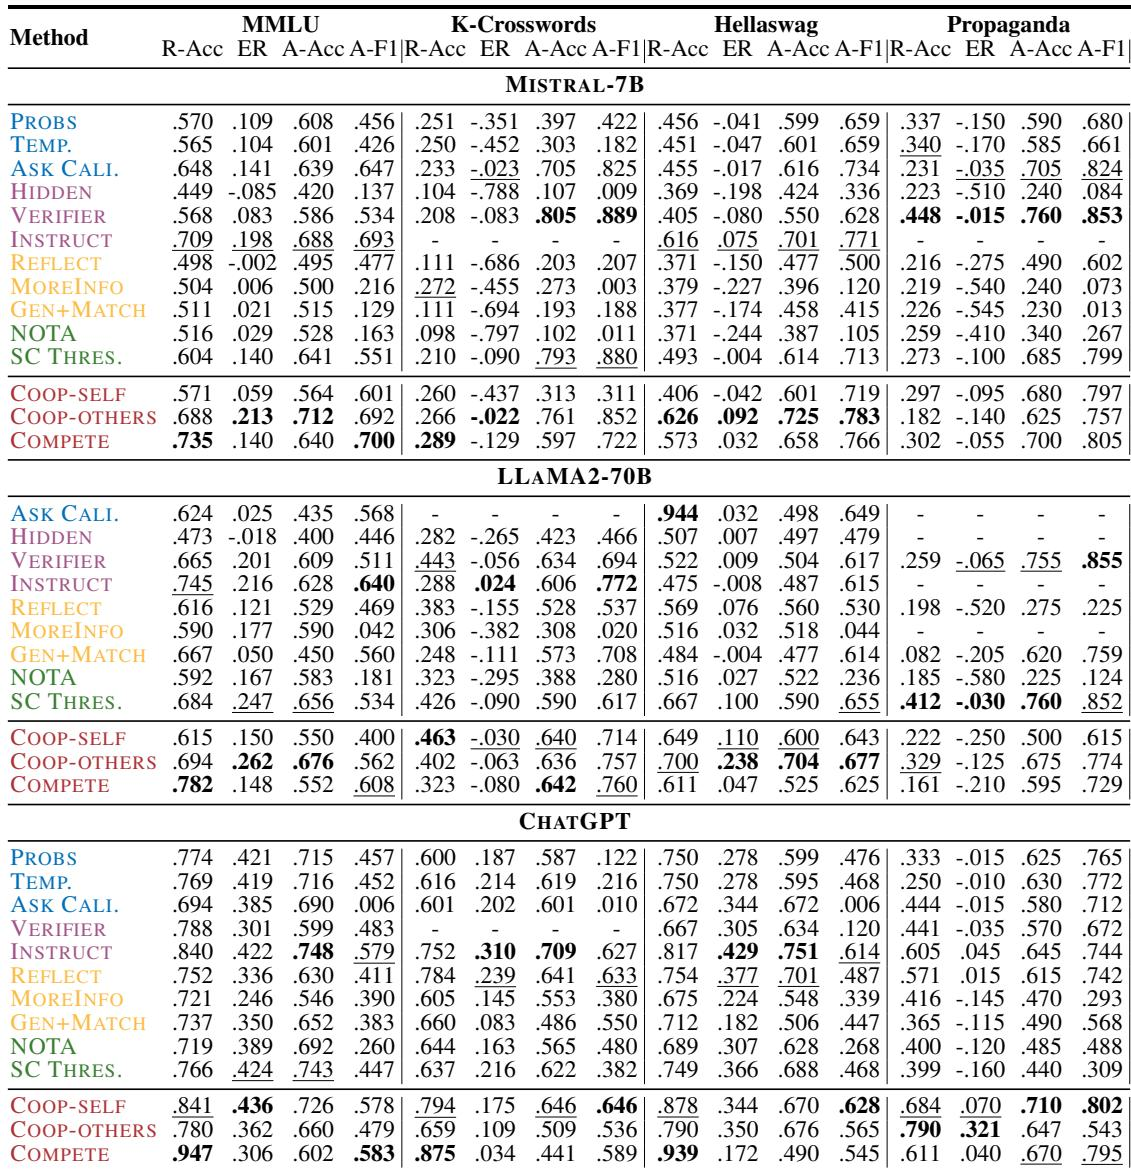
实验在三个模型和四个知识密集型任务上评估 LLM 弃答,衡量指标包括答案可靠性、覆盖率、弃答质量和校准。结果表明,基于协作的弃答方法总体上优于现有基线,并在不同领域、推理场景和模型强度下保持鲁棒。进一步分析显示,这些方法能够处理绝对弃答场景、选择性检索、多跳推理定位和校准弃答分数,其中 COMPETE 强调保守可靠性,COOPERATE 提供更均衡的覆盖。
基于协作的弃答策略 COOPERATE 和 COMPETE 在四个任务和三个语言模型上展现出最强的整体可靠准确率。校准、训练和一致性方法通常优于简单提示,同时校准和更强的基础模型往往带来更好的弃答质量。在多数评测设置中,COOPERATE 和 COMPETE 相较先前基线取得最佳可靠准确率。COOPERATE 受益于更强的基础模型,说明其多步骤反馈流程需要能力更强的 LLM。COMPETE 强烈偏向可靠性,仅在高度自信的情况下作答,因此可靠准确率较高。指令微调和自一致性阈值是强基线,但依赖留出数据进行调整。弃答质量往往与基础模型的实用性相关,更强的 LLM 能够实现更高的平均弃答准确率。
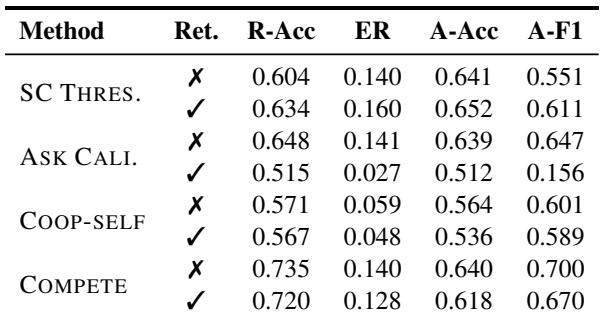
该结果比较了 Mistral-7B 在无检索和检索设置下于 MMLU 上的弃答策略。检索显著削弱了 ASK CALIBRATE,而在前置检索上下文时,基于协作的弃答行为显得更稳定。COMPETE 在无检索时表现出较强的答案质量,支持其用于选择性检索决策。当加入检索上下文时,ASK CALIBRATE 的弃答性能大幅下降。COOP-SELF 随检索仅发生较小变化,表明其对前置上下文具有鲁棒性。在所展示的无检索变体中,COMPETE 具有最高的答案 F1。
使用 Mistral-7B 时,弃答校准误差在不同任务和方法之间变化明显,表明校准依赖于方法路径和数据集。ASK CALIBRATE 在 MMLU 和 Hellaswag 上相对较强,而 COOP-SELF 和 VERIFIER 分别在其最强任务上提供最佳校准。ASK CALIBRATE 在 MMLU 和 Hellaswag 上的弃答校准误差最低。COOP-SELF 在 K-Cross 上表现最强,VERIFIER 在 Propaganda 上表现最强,说明存在针对特定数据集的校准权衡。
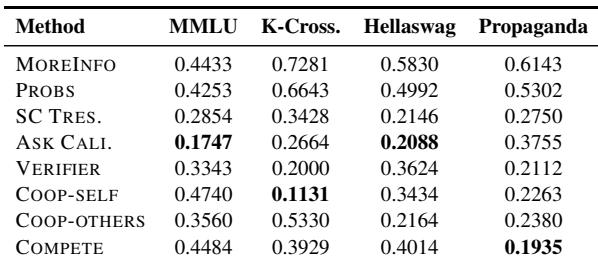
这些实验在多个任务和语言模型上评估弃答策略,比较基于协作、校准、训练、一致性和提示的基线方法。基于协作的方法,尤其是 COOPERATE 和 COMPETE,通常提供最强的可靠准确率,其中 COMPETE 高度保守,而 COOPERATE 受益于更强的基础模型。聚焦检索的 MMLU 结果表明,检索上下文可能削弱某些校准方法,而基于协作的策略更稳定,校准质量因方法和数据集而异。总体而言,可靠弃答取决于策略设计和基础模型能力,其中基于协作的方法表现出最鲁棒的性能。