Command Palette
Search for a command to run...
CausalGym:在语言学任务上基准测试因果可解释性方法
CausalGym:在语言学任务上基准测试因果可解释性方法
Aryaman Arora Dan Jurafsky Christopher Potts
摘要
语言模型(LM)已被证明是心理语言学研究的有力工具,但此前大多数工作聚焦于纯行为层面的度量(例如意外度比较)。与此同时,模型可解释性领域的研究开始揭示塑造语言模型行为的抽象因果机制。为将这两条研究路线更紧密地结合起来,我们提出了 CausalGym。我们对 Syntax-Gym 任务套件进行了改造与扩展,以基准测试各类可解释性方法对模型行为施加因果影响的能力。为展示 CausalGym 的使用方法,我们研究了 Pythia 系列模型(14M–6.9B),并评估了包括线性探测和分布式对齐搜索(DAS)在内的多种可解释性方法的因果效力。我们发现 DAS 优于其他方法,因此利用它研究了 Pythia-1B 中两种复杂语言现象的学习轨迹:负极性项允准和填充-空位依赖。我们的分析表明,实现这两项任务的机制是以离散阶段而非渐进方式习得的。
一句话总结
斯坦福大学提出 CausalGym,该基准改编自 SyntaxGym,用于评估可解释性方法能否对语言模型行为产生因果影响。研究发现,分布式对齐搜索在 Pythia 模型(14M 至 6.9B)上优于其他方法,并揭示了负极性项允准与 filler-gap 依存关系的实现机制是在离散阶段学习得到的,而不是逐渐形成的。
核心贡献
-
CausalGym 是改编自 SyntaxGym 的基准,使用模板化最小对和模型干预来衡量可解释性方法能否识别出可因果影响语言模型中语言行为的特征;该基准在参数规模从 14M 到 6.9B 的 Pythia 模型上进行了评估。
-
该研究在因果任务上对线性探测和分布式对齐搜索进行了基准测试,发现分布式对齐搜索具有最强的因果效力,并引入了源自探测的控制任务,用于说明任意输入-输出映射的影响,从而缩小与其他方法之间的差距,使比较更公平。
-
使用采用分布式对齐搜索的 CausalGym 分析 Pythia-1b 中的负极性项允准与 filler-gap 依存关系学习,发现因果机制依赖多步骤信息移动,并且这些机制以离散阶段出现,而非逐渐出现。
引言
语言模型越来越多地作为心理语言学工具,用于估计词语 surprisal、合语法性和更广泛的语言处理行为;定向句法基准测试模型是否会给合语句对分配更高概率。该研究方向的一个主要局限在于,它只评估输入-输出行为,而未揭示模型决策背后的内部机制。同时,探测和分布式对齐搜索等可解释性方法大多只在狭窄数据集上测试,而不是在多样且具有心理语言学基础的基准上测试。作者利用线性表示假设和干预方法提出 CausalGym,这是改编自 SyntaxGym 的基准,用于衡量可解释性方法能否识别线性特征子空间,并通过操控这些子空间来因果地改变语言行为。作者还改编了探测中的控制任务,以防止方法仅仅通过生成任意输入-输出映射而成功,从而实现更公平的评估。
数据集
-
作者介绍 CausalGym,这是一个通过把 SyntaxGym 核心英语测试套件转换为模板生成器来构建的数据集,用于生成跨度对齐的最小对。
-
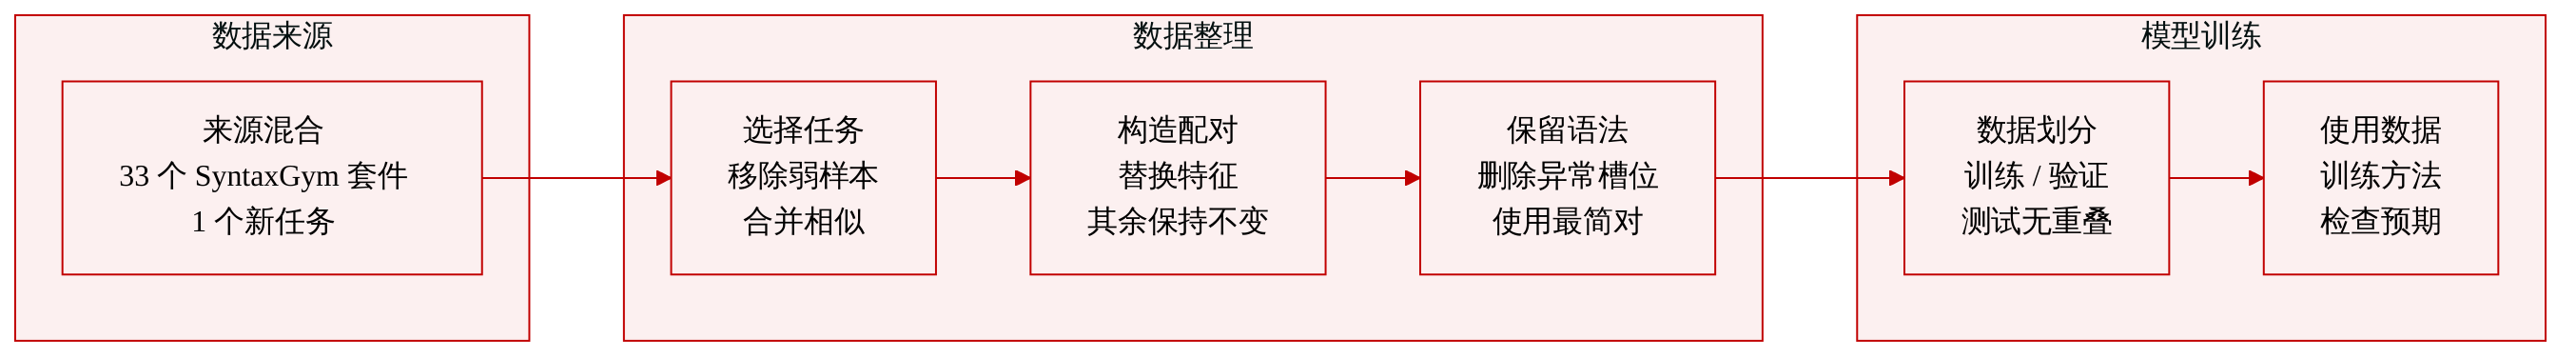
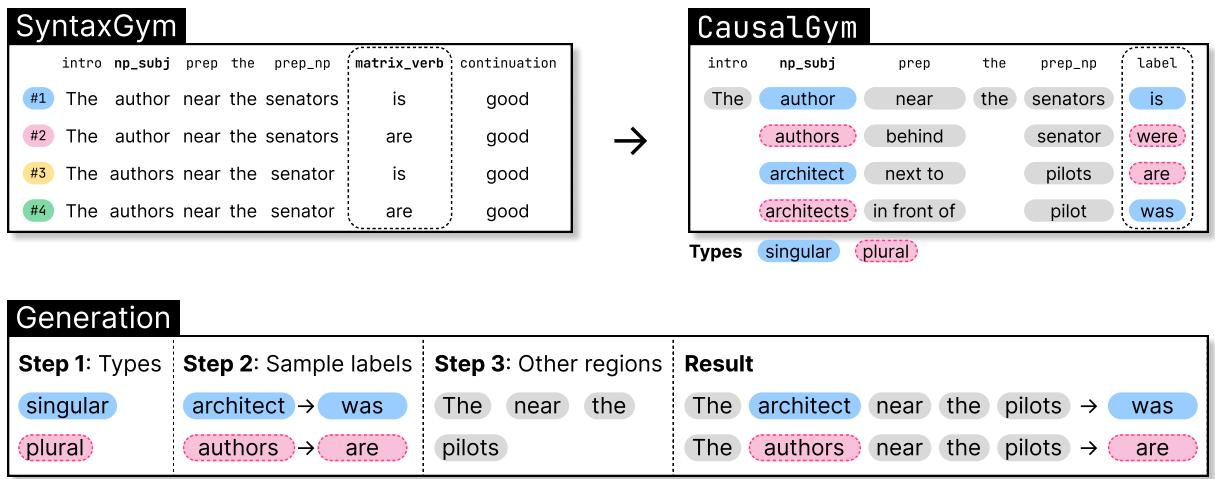
基准从 33 个 SyntaxGym 测试套件开始。作者舍弃了 2 个中心嵌套任务,将 6 个带性别的反身代词允准任务合并为 3 个不带性别的任务,并保留允许成对合语句的任务,从而得到 28 个模板化任务。他们添加了一个新任务 agr_gender,共 29 个任务。
-
SyntaxGym 中的源任务一次只关注一个语言特征。每个项目使用相同模板和区域结构,保持无关特征不变,只在各个条件下变化目标特征。
-
由于原始测试套件包含少于 50 个条目,作者对其模板化以生成更大语料。他们使用对齐的句法区域作为槽位,这些槽位可在条目间混合匹配,从而组合创建新示例。
-
作者通过只选择每个条目中的两个合语条件,并将行为改写为反事实映射,把 SyntaxGym 条件转换为监督式输入-输出对。例如,主语数决定预期的下一个动词,而句子其他部分(包括干扰名词)保持不变。
-
每个模板都包含标签变量和 expected next-token 标签的类型。为了生成一个配对,作者采样两个不同类型,为第一个句子选择第一种类型的一个选项,为第二个句子选择第二种类型的一个选项,然后对所有非标签区域采样一个共享选项,使得只有相关特征发生变化。
-
数据集通过要求合语句对,并手动移除可能产生存疑合语句的槽位选项进行过滤。
-
作者使用生成数据训练监督式可解释性方法,构建互不重叠测试集,并评估当输入特征改变时语言模型是否产生类人的预期。
方法
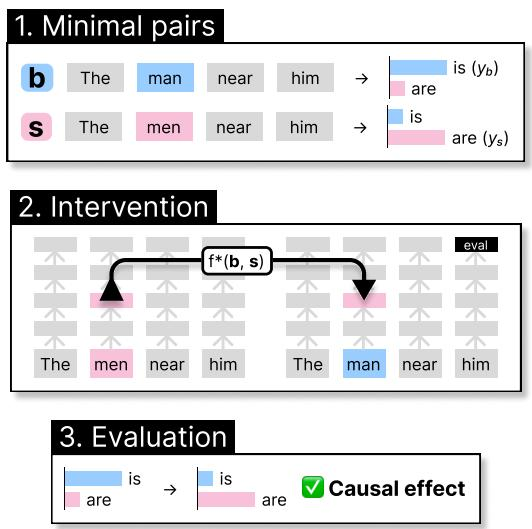
作者将该方法构建为一个耦合流程,先把语言学基准条目转换为稠密反事实模板,再利用这些模板研究语言模型内部的因果机制。核心思想是将每个原始测试条目简化为最小输入-输出变换,该变换改变一个语言特征(例如主语数),同时保持其他内容固定。这使得行为适合监督式特征发现和因果干预。
为了获得足够多的可用训练数据,作者从每个原始条目中选择两个合语条件,并将它们改写为反事实对。例如,主谓数一致表示为两个句子,二者只在语法上相关的主语槽位和相应的同数动词上不同:
The author near the senators⇒is The authors near the senators⇒are在原始基准中,每个条目相对较小,只包含少量示例。因此,作者将每个条目分解为对齐区域,并把这些区域作为模板生成系统中的槽位复用。每个模板都有一组类型,这些类型同时控制变量标签区域和 expected next-token 标签。为了生成反事实对,该过程首先采样两个不同类型 t1 和 t2。然后,它为第一个句子采样一个类型为 t1 的选项,为第二个句子采样一个类型为 t2 的选项。所有非标签区域只采样一次,并在配对中共享,因此只有预期特征发生变化。作者还应用手动过滤步骤,移除可能产生合语法性不确定的句子的槽位选项。参见框架图。
下游分析围绕一个干预函数展开。作者沿单一特征方向使用一维分布式交换干预,简称 1D DII,来对干预进行基准测试。设 f 是将输入表示映射到 token 级表示的函数。给定特征方向 a∈Rn,干预函数用 fa∗ 替换 f,定义为
fa∗(b,s)=f(b)+(f(s)a⊤−f(b)a⊤)a其中 b 是基础输入,s 是反事实输入。被干预的模型写作
pf←fa∗作者固定 f 在 token 级表示上操作。由于基础序列和反事实序列在 tokenization 后可能具有不同长度,表示会在每个模板区域的最后一个 token 处对齐。选择这种一维干预形式,是因为二元语言特征通常可以通过模型激活空间中的一维子空间进行控制。它也自然地与线性探测对齐,因为线性探测学习到的类别方向可以直接用作干预向量。
该基准比较了发现特征方向 a 的几种方法。监督式方法包括分布式对齐搜索、线性探测、均值差和线性判别分析。无监督式方法包括主成分分析、两分量聚类和随机方向基线。每种方法输出一个向量 a,该向量随后作为固定方向用于 1D DII 函数中。
分布式对齐搜索直接从反事实训练数据中学习干预方向。该过程初始化 adas,冻结基础模型权重,并只优化干预向量,使被干预的模型为期望的反事实输出 ys 分配高概率。训练目标为
adasmin−(b,s,yb,ys)∈T∑logpf←fadas∗(ys∣b,s)学习到的 adas 随后定义干预函数 fadas∗。
线性探测在基础输入-输出示例上训练一个 softmax 分类器。给定表示 x,探测器为
qθ(y∣x)=softmax(aprobe⋅f(x)+b)参数在基础训练集上优化,通常通过最大化基础标签 yb 的似然。探测权重向量 aprobe 随后被复用为因果干预方向。
均值差从类别均值之间的分离中学习方向。设 X1 和 X2 为与两个目标类别关联的基础示例集合。学习到的方向为
amean=∣X1∣1x∈X1∑f(x)−∣X2∣1x∈X2∑f(x)或等价地
amean=μ1−μ2线性判别分析通过假设类别特定均值和共享协方差矩阵 Σ 来扩展这一思想。其干预方向为
alda=Σ−1(μ1−μ2)主成分分析不使用类别标签。它将均值中心化激活的第一个主成分选为干预方向。目标是在该方向上最大化方差:
apcamaxx∈X1∪X2∑(f(x)⋅apca)2其中 f(x) 表示均值中心化激活。
对于基于聚类的发现,作者对激活使用两分量聚类。如果两个簇的质心为 μ1 和 μ2,则方向为
akmeans=μ1−μ2这些组件共同构成实验架构:模板化反事实生成提供受控的训练和评估示例,特征发现方法产生候选特征方向,1D 分布式交换干预则测试这些方向能否因果控制所研究的语言行为。
实验
评估使用 CausalGym,这是一个源自 SyntaxGym 的大规模模板化基准,通过干预 residual stream 组件并衡量 Pythia 模型系列上的对数几率比偏移,来测试语言模型是否以因果对齐的方式表示语言特征。实验在许多任务上比较特征发现方法,发现监督式方法(尤其是 DAS)比无监督方法更有效地识别因果影响子空间,尽管 DAS 在控制任务上也表现良好,这表明其部分优势反映的是表达能力,而不是纯粹的语言选择性。关于 NPI 允准和 filler-gap 依存关系的案例研究进一步表明,模型实现了复杂分布式机制,这些机制在训练期间出现并扩展。
在各种模型规模上,DAS 始终识别出因果效力最强的特征,其次是探测和均值差,而无监督方法表现明显更差。监督式 LDA 仅略高于随机特征,平均任务准确率随模型规模上升。在更大规模上,DAS 并不明显比探测或均值差更具选择性,这表明训练期间可访问模型输出是其优势来源之一。DAS 在不同规模下展现出最强的特征发现性能,并且随着模型规模增大,它相对探测的绝对优势也更大。在更大规模上,DAS 的选择性仍与探测和均值差相当或更低,支持其优势部分来自使用模型输出的观点。
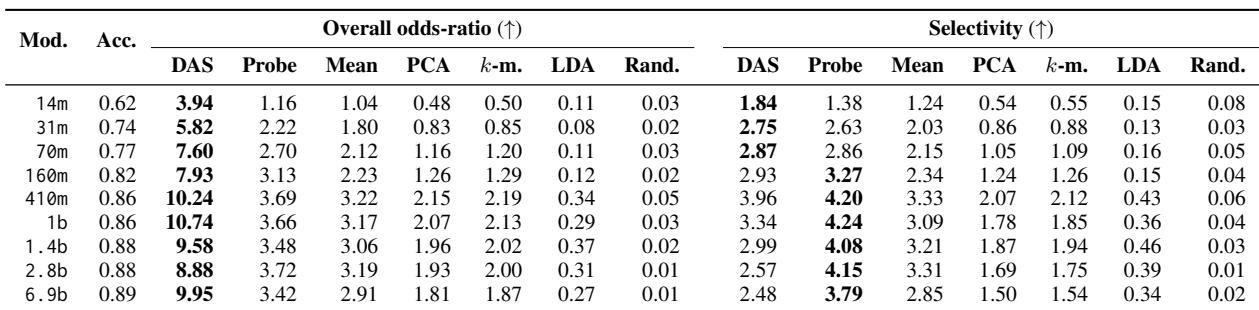
在各种模型规模上,实验评估了识别因果效力特征的方法,并表明 DAS 始终表现最佳,其次是探测和均值差,而无监督方法表现明显更差,监督式 LDA 仅略高于随机特征。平均任务准确率随模型规模上升,并且随着模型变大,DAS 相对探测的特征发现绝对优势更大。在更大规模上,其选择性仍与探测和均值差相当或更低,支持其优势部分来自训练期间访问模型输出的观点。