Command Palette
Search for a command to run...
因果引导的主动学习用于大语言模型去偏
因果引导的主动学习用于大语言模型去偏
Zhouhao Sun Li Du Xiao Ding Yixuan Ma Yang Zhao Kaitao Qiu Ting Liu Bing Qin
摘要
尽管当前生成式大语言模型(LLMs)已取得令人瞩目的性能表现,但近期分析表明,其仍可能捕获数据集中的偏差并利用这些偏差进行生成,从而导致模型泛化能力差且存在有害性。然而,由于数据集偏差的多样性以及过度优化问题,先前基于先验知识的去偏方法和基于微调的去偏方法可能并不适用于当前的 LLMs。为解决这一问题,我们探索将主动学习与因果机制相结合,提出了一种因果引导的主动学习(CAL)框架。该框架利用 LLMs 自身自动且自主地识别信息丰富的偏差样本并归纳偏差模式。随后,采用一种低成本且高效的基于上下文学习的方法来防止 LLMs 在生成过程中利用数据集中的偏差。实验结果表明,CAL 能够有效识别典型偏差实例并归纳多种偏差模式,从而实现 LLMs 的去偏。
一句话总结
来自哈尔滨工业大学和北京智源人工智能研究院的研究人员提出了一种因果引导的主动学习(CAL)框架。该框架利用大语言模型(LLM)自身,通过因果机制自主识别有偏样本并归纳偏差模式,并采用上下文内学习阻止 LLM 在生成过程中利用数据集偏差,从而提升泛化能力并降低有害性。
核心贡献
- 本文提出了一种因果引导的主动学习框架,该框架利用生成式大语言模型中不变语义关系与相关性偏差模式之间的因果不变性差异,识别包含数据集偏差的反例对。
- 该框架借鉴主动学习的选择标准,依据数据集偏差对模型生成的影响及其对偏差模式归纳的典型性,选择信息丰富的有偏样本,从而无需依赖人工预定义的偏差先验即可自动发现偏差模式。
- 一种基于上下文内学习的低成本去偏方法利用所选样本对 LLM 进行正则化,防止其在生成过程中利用有偏模式;实验表明,该方法能够有效识别有偏样本、归纳偏差模式,并提升泛化能力、降低有害性。
引言
大语言模型如今已成为自然语言处理的核心,但其生成式预训练可能吸收数据集偏差,例如位置偏差和刻板印象偏差,从而降低可靠性、泛化能力和安全性。以往的去偏方法往往依赖人工识别的偏差,且难以扩展;而自动方法主要面向判别式模型,或依赖微调,可能过度优化并损害更广泛的性能。作者利用因果不变性将真实语义关系与表面的数据集相关性分离,使用主动学习识别反例对并选择信息最丰富的有偏样本。随后,归纳可解释的偏差模式,并通过上下文内学习对 LLM 进行正则化,以提升泛化能力和安全性。
方法
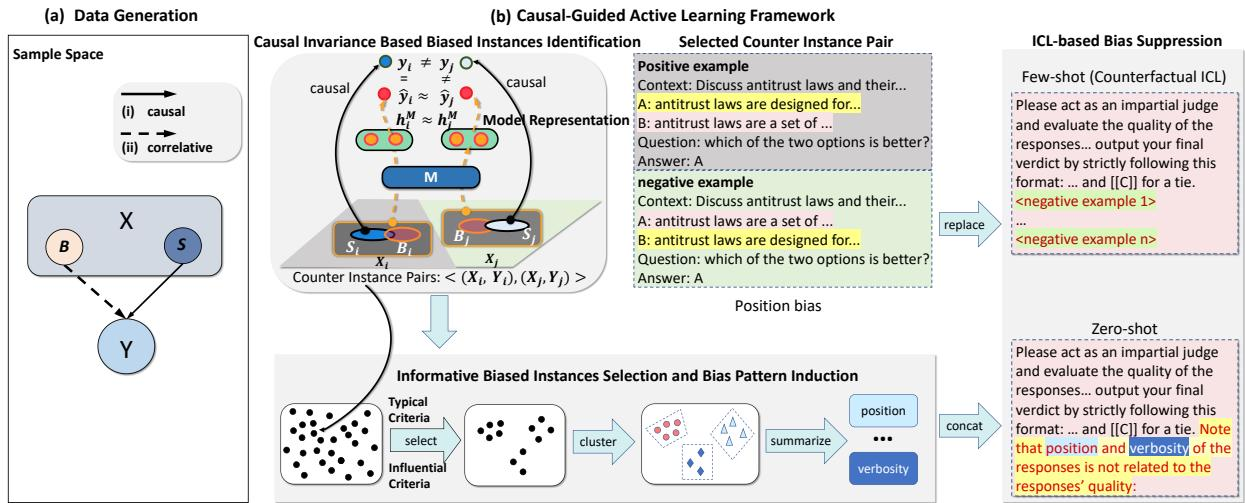
该方法被组织为三阶段流程:首先通过因果不变性识别有数据集偏差的样本,然后选择信息丰富的偏差案例并归纳显式偏差模式,最后通过提示级正则化抑制所发现的偏差。参阅下方框架图,可看到从有偏样本识别到偏差模式归纳以及基于上下文内学习的偏差抑制的完整流程。
第一个模块通过检验模型是否获得不变的预测表示来识别有偏样本。该框架将每个输入文本 Xi 视为包含两个潜在组成部分:语义信息 Si 和数据集偏差 Bi。对于两个样本 (Xi,Yi) 和 (Xj,Yj),该方法寻找底层偏差相似但语义不同的情况,即
Bi=Bj,Si=Sj.在因果不变性条件下,如果模型主要捕捉语义信息,那么相似的语义结构应导致相似的生成结果。因此,当两个输入的模型表示接近,但它们的真实后续文本明显不同,则共享的预测信息很可能是虚假偏差,而不是稳健语义。作者用反例对定义对此进行形式化。对于数据集 D,当一对 ⟨(Xi,Yi),(Xj,Yj)⟩ 满足以下条件时,它被视为反例对:
Sim(HiM,HjM)>τ,s.t.Sim(Yi,Yj)<α,其中 HiM 和 HjM 是由 Xi 和 Xj 产生的模型表示,Sim(⋅,⋅) 是相似度分数,τ 控制表示必须接近的程度,α 确保目标文本足够不同。这些反例对表明模型可能依赖于非不变的有偏线索。
为避免将模糊或难以理解的样本误判为偏差案例,该流程增加了一个预测过滤条件。模型至少应为两个输入之一生成较为合理的后续文本;否则,接近的表示可能反映的是预测能力不足,而不是使用了偏差。该过滤准则写作
Sim(Y^i,Yi)>β∨Sim(Y^j,Yj)>β,其中 Y^i 和 Y^j 是生成的输出,β 是阈值。因此,保留下来的样本对属于模型已经捕捉到某种预测信息,但该预测信息违反了因果不变性的情况。
第二个模块从检测到的反例对中选择信息最丰富的有偏样本。选择遵循两个原则。第一,如果模型产生正确后续文本的概率较低,则该对影响更强,因为这表明有偏信息强烈干扰生成。影响性准则可表示为
p^j,lj<τp,s.t.Sim(Y^j,Yj)<α,其中 p^j,lj 是模型分配给真实后续文本 lj 的概率,τp 是概率阈值。第二,如果模型对两个示例的不当生成结果相似,则该对更具典型性。相似的错误输出意味着同一类偏差同时影响了两个案例,使偏差模式更容易被总结。典型性准则写作
Sim(Y^i,Y^j)>β.在选出信息丰富的反例对后,作者归纳可解释的偏差模式。对于每一对,HiM 和 HjM 的共享部分被视为偏差表示向量,因为两个输入在语义上不同,却通过相同的数据集诱导出相似的模型表示。这些偏差向量通过主成分分析被降到低维空间,并使用密度聚类方法进行聚类。每个最终聚类包含可能共享共同偏差机制的反例对。随后,每个聚类中的示例被提供给语言模型,用于总结人类可读的偏差模式,例如位置偏差或冗长偏差。
第三个模块在推理时使用归纳出的偏差模式对 LLM 进行正则化,而无需微调。在零样本设置中,检测到的模式直接附加到原始提示后。提示指令明确告诉模型不要使用被识别出的线索,例如添加类似以下句子:“[偏差 xxx] 与 [任务目标] 无关。” 这使得偏差约束显式化,并抑制模型利用相关但非因果的信号。
在少样本设置中,作者基于所选有偏样本构造反事实上下文示例。对于一个反例对,如果模型因遵循数据集偏差而生成错误结果,则该样本就成为反事实示例:依赖偏差会导致偏离期望输出。此类示例会被放入提示中,并附带明确说明,例如:
“<EXAMPLES>. Note that you should not utilize biased information to make generations.”这里,示例展示了有偏线索不应决定答案的情况,而附加指令则强化了预期的语义决策规则。提示级设计使该方法能够纠正偏差行为,同时避免微调带来的成本和副作用。
实验
实验在两个 LLM 上评估所提出的 CAL 方法,涉及分布内和迁移偏差设置下的任务,包括响应偏好、自然语言推理和刻板印象检测,并与朴素提示、少样本提示以及先验知识去偏基线进行比较。结果表明,CAL 能够持续改善泛化能力并减少对有害刻板印象的依赖,同时还识别出位置、冗长、格式和刻板印象相关等可解释偏差模式。额外分析表明,所发现的模式能够跨模型迁移,在由开源模型或有限数据归纳时仍然有效,并凸显了自主 LLM 去偏的潜力。
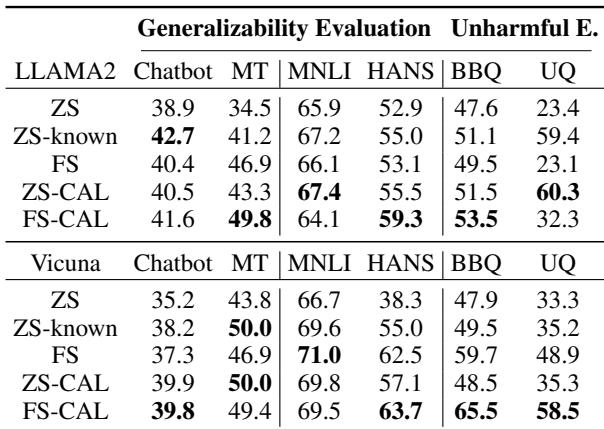
在报告的 LLaMA 评估中,先验知识零样本方法和 CAL 变体总体上均优于朴素零样本性能,表明偏差感知提示能够减少偏差相关错误。CAL 在零样本设置中表现尤为突出:它提高了非有害性分数,并超过了一些少样本基线;而少样本 CAL 带来更广泛的收益,尽管 MNLI 略有下降。相对于朴素零样本评估,零样本 CAL 改善了所有报告的 LLaMA 指标。相对于少样本基线,少样本 CAL 改善了大多数报告的 LLaMA 指标,但在一个泛化指标上略有下降。
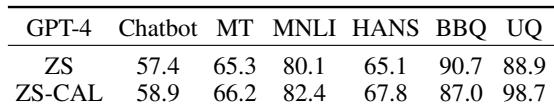
实验检验了从一个 LLM 发现的偏差模式是否能通过应用到 GPT-4 来为另一个 LLM 去偏。在大多数评估任务中,ZS-CAL 优于朴素零样本方法,这表明迁移的偏差模式有助于减少有偏行为。HANS 上的例外情况表明,跨模型迁移并非在所有情况下都有效。来自 Llama2-13B-Chat 的偏差模式可以迁移到 GPT-4 上进行去偏。在大多数数据集上,ZS-CAL 带来了更高的零样本性能,其中在 UQ 上有显著收益。HANS 在 ZS-CAL 下出现小幅准确率下降,表明迁移部分有效。
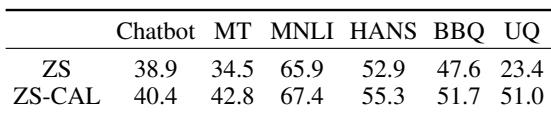
使用开源大语言模型归纳偏差模式能够提升所评估数据集上相对于零样本基线的任务性能。归纳出的模式仍然有效,尽管性能略低于由更强的专有模型归纳模式的情况。这些结果说明,基于自动学习偏差模式的去偏能够跨模式归纳模型泛化,并不局限于某个特定大语言模型。由 Qwen-72b-chat 归纳出的偏差模式在评估任务上均优于零样本推理。开源模式归纳仍然能提升性能,但略逊于 GPT-4 模式归纳。由于在使用不同偏差模式归纳模型时去偏收益仍然存在,该框架表现出可泛化性。
使用 20% 子集进行偏差模式归纳后,CAL 在 MNLI 和 HANS 评估中仍保持接近全数据设置的性能。CAL 仍然优于相应的零样本和少样本基线,并在 HANS 上取得尤其显著的收益。这表明当可用标注数据较少时,该去偏方法仍然有效。当偏差模式归纳仅使用 20% 数据时,CAL 性能保持稳定;在减少数据的情况下,CAL 在 HANS 上仍保持对基线方法的显著优势。
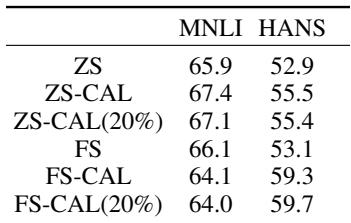
在 LLaMA 上的实验比较了朴素提示、偏差感知提示和 CAL 在零样本与少样本设置下的表现,表明偏差感知提示通常能够减少偏差相关错误;其中零样本 CAL 尤为有效,而少样本 CAL 尽管在泛化指标上略有下降,仍普遍改善了结果。跨模型测试将来自 LLaMA2-13B-Chat 的偏差模式迁移到 GPT-4,在大多数任务上取得改善,但 HANS 表明迁移并非在所有情况下都有效。使用 Qwen 模式归纳和 20% 数据子集的额外结果表明,该方法在较弱模型和较少标注数据下仍然有效,尽管专有模型归纳可能仍略强。