Command Palette
Search for a command to run...
L-Eval:建立长上下文语言模型的标准化评估体系
L-Eval:建立长上下文语言模型的标准化评估体系
Chenxin An Shansan Gong Ming Zhong Xingjian Zhao Mukai Li Jun Zhang Lingpeng Kong Xipeng Qiu
摘要
近年来,大语言模型(LLM)的长上下文扩展引起了越来越多的关注。为推动该领域的研究,我们提出了 L-Eval,旨在为长上下文语言模型(LCLM)建立更为标准化的评估体系,重点关注数据集构建和评估指标两个关键方面。一方面,我们构建了一个新的评估套件,包含 20 个子任务、508 篇长文档以及超过 2,000 条人工标注的问答对,涵盖了多样的任务类型、领域和输入长度(3k–200k tokens)。另一方面,我们探究了 LCLM 评估指标的有效性,结果表明长度指令增强(LIE)评估和大模型裁判(LLM judges)能够更好地与人类判断相关联。我们使用 L-Eval 基准对 4 款主流商业大语言模型和 12 款开源模型进行了全面研究。我们的实证发现为 LCLM 的研究提供了有价值的见解,并为建立更为规范化的评估体系奠定了基础。
一句话总结
来自复旦大学、香港大学、伊利诺伊大学厄巴纳-香槟分校和上海人工智能实验室的研究人员提出了 L-Eval,这是一个包含 20 个子任务、508 篇长度为 3k 到 200k tokens 的长文档的标准化基准,用于评估长上下文语言模型;研究表明,Length-Instruction-Enhanced(LIE)评测以及 LLM judges 比现有指标更能反映人类判断。
核心贡献
-
L-Eval 被引入作为面向长上下文语言模型的标准化评测套件,包含 20 个子任务、508 篇长文档,以及跨任务类型、领域和 3k 到 200k tokens 输入长度的 2,000 多个人工标注的查询-响应对。
-
Length-Instruction-Enhanced evaluation 被开发出来,用于引导模型产生符合期望长度的答案;实验表明,这种方法与 LLM judges 相比标准 n-gram 指标与人类判断的相关性更好。
-
本文对 L-Eval 上的 16 个 LLM 进行了研究,发现开源模型与商业模型之间存在差距,上下文扩展方法在开放式任务上表现较弱,端到端长上下文模型优于基于检索的系统,并且无需训练的缩放位置嵌入对检索和推理的影响不一。
引言
长上下文语言模型正变得越来越重要,因为许多真实世界应用需要对文档、会议、代码库和其他扩展输入进行推理。现有用于这些模型的基准往往过于受限,依赖短提示词、狭窄的任务分布以及自动分数(例如 ROUGE),这些自动分数可能无法捕捉模型质量上的有意义差异。
作者引入了 L-Eval,这是一个用于长上下文评测的标准化基准。L-Eval 覆盖封闭式任务和开放式任务,通过新标注样本扩展任务多样性,并使用多种评测方法,包括基于参考的指标、LLM judges 和人工评测。论文还提出 Length-Instruction-Enhanced evaluation,以减少自动评分中的长度偏差,并研究了 16 个近期模型,以揭示模型能力和评测保真度方面的差距。
数据集
-
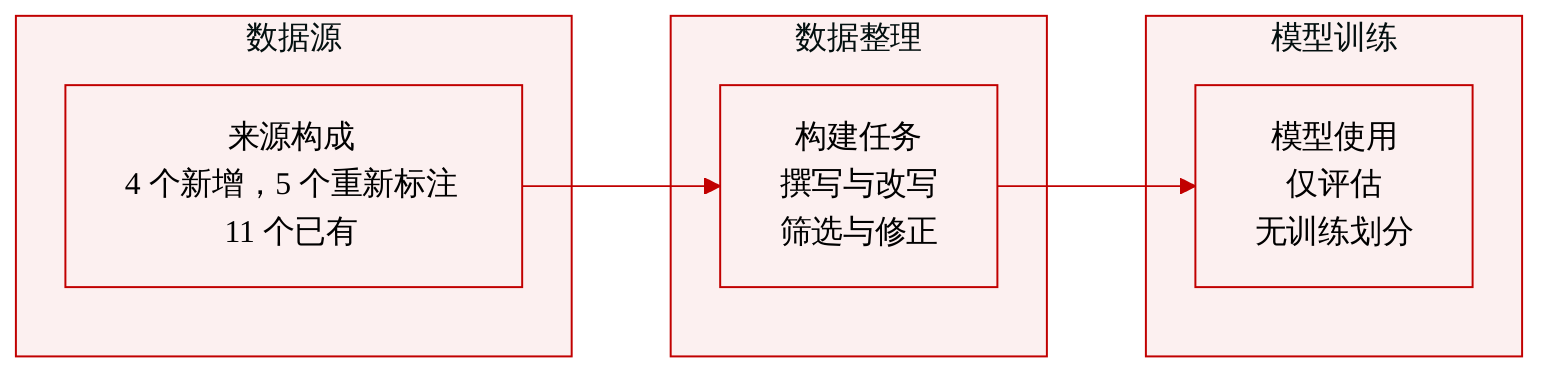
作者构建了 L-Eval,作为一个包含 20 个任务的长上下文基准,将数据划分为三条构建路径:新标注任务、从公共数据集重新标注的数据集,以及经过修正和筛选的现有任务。
-
数据集组成和来源:
- 四个子集从零开始标注:Coursera、SFiction、CodeU 和 LongFQA。
- 五个子集从公共数据集重新标注:GSM(16-shot)、QuALITY、Openreview、SPACE 和 TopicRet。
- 另外 11 个任务来自现有数据集,并通过人工审查流程进行处理。
-
标注子集的关键细节:
- Coursera:基于大数据和机器学习课程的 Coursera 讲座字幕构建;问题、选项和标准答案由论文作者编写;这是一个封闭式任务,可以有多个正确选项。
- SFiction:基于科幻小说上下文构建;使用 True/False 问题,其中许多答案与真实世界事实冲突,以测试模型是否依赖给定上下文而非参数化知识。
- CodeU:基于调用 NumPy 函数和自定义字符串处理代码库的长 Python 程序构建;函数名称被替换为 Op1 和 Op2 等占位符,以防止模型从描述性名称推断行为。
- LongFQA:基于从六家公司网站的 Investor Relations 页面收集的公司财报电话会议纪要构建;面向长上下文金融问答。
-
重新标注的公共数据集关键细节:
- GSM(16-shot):使用来自 GSM8k 的 100 道小学数学题,并构建 16 个思维链上下文示例,其中 8 个来自 chain-of-thought-hub,另外 8 个由论文作者创建。
- QuALITY:为现有 QA 数据添加新的合成指令,以测试全局上下文建模能力。
- Openreview:论文来自 openreview.net,任务包括撰写摘要、总结相关工作和给出反馈。
- SPACE:一个评论摘要数据集被扩展为包含覆盖输入不同方面的多样化用户查询。
- TopicRet:一个合成检索任务被通过询问第二或第三主题而非第一个主题来增加难度,使其更能区分模型能力。
-
现有任务的处理与筛选:
- 作者使用 Claude-100k 从 11 个现有任务来源中筛选样本。
- 提示 Claude 从文档中生成答案和支持证据。
- 如果答案与真实标签冲突,或者无法从上下文中推断,则样本会由人工审查,然后被修正或丢弃。
- 没有描述裁剪策略或特殊截断方法;主要处理集中在标注、重新标注、合成指令、函数匿名化和错误修正。
-
规模、结构和用途:
- 数据集覆盖多种任务类型,包括选择题 QA、True/False QA、少样本数学、代码理解、对话、抽取式 QA、生成式 QA 和摘要。
- 输入覆盖法律、金融、学术论文、讲座、对话、新闻、Python 代码、小说和会议等领域。
- 平均输入长度范围从 4k 到 60k tokens,部分样本接近 200k tokens。
- 本节将 L-Eval 呈现为一个基准数据集;它没有描述训练划分、混合比例或微调用途,数据用于在长文档任务上评估模型。
方法
作者将 L-Eval 工作流构建为一个以数据为中心的评测流水线,而不是可训练模型架构。方法包含两个主要模块:通过任务标注和自动筛选进行基准构建,以及减少开放式评分中长度偏差的可控自动评测。
构建流水线首先将任务划分为封闭式和开放式格式。封闭式任务设计用于客观评分,而开放式任务面向摘要和生成式问答。对于新标注的封闭式任务,作者创建了特定领域的长上下文问题。Coursera 使用长篇讲座字幕,要求模型从细微证据中选择多个正确选项。SFiction 测试模型是否遵循上下文信息,即使信息与预训练事实知识相矛盾。CodeU 通过让模型预测具有 Op1、Op2 和 OpN 等匿名化函数名称的长 Python 程序输出,来评估代码理解,防止依赖语义化函数标签。LongFQA 使用来自金融文档的长财报电话会议纪要。这些任务设计确保基准覆盖那些推理必须基于完整输入上下文的领域和任务形式。
对于来自现有数据集的任务,作者引入了筛选和修正流程。该流程使用一个长上下文模型为每个样本生成答案和支持证据。如果生成的答案与真实标签强烈不一致,或者模型表示答案无法从提供文档中推断,则样本会被送去人工审查。审查者随后丢弃或修正样本。该模块提高了标签一致性,并移除无法仅从长输入可靠解决的噪声问答对。
在基准构建完成后,评测模块解决开放式评分中的一个关键限制:长度偏差。在初步实验中,模型倾向于生成带有解释的冗长回答,导致预测与参考答案之间的粒度不匹配。这会损害 n-gram 风格指标,因为即使事实内容有用,token overlap 也可能被扭曲。作者因此提出 Length-Instruction-Enhanced evaluation,或 LIE evaluation。核心思想是在提示中直接暴露期望输出长度。如果参考答案包含 wy 个单词,模型会收到产生恰好 wy 个单词摘要之类的指令。指标随后衡量内容准确性,而不是意外奖励或惩罚任意生成长度。
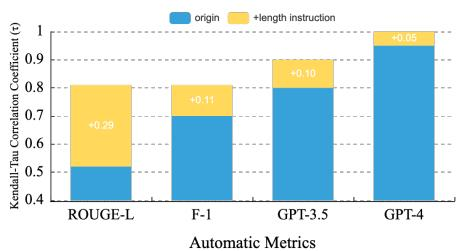
为了验证这一评测设计,作者在开放式问题上将自动指标与人类判断进行比较。三位标注者对多个模型的输出进行评分,作者计算每个自动指标与人类平均分数之间的 Kendall Tau 系数 τ。结果表明,长度控制显著提高了与人类评测的一致性。
下图所示:
柱状图说明了向多个自动指标添加长度指令所带来的提升。原本无法与人类分数保持一致的指标,在提示中包含目标长度后,相关性变得更强。对于 ROUGE-L 和 F-1,提升尤其明显,同时 GPT-4 evaluator 分数也提高到完全或接近完全相关水平。
作者进一步检查了在不同评分系统下模型排名是否变得更稳定。他们比较了六种评测方案,包括人类平均分、单独人类分数、LLM judges 和 n-gram 指标。雷达比较可视化了不同模型在不同评测者之间的排名方式。
参考雷达比较:
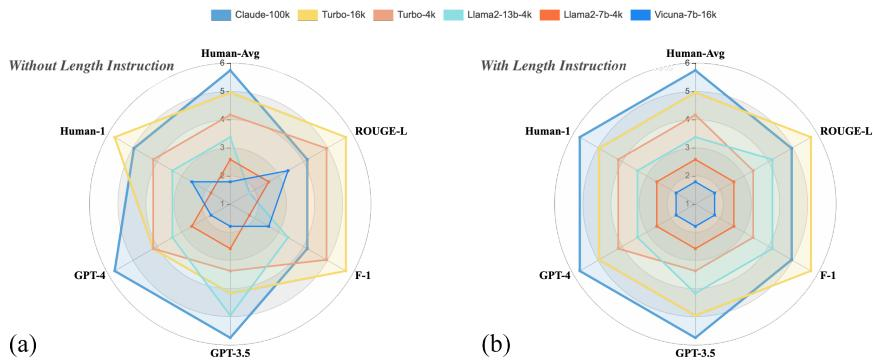
雷达图表明,没有长度控制时排名更不规则,反映了指标之间相关性较弱。使用长度指令后,排名模式变得更一致,表明受控生成长度使自动评测更忠实于人类判断。
实验
实验使用精确匹配评分对封闭式任务进行评估,并使用人工、LLM 和词法指标对开放式任务进行评估,其中包括一个长度指令协议,用于测试指标可靠性。这些实验验证了控制输出长度会增强自动评测器与人类判断之间的一致性,并有助于揭示词法分数中的长度偏差。对 16 个模型的基准测试显示,商业系统通常优于开源模型,其中 GPT-4 在封闭式任务上最强,Claude 在开放式任务上最强。结果还表明,长上下文微调有助于封闭式生成,但在鲁棒的开放式推理上仍然有限,尤其是在输入更长和检索敏感设置下。
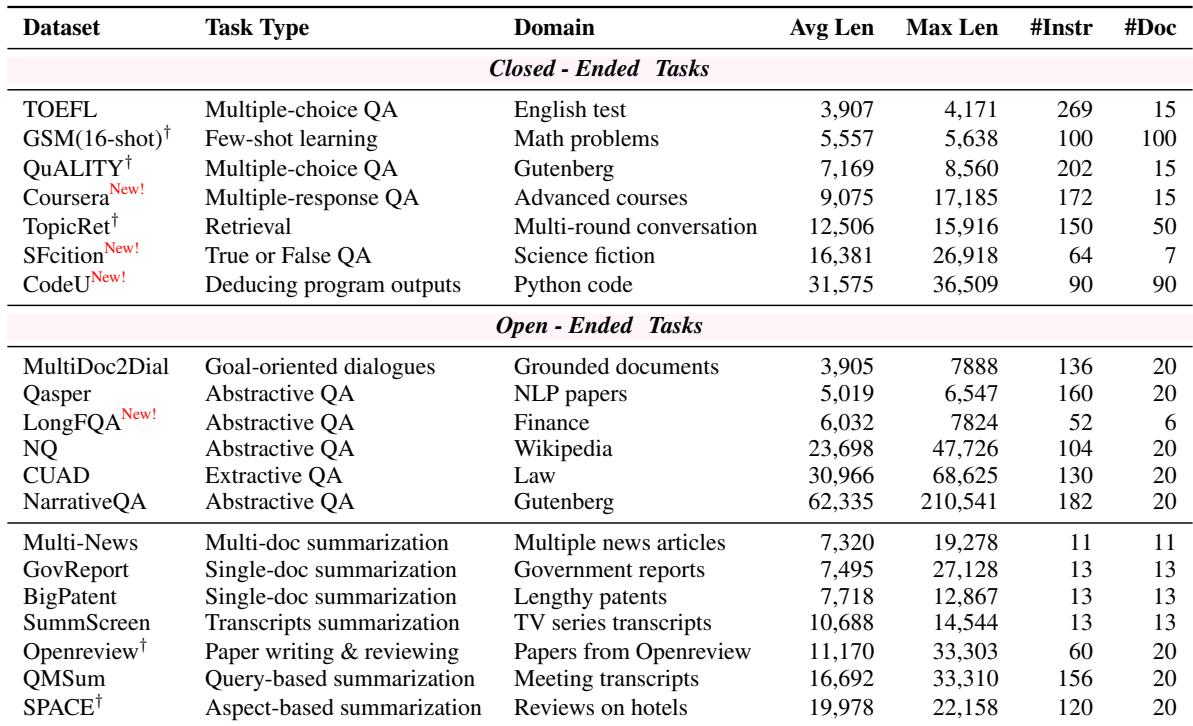
该表将 L-Eval 描述为一个长上下文评测套件,具有多样任务类型、领域、指令数量、文档数量和输入长度。它结合封闭式和开放式任务,以支持对长上下文语言模型进行更客观、更灵活的评测。多样化长度和新添加任务提升了对真实长提示场景的覆盖。任务类型包括选择题 QA、True/False QA、少样本学习、检索、代码理解、对话、抽取式 QA、生成式 QA 和摘要。输入覆盖多个领域和长度,从中等长度样本到非常长文档,使该套件比短提示基准具有更广的真实性。
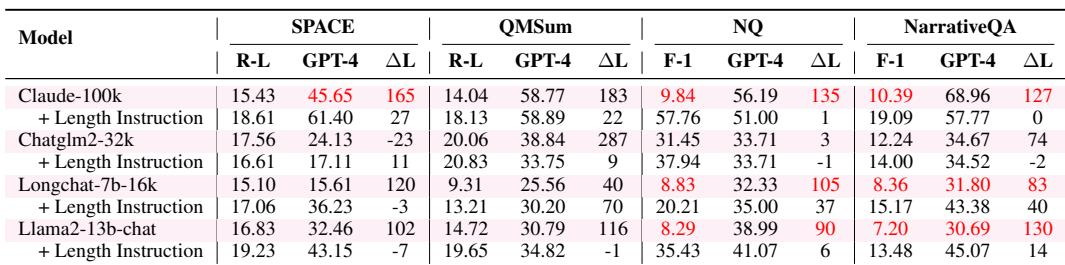
在四个长上下文数据集上,生成答案长度与参考答案长度之间的巨大差异会严重损害性能。一些模型得分低,主要是因为其输出远长于或短于预期,而不一定是因为内容错误。显式长度控制有助于减少这种偏差,并使评测更可靠。与参考答案的长度不匹配是得分低的一个主要原因。引导模型达到目标答案长度会提高评测稳定性。
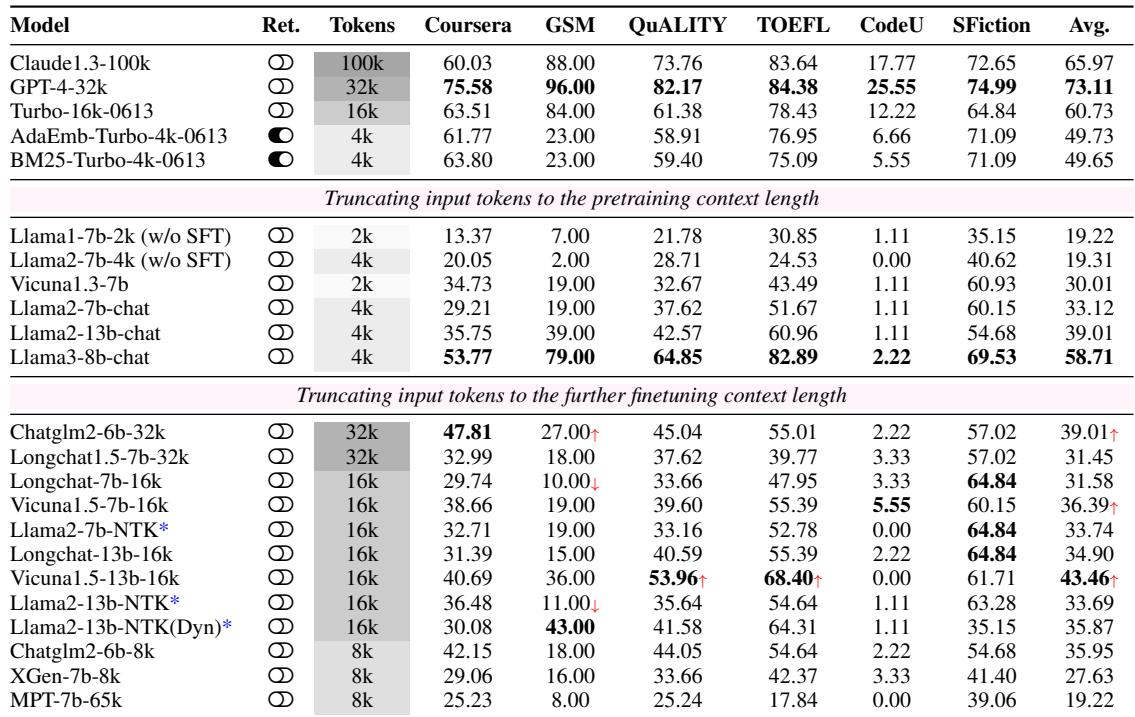
封闭式结果显示了长上下文模型之间清晰层级。GPT-4-32k 达到最强总体性能,而 100k 模型具有竞争力但平均分较低。使用较短 4k 上下文的基于检索方法落后于完整 16k 对应模型,而截断为 2k 的基线表现很差。GPT-4-32k 在所比较模型中建立了最强封闭式基准。编码完整 16k 上下文比 4k 检索流水线更有效。使用缩放位置嵌入和更长微调的模型提升了封闭式任务分数。
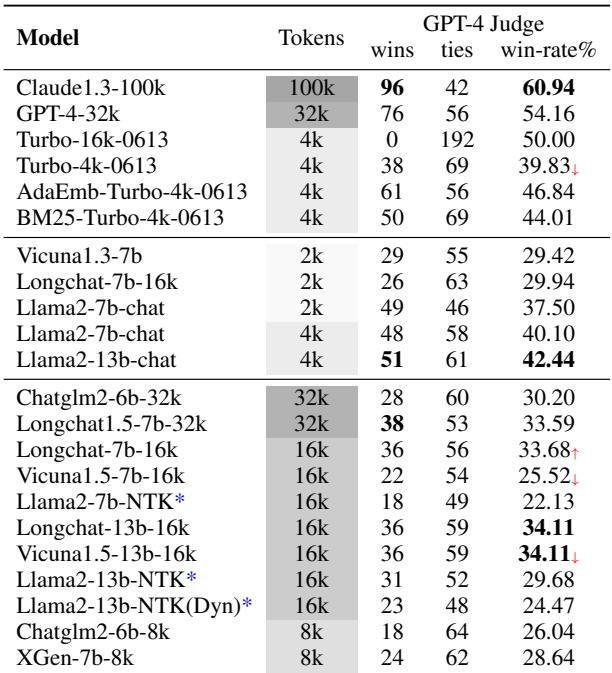
在由 GPT-4 判断的开放式任务上,Claude-1.3-100k 表现最强,其次是 GPT-4-32k 和完整上下文 Turbo-16k。基于 Turbo-4k 的检索方法优于普通 Turbo-4k 基线,但仍落后于处理完整上下文的模型,这表明长文本生成需要不止简单检索。结果还表明,使用缩放上下文技术的开源模型尽管在封闭式任务上有所提升,但在有挑战性的开放式生成上仍然落后。Claude-1.3-100k 具有最高胜率,超过 GPT-4-32k 和 Turbo 基线。检索增强 Turbo-4k 变体超过普通 Turbo-4k,但不及完整上下文 Turbo-16k。使用缩放上下文技术的开源模型在开放式生成上并不能可靠超过 GPT-3.5 或 Turbo。
实验评估了 L-Eval,这是一个跨越许多任务类型、领域和输入长度的多样化长上下文套件,发现答案长度不匹配会扭曲分数,因此显式长度控制对于可靠评测很重要。封闭式结果显示 GPT-4-32k 总体最强,完整上下文处理、缩放位置嵌入和更长微调优于 4k 检索或截断基线。开放式结果偏好 Claude-1.3-100k,其次是 GPT-4-32k 和 Turbo-16k,表明检索有帮助,但完整上下文模型在困难的长文本生成上仍然更强。