Command Palette
Search for a command to run...
量化侧微调:量化大语言模型的快速内存高效微调
量化侧微调:量化大语言模型的快速内存高效微调
Zhengxin Zhang Dan Zhao Xupeng Miao Gabriele Oliaro Zhihao Zhang Qing Li Yong Jiang Zhihao Jia
摘要
微调大语言模型(LLM)在多种下游任务上已被证明行之有效。现有的 LLM 微调方法要么聚焦于参数高效微调,即仅更新少量可训练参数;要么致力于减少微调训练阶段的内存占用。通常,微调期间的内存占用来源于三方面:模型权重、优化器状态以及中间激活值。然而,现有方法仍需大量内存,且无一能够同时缓解这三个来源的内存开销。本文提出量化侧微调(QST),通过双阶段流程实现内存高效且快速的 LLM 微调。首先,QST 将 LLM 的模型权重量化至 4-bit 以降低原始权重的内存占用。其次,QST 引入一个与 LLM 分离的侧网络,利用 LLM 的隐藏状态进行任务特定的预测。采用独立的侧网络避免了对 LLM 进行反向传播,从而降低了中间激活值的内存需求。最后,QST 结合多个低秩适配器和免梯度降采样模块,显著减少可训练参数量,以节省优化器状态的内存开销。实验表明,QST 最多可将总内存占用降低至原来的 1/2.3,并将微调速度提升最高 3 倍,同时在与最先进方法对比中达到相当的性能。在全量微调场景下,QST 最多可将总内存占用降低至原来的 1/7。
一句话总结
由卡内基梅隆大学、清华大学及其他机构的研究者提出的量化旁路微调(Quantized Side Tuning,QST)将 4-bit 权重量化与独立旁路网络相结合,避免通过 LLM 进行反向传播,从而将三类内存开销来源(模型权重、优化器状态和中间激活值)最多降低 2.3×,并使微调速度最多提升 3×。
核心贡献
-
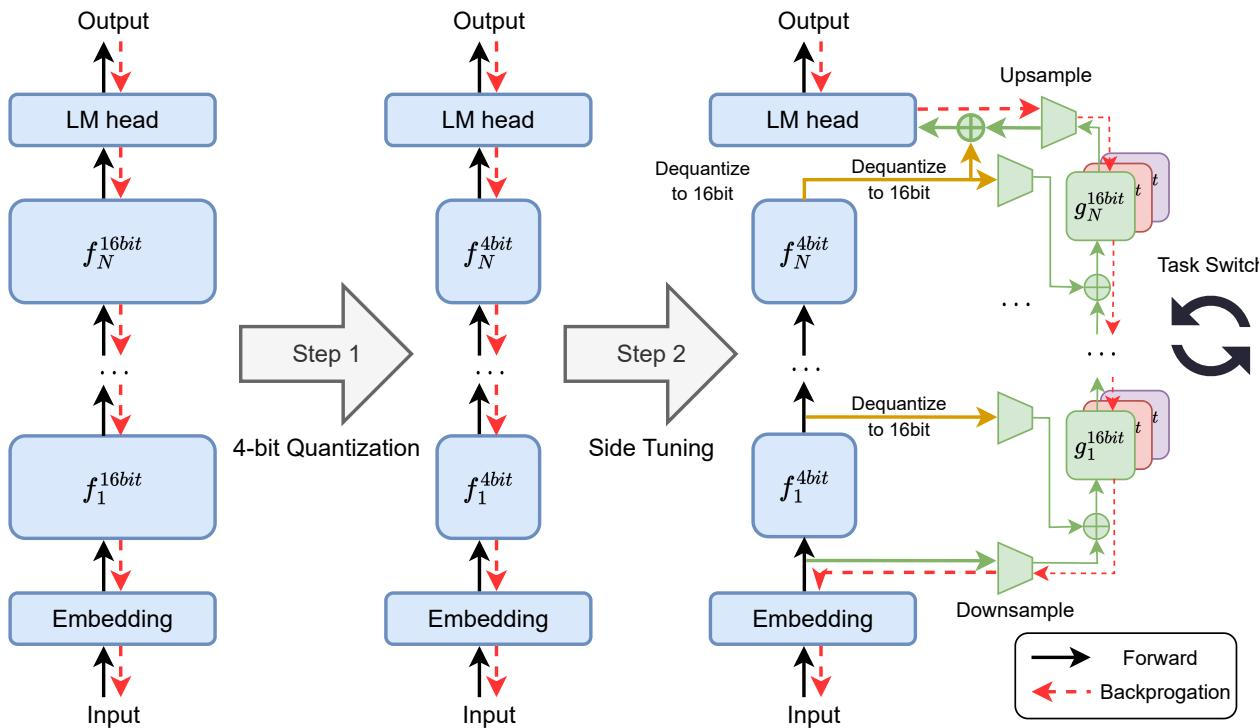
QST 提供一个内存高效的 LLM 微调框架,将 LLM 权重量化为 4-bit,并在 LLM 隐藏状态上训练一个独立旁路网络,从而降低权重内存,并避免通过 LLM 的反向传播以降低激活内存。
-
QST 进一步通过使用低秩适配器和免梯度降采样模块来减少任务特定适配所需的可训练参数,从而降低优化器状态内存。
-
实验显示,QST 将总微调内存最多降低 2.3×,微调速度最多提升 3×,同时取得与当前最优方法相当的性能;与全量微调相比,总内存最多降低 7×。
引言
大型语言模型正越来越多地适配到专业应用,但微调超大模型会消耗大量内存,全量微调有时需要数百 GB 内存。现有参数高效微调方法可以减少可训练参数,但它们往往仍需存储大部分中间激活值用于反向传播;而 QLoRA 等方法虽然能减少权重和优化器内存,但未能充分解决激活内存问题,尤其是在更大的批量大小下。此前的旁路网络方法也难以扩展到非常大的模型,因为基础 LLM 仍占用大量内存。作者提出量化旁路微调(Quantized Side Tuning),将 LLM 量化为 4-bit,并训练一个独立旁路网络,该网络使用来自 LLM 的降采样隐藏状态,从而在减少权重、激活和优化器内存的同时,加速微调并保持有竞争力的性能。
方法
作者围绕两个耦合机制构建量化旁路微调:以低比特存储预训练语言模型权重,以及一个并行可训练旁路网络,用于恢复量化造成的精度损失。在第一机制中,原始 16-bit 权重被映射到 4-bit dtype。对于张量 X16bit,作者计算
X^4bit=round(Absmax(X16bit)M4bitX16bit)=round(c16bit⋅X16bit),其中 X^4bit 是量化后的张量,M4bit 是 4-bit dtype 的最大可表示值,c16bit 是量化尺度。该方法支持 NF4 和 FP4,其中 NF4 被视为一种基于信息论动机的 dtype,它平衡每个量化 bin 所分配的数值数量。随后,反量化定义为
dequant(c16bit,X^4bit)=c16bitX^4bit≈X16bit.在这种标量尺度公式中,一个主要误差来源是离群值,它们会拉大尺度,导致许多量化 bin 未被充分利用。为缓解这一问题,作者将 X∈Rb×h 重塑为一维数组,并将其划分为
n=Bb×h连续块,每个块的大小为 B。每个块使用各自的尺度独立量化,从而提升对离群值的鲁棒性。由于存储许多尺度会带来额外内存开销,量化尺度本身也使用 8-bit 浮点格式存储。因此,对于线性层,前向计算使用反量化后的权重:
Y16bit=dequant(dequant(c216bit,c18bit),W4bit)X16bit.这一设计使基础语言模型保持 4-bit 内存,同时在前向传播过程中仍使用 16-bit 计算,从而减少权重存储并提升现代加速器上的执行效率。
为解释为什么需要旁路网络,作者将训练内存分解为三个主要组成部分。M1 是 LLM 的权重内存,M2 是优化器状态,对于 Adam 通常是可训练参数大小的数倍,M3 是反向传播期间中间激活值占用的内存。量化权重可减少 M1,但如果梯度仍然通过完整 LLM 计算图流动,激活内存 M3 可能仍然很大。引入旁路网络以降低这三个组成部分。
下文所示为量化 LLM 分支与可训练旁路分支之间的逐层连接。
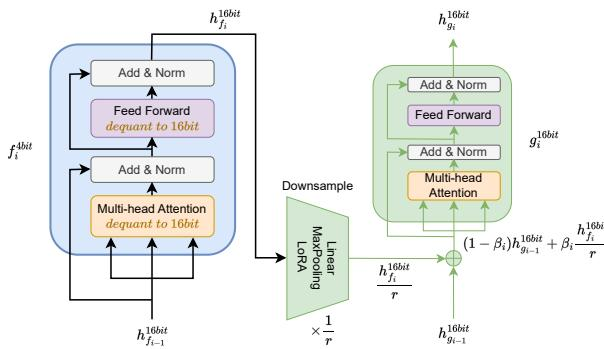
旁路网络 g 是量化 LLM f 的轻量版本。其隐藏状态维度和权重维度均比 f 缩小 r 倍。在第 i 层,旁路隐藏状态根据量化 LLM 的隐藏状态计算为
hgi16bit=(1−βi)downsamplei(hfi16bit)+βihgi−116bit,其中
βi=sigmoid(γi)且 γi 是一个可学习且零初始化的标量。门控 βi 控制从量化 LLM 的降采样输出以及上一旁路网络状态中分别获取多少信息。对于第一层,embedding 层和降采样 embedding 层的输出分别初始化 hf016bit 和 hg016bit。
降采样模块将 f 的高维隐藏状态降为 g 的低维隐藏状态。直接线性投影需要过多可训练参数,尤其是当 LLM 具有许多层且隐藏维度很大时。因此作者使用参数高效或无参数的降采样替代方案。LoRA 使用分解投影替换完整投影,
W=L1L2,其中 W∈Rdin×dout,L1∈Rdin×dr,且 L2∈Rdr×dout。Adapter 类似,但会在 L1 与 L2 之间添加非线性函数。MaxPooling 和 AvgPooling 不引入额外可训练参数。在这些选择中,基于 Adapter 的降采样在其经验分析中表现最佳。
旁路网络产生最终隐藏状态后,QST 将旁路输出对齐到完整 LLM 输出维度,并将其与量化 LLM 的最后一层隐藏状态结合。发送到语言建模头的最终表示为
hN16bit=αhfN16bit+(1−α)hgN16bit,其中 α 是初始化为 1 的可学习参数。该初始化在微调开始时保留预训练模型的起点。由于预训练 LLM 仍固定为 4-bit 张量,任务适配可通过仅更新旁路网络实现,而不必重新部署完整模型。
在训练过程中,作者仅更新旁路网络 g 的参数。损失关于 g 的梯度在不显式微分 f 中量化骨干权重的情况下计算。换言之,该方法避免通过冻结 LLM 的 4-bit 权重存储路径进行反向传播。这减少了可训练参数数量,缩小了优化器状态,并限制了与完整骨干反向传播相关的激活内存。
实验
实验在小型到大型 OPT 和 LLaMA-2 模型上评估 QST,任务包括 GLUE、MMLU 和聊天机器人生成,并与 QLoRA、LST、LoRA 和 Adapter 进行比较。结果显示,QST 在保持有竞争力准确率的同时显著降低内存使用和可训练参数量,在更大模型和 MMLU 上相较 QLoRA 有一些收益。进一步分析表明,QST 在批量大小、序列长度和模型规模上保持稳健,训练更快,并得益于精心选择的缩减比例、NF4 量化以及基于 Adapter 的降采样。在由 GPT-4 评判的 MT-Bench 聊天机器人任务上,QST 相较 QLoRA 提升了训练效率和最终回答质量,包括超过原始 LLaMA-2-70B。
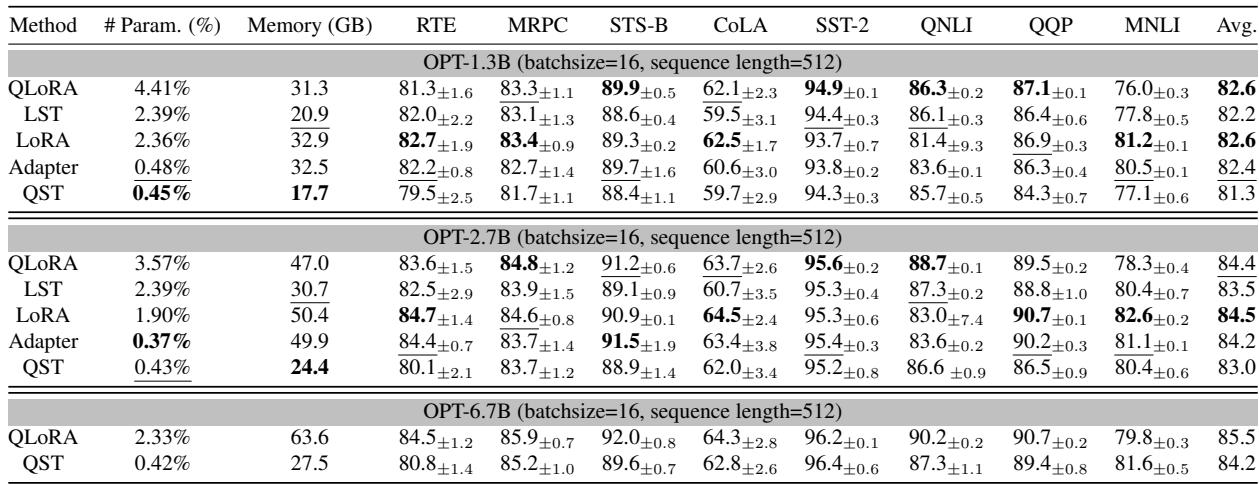
在 GLUE 基准上,QST 具有最低内存占用和极少可训练参数,同时仍接近内存占用较高但更强的方法的平均准确率。对于更大的 OPT 模型,QST 相比 QLoRA 提供更优的准确率与效率权衡,在降低内存和可训练参数量的同时,平均准确率仅小幅下降。该方法在不同计算数据类型上也比 QLoRA 更稳定,而 QLoRA 在 FP16 下可能在某些 GLUE 数据集上失败。相比 QLoRA、LST、LoRA 和 Adapter,QST 在使用更少内存和更少可训练参数的同时保持有竞争力的准确率。对于更大的 OPT 模型,QST 相比 QLoRA 提供更优的准确率与内存权衡,仅带来很小的平均准确率损失。QST 在 BF16 和 FP16 计算设置下保持稳定,而 QLoRA 可能无法微调某些 GLUE 数据集。
在 MMLU 5-shot 微调结果中,QST 相比 QLoRA 匹配或略提升准确率,同时在所测试的 OPT 和 LLaMA-2 模型上使用显著更少内存。整体准确率差异通常较小,QST 在 LLaMA-2-13B 上获得最明显收益,在若干 OPT 模型上有适度提升。相对于 QLoRA,QST 在 OPT 和 LLaMA-2 模型规模范围内降低内存占用。QST 保持有竞争力的 MMLU 准确率,其在 LLaMA-2-13B 上展现最强的相对准确率提升。

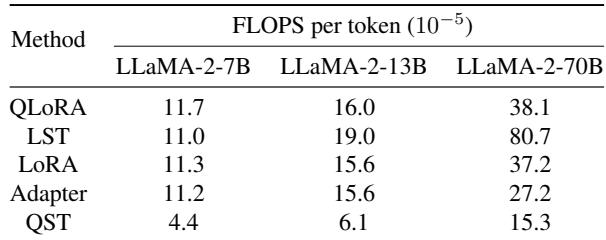
所报告的训练吞吐量结果显示,随着模型规模从 7B 增长到 70B,每种方法每个 token 的计算成本都会增加。QST 始终实现最低的每个 token 成本,并相对基线方法提供约 2.5 倍加速。LST 成本最高,尤其是在更大模型规模下;QLoRA 因包含额外 LoRA 组件而比 LoRA 和 Adapter 略贵。QST 在所有测试模型规模上提供最佳训练吞吐量。LST 吞吐量最差,并在最大模型上尤其昂贵。添加更多 LoRA 组件会使 QLoRA 比 LoRA 和 Adapter 略不高效。
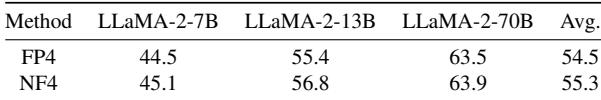
在 LLaMA-2 模型上的实验比较了用于 MMLU 基准上 4-bit 微调的 FP4 与 NF4。NF4 在不同模型规模上一致地取得略高于 FP4 的准确率,并被选为默认 4-bit 数据类型。对于 7B、13B 和 70B LLaMA-2 模型,NF4 相比 FP4 提升准确率。NF4 相比 FP4 的平均收益很小,但足够一致,足以促使其成为默认选择。
在 FP16 计算下,QST 保持稳定,并在 MRPC 和 QNLI 上取得显著高于 QLoRA 的分数。比较还表明,QLoRA 在 FP16 下可能不稳定,包括在某些任务上的微调失败。QST 在 FP16 下始终表现良好,并在报告任务上优于 QLoRA。QLoRA 在 FP16 下鲁棒性降低,分数显著更低,并报告存在微调不稳定现象。
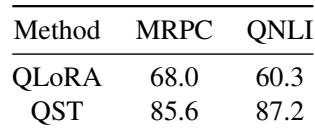
QST 在 GLUE 和 MMLU 基准上被评估,并与 QLoRA、LST、LoRA 和 Adapter 进行比较,以评估其准确率、内存效率和稳定性。结果显示,QST 使用显著更少内存和可训练参数,同时保持有竞争力准确率,并在各模型规模上提供最佳训练吞吐量,相对基线方法约 2.5 倍加速。额外实验支持将 NF4 而非 FP4 作为默认 4-bit 格式,并显示 QST 在 FP16 计算下比 QLoRA 更稳健,而 QLoRA 可能变得不稳定或失败。