Command Palette
Search for a command to run...
分布相似性度量
分布相似性度量
Lillian Lee
摘要
我们研究分布相似性度量,旨在改善未见共现词对的概率估计。我们的贡献有三方面:对广泛范围的度量进行了实证比较;基于所纳入的信息对相似性函数进行了分类;以及引入了一种在评估潜在代理分布方面表现更优的新函数。
一句话总结
这项工作对分布式相似度度量进行了经验比较,基于这些函数所纳入的信息对其进行分类,并提出了一种新的函数,能够更好评估潜在代理分布,以改进未见共现的概率估计。
核心贡献
-
论文比较了多种分布式相似度度量,以通过距离加权平均估计未见共现的概率,并使用一种排除不必要自由度的无参数评估方法。
-
论文根据相似度函数所纳入的信息对其进行分类,结果表明,性能分组与这些函数对两个被比较分布支撑集交集的强调程度相对应。
-
论文引入了偏斜散度,这是一种纳入支撑集交集数据的非对称信息论度量;它取得了最佳的整体性能,在 0.01 显著性水平下,相对于 Jensen-Shannon 散度将平均错误率降低了 4%。
引言
统计自然语言处理通常依赖有限语料库,因此合理但未见的词对可能被赋予零概率,这对语言建模和平滑处理非常重要。Katz backoff 和 Jelinek and Mercer interpolation 等现有方法通常根据边际计数估计未见条件概率,实际上忽略了条件上下文的身份。作者以距离加权平均为基础,从分布式相似的词借用估计值,并探讨相似度度量是否真正重要这一不确定性。其主要贡献包括:对相似度度量的经验比较、根据函数如何处理支撑集交集提出的分类方式,以及一种纳入这一洞见并改进未见共现预测的新度量:偏斜散度。
数据集
-
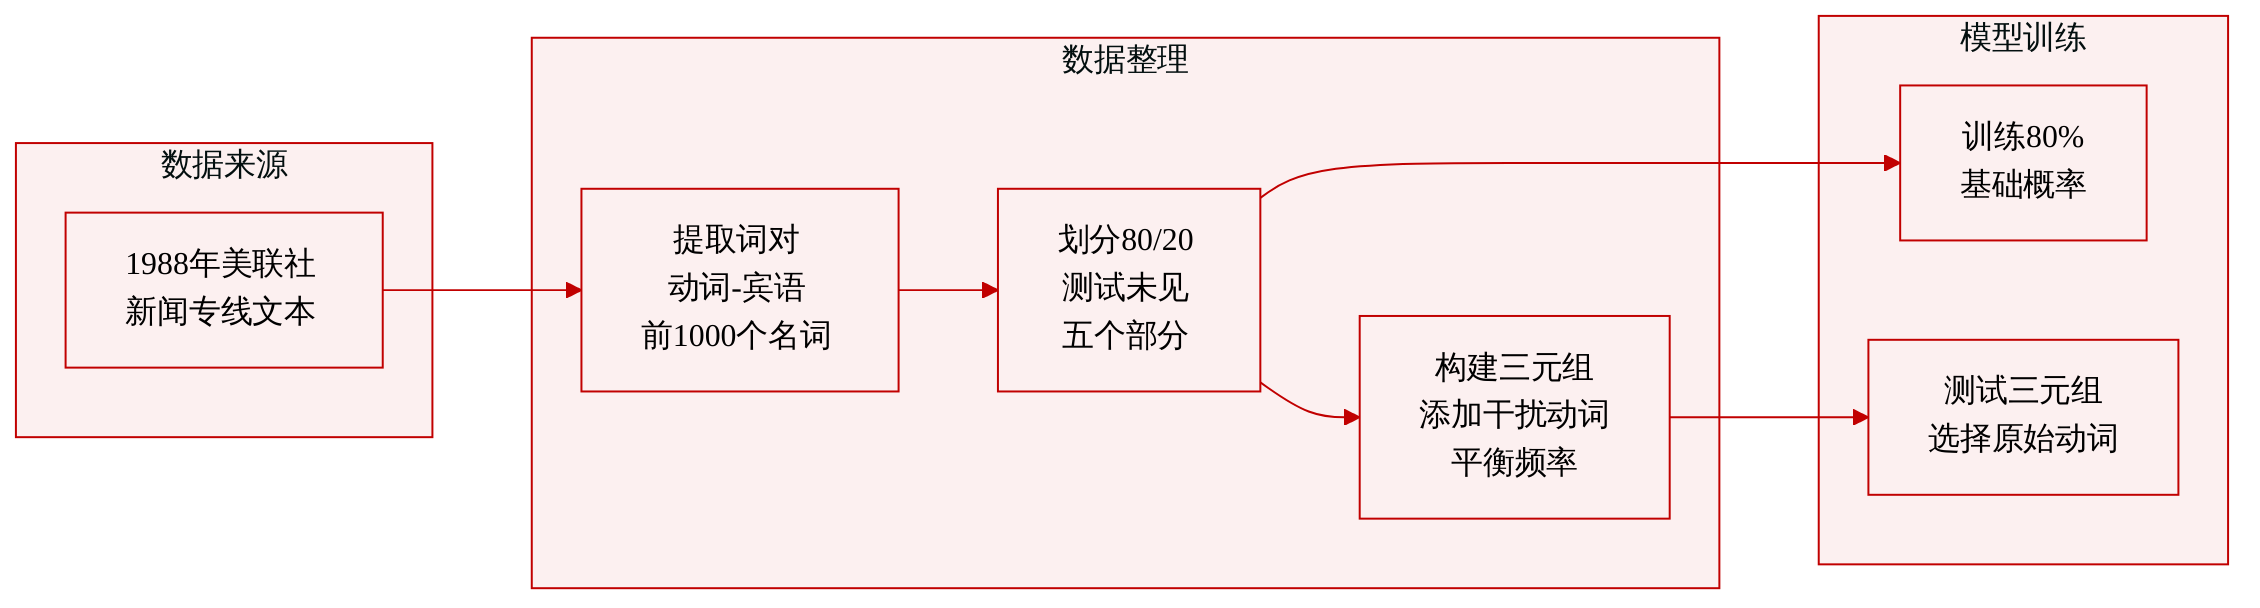
作者使用了一个词汇语义数据集,该数据集由从 1988 年美联社新闻稿中提取的动宾共现对构建而成。
-
这些词对仅限于 1000 个最高频名词,并使用 Church 和 Yarowsky 的处理工具提取。
-
数据集划分为 80% 训练集和 20% 留出测试集。
-
训练集包含 587,833 个词对,用于计算基础共现概率。
-
剩余 20% 构成评估数据。在测试前,会剔除任何同样出现在训练集中的词对,从而确保测试项是未见词对。
-
留出词对随后被划分为五个分区。
-
在评估中,每个测试词对被转换为名词-动词-动词三元组。名词-动词对
(n, v1)被扩展为(n, v1, v2),其中v2的选择使其一元组概率接近v1的一元组概率。 -
原始共现始终被视为正确选项,而添加的干扰动词经过平衡处理,以避免利用简单的频率捷径。
-
因此,该格式以名词-动词共现为中心,测试示例表示为形如
(noun, original verb, distractor verb)的三元组。 -
该数据用于在一个二元选择任务上评估相似度函数:判断两个动词候选项中哪一个是原始共现。
-
文中未提及裁剪、元数据构建或多模态处理;主要处理流程包括词对提取、基于频率的筛选、训练/测试集划分、从测试集中去除重复项,以及构造平衡的干扰三元组。
方法
作者采用一种分布式相似度框架,其中候选词对通过比较其经验上下文分布进行评分。为了具体说明,他们将该方法实例化到名词和及物动词构成的词对上。当一个名词作为动词直接宾语的头部名词出现时,记录一次共现事件。给定概率函数为 P 的基础语言模型,作者将名词的动词上下文条件分布定义为 q(v)=P(v∣n)。对于另一个名词 m,其对应分布是 r(v)=P(v∣m)。在实现中,P 由语料计数计算得到的未平滑相对频率推导而来。由此得到的向量 q 和 r 分别表示两个名词的动词上下文画像,任务则转变为衡量这些画像之间的相似度或相互可替换程度。
初始相似度模块评估了几种成熟的分布式关联函数。欧氏距离和 L1 距离函数直接比较概率值:
L2(q,r)=v∑(q(v)−r(v))2 L1(q,r)=v∑∣q(v)−r(v)∣余弦相似度衡量两个分布之间的方向一致性:
cos(q,r)=∑vq(v)2∑vr(v)2∑vq(v)r(v)Jaccard 系数更具组合性。它仅依赖于 q、r 及其交集的支撑集:
Jac(q,r)=∣{v:q(v)>0 or r(v)>0}∣∣{v:q(v)>0 and r(v)>0}∣Jensen-Shannon 散度通过一个平均分布定义:
avgq,r(v)=2q(v)+r(v) JS(q,r)=21[D(qavgq,r)+D(ravgq,r)]其中 KL 散度为
D(p1∥p2)=v∑p1(v)logp2(v)p1(v).使用平均分布可以确保,即使一个分布的支撑集不包含另一个分布的支撑集,Jensen-Shannon 散度仍然是良好定义的。
该框架还包括混淆概率,除了两个条件分布之外,它还纳入一元组上下文概率。它衡量一个名词能够在多大程度上被替换到与另一个名词相关的上下文中:
conf(q,r,P(m))=v∑q(v)r(v)P(v)P(m).另一个候选项是 Kendall 的 τ,这是一种非参数度量,用于评估 q 和 r 在动词上诱导出的排序之间的相关性。使用最简单的变体,
τ(q,r)=v1,v2∑2(2∣V∣)sign[(q(v1)−q(v2))(r(v1)−r(v2))].接近 1 的值表明两个名词诱导出的动词排序相似,而接近 −1 的值表明排序强烈对立。该方法将 −1 视为强烈不相似的证据。
一个关键方法洞见是,词汇可替换性常常是不对称的。例如,一个词可能为另一个词提供很强的近似,而反向替换可能较差。框架中比较的大多数候选函数都是对称的,即 f(q,r)=f(r,q)。为了捕捉方向性可替换性,作者引入了一种非对称散度,称为 α-偏斜散度:
sα(q,r)=D(r∥α⋅q+(1−α)⋅r),其中 0≤α≤1。该公式推广了 KL 散度。当 α=1 时,偏斜散度恰好成为 KL 散度 D(r∣∣q)。参数 α 可以被解释为对分布 q 的信心水平。等价地,1−α 控制通过混合 q 与 r 施加多少平滑。该设计在稀疏场景中很有用,因为在支撑集条件不满足时,直接计算 KL 散度可能不稳定或未定义。
当 α=1/2 时,偏斜散度与 Jensen-Shannon 散度中的两项之一相关,但它仍然保持非对称性。因此,该方法保留了可替换性的方向性,同时避免了原始 KL 散度的部分不稳定性。
如下方的图所示:
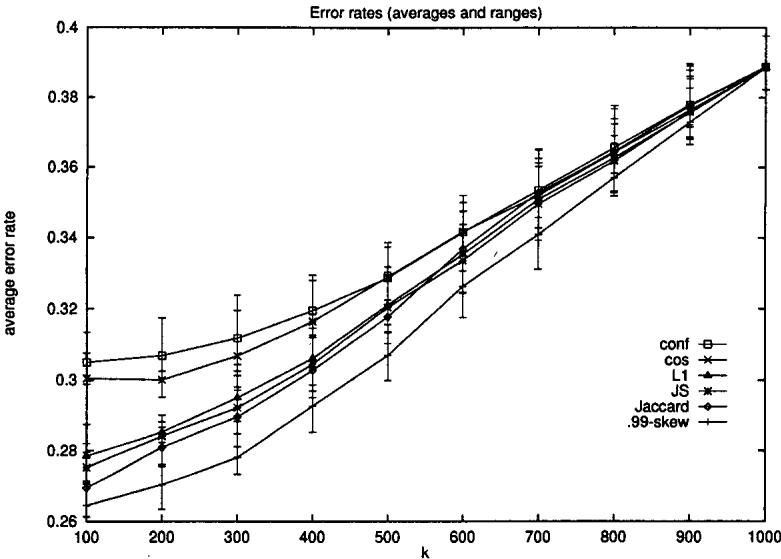
绘制的性能曲线比较了 α=0.99 的偏斜散度与其他相似度函数在参数 k 变化时的表现。在许多设置中,偏斜散度的平均错误率更低,这表明非对称公式在名词替换中提供了更强的排序行为。该比较说明了该方法的核心设计选择:最终评分组件不是仅依赖对称接近度量,而是使用一种平滑的非对称散度,强调一个词分布能够近似另一个词分布的方向。
实验
实验在未见的名词-动词共现的二元选择任务中比较分布式相似度度量,随后在同一框架内评估所提出的非对称偏斜散度。经验比较表明,强调共享共现证据的度量在排序最近邻方面通常比那些对非共享或超出支撑集的动词敏感的度量更有效,同时所有比较度量均优于简单回退基线。偏斜散度验证表明,非对称性和选择性平滑能够改进预测排序,支持如下结论:对于稀疏语言数据,相似度度量受益于关注分布支撑集的交集。
在针对未见动宾证据的经验评估中,采用接近 1 的权重的偏斜散度在二元选择任务上优于其他比较的相似度函数。表现最强的函数似乎是那些强调共享动词支撑集的函数,而来自仅与一个名词共现的动词的负证据似乎不那么重要。偏斜散度在名词-动词-动词预测任务上优于其他列出的相似度度量。更好的性能与关注支撑集交集而非非共享动词证据相关。
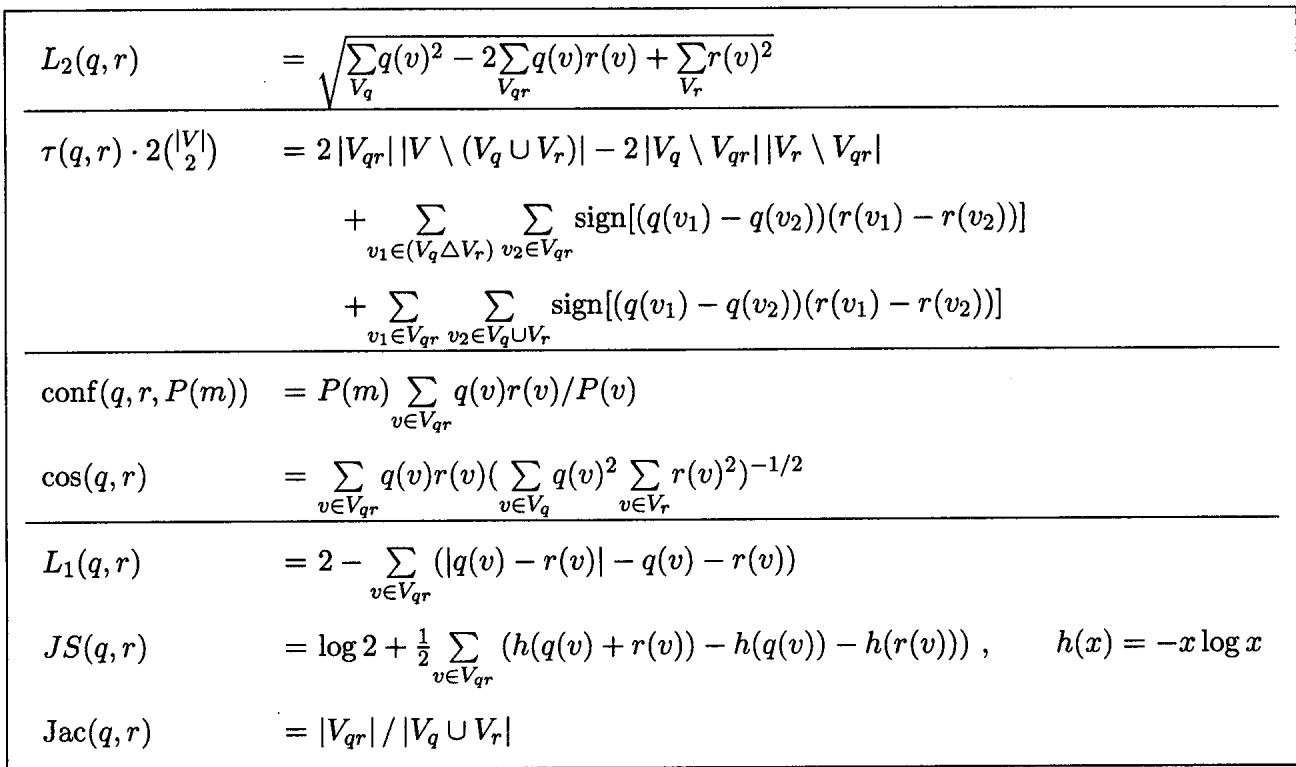
实验使用二元选择和名词-动词-动词预测任务,在未见动宾证据上比较相似度函数。采用接近 1 的权重的偏斜散度取得最强结果,表明衡量共享动词支撑集比权衡非共享或负证据更有效。总体而言,强调支撑集交集的方法优于更依赖仅与单个名词共现的动词的方法。