Command Palette
Search for a command to run...
动态系统的因果结构学习与理论分数分析
动态系统的因果结构学习与理论分数分析
Nicholas Tagliapietra Katharina Ensinger Christoph Zimmer Osman Mian
摘要
现实世界的系统根据其潜在的因果关系在连续时间内演化,但其动态往往是未知的。现有的学习此类动态的方法通常要么对时间进行离散化——导致在非规则采样数据上性能较差——要么忽略了潜在的因果性。我们提出了 CADYT,一种针对动态系统因果发现的新颖方法,同时解决这两个挑战。与最先进的因果发现方法使用离散时间动态贝叶斯网络建模该问题不同,我们的公式基于差分因果模型,该模型允许对系统的连续性质进行更温和的假设。CADYT 利用精确的高斯过程推断来建模连续时间动态,这更符合潜在的动态过程。我们提出了一种实用的实例化方法,通过由算法马尔可夫条件和最小描述长度原则指导的贪婪搜索来识别因果结构。我们的实验表明,CADYT 在规则和非规则采样数据上均优于最先进的方法,发现的因果网络更接近真实的潜在动态。
一句话总结
来自博世人工智能中心、达姆施塔特工业大学、曼海姆巴登-符腾堡州合作州立大学和 IKIM 的研究人员提出了 CADYT,一种面向动力系统的因果发现方法。该方法利用基于差分的因果模型和精确高斯过程推断,在规则和不规则采样的数据上都优于离散时间动态贝叶斯网络方法,通过由算法马尔可夫条件和最小描述长度原理引导的贪心搜索,识别出更接近真实底层动力学的因果结构。
核心贡献
- CADYT 是一种面向连续时间动力系统的因果发现方法,使用基于差分的因果模型而非离散时间动态贝叶斯网络来建模问题,从而对系统的连续特性做出更温和的假设。
- CADYT 将连续时间动力学的精确高斯过程推断与由算法马尔可夫条件和最小描述长度原理引导的贪心结构搜索相结合;其得分被证明是有效的正则化对数似然得分,具有与 BIC 类似的渐近上界。
- 实验表明,CADYT 在规则和不规则采样的轨迹数据上都优于最先进的因果发现方法,恢复出的因果网络更接近真实底层动力学。
引言
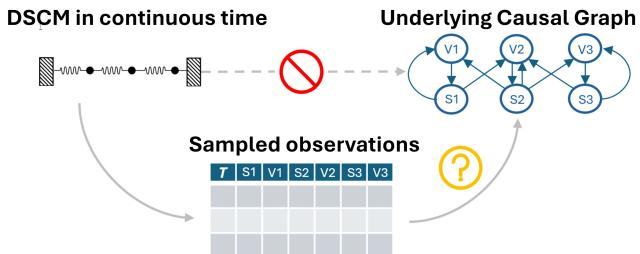
现实世界中的物理系统通过带有内在因果机制的连续时间动力学演化,但从数据中学习这些动力学却是一个重大挑战。在质量-弹簧网络等系统中,每个质量的位置因果性地影响相连质量的速度,这凸显了在因果关系中建模方向性以实现物理上合理预测的必要性。虽然微分方程是这类系统的标准数学工具,但从观测数据中推断微分方程仍然困难,而神经网络或高斯过程等数据驱动方法无法保证学习到的动力学尊重真实因果关系,往往反而吸收了虚假相关性。
已有的工作在两个互补方面存在不足。最先进的时间序列因果发现方法通常只能恢复离散时间的因果结构,假设轨迹是规则采样的,并且无法处理不规则采样数据。相反,连续时间动力系统模型可以适应不规则采样,但完全忽略因果关系,无法提供因果泛化的保证。这两个挑战,即因果结构识别和连续时间建模,以往只被各自独立地解决。
作者同时解决这两个问题。他们提出了 CADYT,一个面向连续时间动力系统的因果发现框架,在放松规则采样假设的同时恢复真实因果结构。该方法建立在动态结构因果模型之上,利用基于高斯过程的推断方案实现精确的连续时间建模,即使在不规则采样下也能工作。为了识别因果父节点,作者引入了一种基于算法马尔可夫条件的新得分,该得分以柯尔莫哥洛夫复杂度最简单描述的方式选择原因变量。由于柯尔莫哥洛夫复杂度不可计算,作者通过最小描述长度原理对其进行上界估计,并通过结构搜索最小化所得得分,最终得到一个同时学习动力学和底层因果图的端到端算法。
方法
作者提出了一种基于得分的因果发现方法,用于多元连续值动力系统,基于动态结构因果模型(DSCM)框架。在动力学稳定性假设下,常微分方程组可以分解为逐分量的结构方程,其中每个效应变量是其直接原因的函数。目标是从轨迹数据中识别底层有向图并学习动力学。为此,他们设计了一个最小描述长度(MDL)得分,在模型复杂度与数据拟合之间进行权衡,并使用加性噪声模型进行实例化,其中每个观测分量是确定性动力学项与独立高斯噪声之和。
候选模型 M 的总描述长度定义为
L(T,M)=L(M)+i=1∑DL(Xi[t1:tN]∣Pai,Fi),其中 L(M) 编码模型结构和参数,第二个和项衡量每个分量在其因果父节点和学习到的结构方程下的压缩程度。在加性噪声假设下,这简化为对残差噪声 νi 的编码,因为确定性部分已被模型捕获。
模型代价 L(M) 分为全局部分和每个变量的局部代价之和。全局代价 Lglobal(M) 存储轨迹的初始 s 个样本和积分器步长 s,对 s 需要 logN 比特,每个样本有固定的代价。对于每个变量 Xi,局部模型 Mi 存储其父节点 Pai 和结构方程 Fi 的参数。存储父节点集合的代价为
L(Mi)=LN(∥Pai∥)+∥Pai∥logD+LF(Fi),其中 LN 是非负整数的 MDL 最优编码,LF(Fi) 是描述动力学函数的代价。
为了编码函数 Fi,作者使用基于多步积分器的高斯过程回归方案。这一选择基于两个因素:GP 为常微分方程提供了自然的连续模型,并且能很好地处理不规则采样的轨迹;其非参数特性避免了对参数形式的假设。对于每个变量,GP 以其父节点的轨迹为条件,得到动力学函数的后验分布。GP 使用的核由多步积分器系数导出,从而允许精确推断。形式上,估计的动力学函数满足
Fi(Xit⋆∣Pai[t1:t⋆))∼N(μpost(Xit⋆),Σpost(Xit⋆)),由此可以通过数值积分预测轨迹。代价 LF(Fi) 由核矩阵及其参数的复杂度决定。核矩阵通过奇异值分解存储,旋转角度量化为预定义的精度。长度尺度和方差使用 Marx 和 Vreeken 的参数编码方案进行编码,该方案考虑每个参数的符号、量级和精度。
模型拟合后的残差噪声被编码为零均值高斯噪声。给定经验方差估计 σ^i2,每个噪声序列的编码长度为
L(νi)=2N(ln21+log2πσ^i2),这遵循高斯残差的最优编码。这一项奖励能解释数据中大部分方差的模型,因为残差越小的模型产生越短的描述。
作者为其得分提供了理论保证。在另外两个假设下,即核是有限维的且超参数和精度值有界,他们证明了总得分渐近地以类似于贝叶斯信息准则的正则化对数似然得分为上界。证明依赖于特征值编码代价随轨迹点数亚线性增长的结论。这一结果确立了最小化 MDL 得分等价于通过有效的惩罚似然准则进行模型选择。
由于对所有可能的图进行穷举搜索是不可行的,作者将得分纳入一个贪心的三步搜索过程。第一步,边排序,对每个可能的有向边 Xi→Xj 计算增益 Γij,即添加该边前后描述长度的差异。构建一个按增益递减排序的边优先级队列。前向搜索然后迭代地添加得分最高的边,更新受影响节点的所有入边得分。每条边使用无超压缩不等式检验统计显著性,直到无法获得进一步改进为止。随后的后向阶段删除任何删除后能改善得分的边。最终输出是学习到的因果图。整体计算复杂度为 O(N3D3logD),主要由高斯过程回归主导,但算法设计为可并行化,使典型动力系统的运行时间保持可控。
实验
评估将 CADYT 与基于约束、得分和噪声的基线方法在不同规模、环性和采样规则性的合成动力系统上进行比较,使用结构距离和边置信度指标。在所有设置中,CADYT 始终优于基线方法,保持高精确率并避免虚假边,而高阶积分器提高了鲁棒性,尤其是在不规则时间线和环性动力学上。在振荡器和混沌系统上的实验证实,CADYT 比竞争方法更准确、更高置信度地恢复因果结构。
CADYT 在所有三个动力系统上始终达到最高的 AUPRC,优于 DYNOTEARS、PCMCI+ 和 VARLINGAM。基线方法的性能相对较低,其中 DYNOTEARS 和 PCMCI+ 表现出高假阳性率。CADYT 的高 AUPRC 表明其高置信度的因果边大部分是正确的。CADYT 在所有模拟和真实动力系统上以明显优势领先。DYNOTEARS 和 PCMCI+ 等基线方法产生许多虚假边,降低了其 AUPRC。CADYT 在最有信心的因果边上保持高精确率。
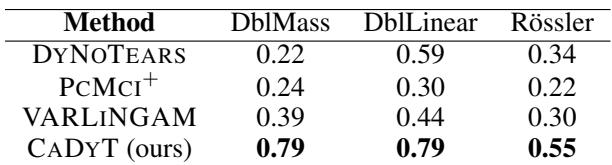
在三个动力系统的实验中,CADYT 始终达到最高的 AUPRC,明显优于 DYNOTEARS、PCMCI+ 和 VARLINGAM 等基线方法。基线方法受高假阳性率困扰,产生许多虚假边,而 CADYT 的高 AUPRC 表明其最有信心的因果边主要是正确的。