Command Palette
Search for a command to run...
马赛克剪枝:面向混合专家模型可泛化剪枝的层次化框架
马赛克剪枝:面向混合专家模型可泛化剪枝的层次化框架
Wentao Hu Mingkuan Zhao Shuangyong Song Xiaoyan Zhu Xin Lai Jiayin Wang
摘要
稀疏混合专家(SMoE)架构开创了大语言模型(LLM)扩展的新前沿,通过在推理期间仅激活总参数的一小部分,实现了卓越的性能。然而,由于所有专家都必须加载到内存中,其实践部署受到大量静态内存开销的严重阻碍。现有的训练后剪枝方法虽然能减小模型规模,但其剪枝准则往往源自单一通用语料库。这导致了一个关键局限:当剪枝后的模型应用于其他领域时,性能会灾难性下降,因此每个新领域都需要代价高昂的重新剪枝。为解决这一泛化差距,我们提出了马赛克剪枝(MoP)。MoP 的核心思想是通过结构化的“先聚类后选择”流程,构建一个功能全面的专家集合。该流程利用一种能捕捉专家在不同任务领域上性能表现的相似性度量,对专家进行功能上的聚类,随后根据我们提出的激活变异性分数从每个聚类中选出最具代表性的专家。与针对单一语料库进行优化的方法不同,我们提出的马赛克剪枝确保剪枝后的模型保留一组功能互补的专家,如同马赛克拼图中共同构成原模型完整能力图景的各片瓷砖,从而使其能够处理多样化的下游任务。在多种 MoE 模型上的大量实验证明了我们方法的优越性。MoP 显著优于先前工作,在通用任务上取得 7.24% 的提升,在数学推理和代码生成等专门任务上取得 8.92% 的提升。
一句话总结
来自西安交通大学和中国电信TeleAI的研究人员提出了马赛克剪枝(Mosaic Pruning,MoP),一种层次化"先聚类后选择"框架,利用激活变异性得分和跨领域专家相似度来保留功能互补的专家,从而缓解单一语料剪枝固有的泛化差距,在通用任务上实现了7.24%的性能提升,在数学推理和代码生成等专业任务上实现了8.92%的提升。
核心贡献
-
论文提出了马赛克剪枝(MoP),一种针对稀疏混合专家(SMoE)模型的训练后剪枝框架,采用层次化"先聚类后选择"流程来保留一组多样化且功能互补的专家,而非针对单一校准语料进行优化。
-
该方法利用一种能够捕获不同任务领域性能的相似度指标对专家进行分组,然后通过所提出的激活变异性得分从每个聚类中选择最具代表性的专家,从而在多样化的下游任务中保留专家能力。
-
在多个MoE模型家族上的大量实验表明,MoP优于现有剪枝基线方法,在通用任务上平均提升7.24%,在数学推理和代码生成等专业任务上平均提升8.92%。
引言
混合专家(Mixture-of-Experts,MoE)模型(如Mixtral 8x7B)在推理时仅激活部分参数,在保持每个token计算成本较低的同时,展现出比Llama 2 70B等更大稠密模型更强的性能。然而,其实际部署受到巨大的静态内存占用(Mixtral超过80GB)以及专家间冗余的限制,因为许多专家功能相似或对大多数任务贡献甚微。此前以枚举剪枝(Enumeration Pruning)为代表的训练后剪枝方法会移除对通用语料上token重建损失贡献最小的专家,但这种方法无法泛化到专业领域,导致数学推理和代码生成等任务上出现"功能坍缩",因为保留的是通用型专家而丢弃了领域专家。为解决这一问题,作者引入了全局变异性感知剪枝(Global Variability-aware Pruning,GVP),利用基于KL散度推导的激活变异性得分为每个专家评分,进而提出了马赛克剪枝(MoP),一种层次化"先聚类后选择"框架,根据任务性能相似度矩阵对专家进行分组,并基于多样性得分保留每组中最为关键的专家代表。该方法保留了功能全面的专家集合,为跨任务泛化提供了强大的归纳偏置;在Mixtral-8x7B和Qwen1.5-MoE-A2.7B上的实验表明,通用任务平均提升7.24%,专业任务平均提升8.92%。
数据集
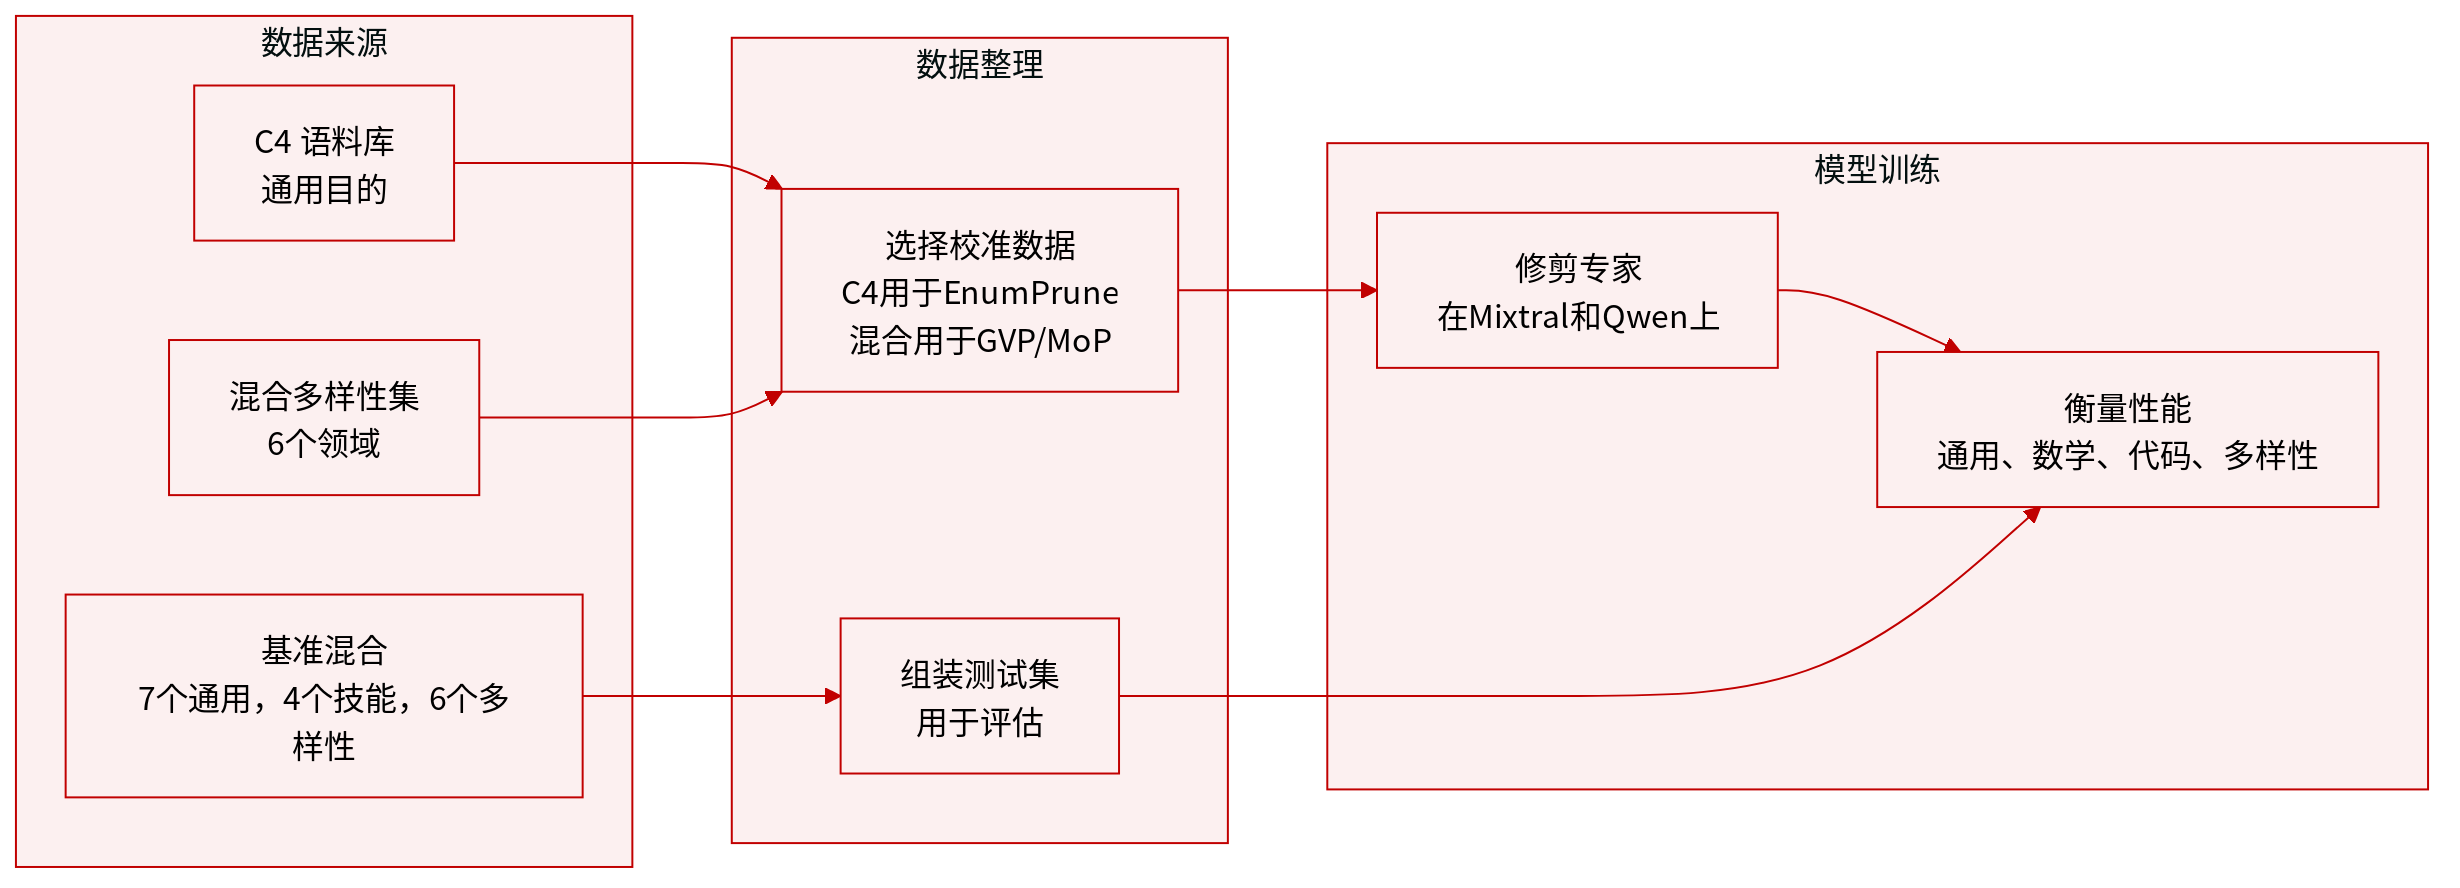
数据集构成与来源
作者使用两个校准数据源和一组成结构的评估基准集来评估其方法,涵盖多个能力领域。
校准数据集
- 主要基线方法枚举剪枝使用来自通用C4语料库的校准数据集。
- 所提出的GVP和MoP方法依赖于混合多样性校准数据集,旨在改善功能聚类。该数据集的具体构成在论文的引用章节中有所描述。
评估基准子集
- 通用能力评估:七个标准基准,包括ARC-c/e、BoolQ、HellaSwag、MMLU、Open-BookQA和WinoGrande。
- 数学推理:GSM8K和MATH。
- 代码生成:HumanEval和MBPP。
- 专家多样性验证:六个不同的领域专属测试集,即Math-GSM8K(数学)、Code-HumanEval(代码)、Commonsense-PIQA(常识推理)、Summarization-XSum(摘要)、Science-ARC-C(科学)和Logic-MNLI(逻辑)。
数据使用方式
- 校准数据仅用于剪枝过程,不同方法使用不同数据源:枚举剪枝使用C4,GVP和MoP使用混合多样性数据集。
- 评估基准用于评估剪枝后的模型性能,涵盖通用能力、专业技能和专家多样性。
- 模型在两个开源MoE架构上进行测试:Mixtral-8x7B-Instruct(470亿参数,每层8个专家)和Qwen1.5-MoE-A2.7B-Chat(143亿参数,每层60个专家),使作者能够在截然不同的专家数量下评估方法的鲁棒性和可扩展性。
- 所有实验在配备四块NVIDIA A100 80G GPU的服务器上运行。
处理与构建细节
- 混合多样性校准数据集的构建旨在支持功能聚类,但论文在所提供的文本中未详细说明其具体的过滤规则或模式。
- 用于专家多样性验证的基准样本来自六个不同领域,每个领域由一种任务类型代表,确保多样性检查的广泛覆盖。
- 所提供的材料中未描述裁剪策略或额外的元数据构建;流程仅围绕校准数据选择和基准评估展开。
方法
作者提出了一种层次化专家剪枝框架,旨在平衡模型性能与功能多样性。该方法论依次经过三个不同阶段:初始基线方法、中间变异性感知策略以及最终的层次化聚类方案。可参考框架图了解这些策略的概念性概述。
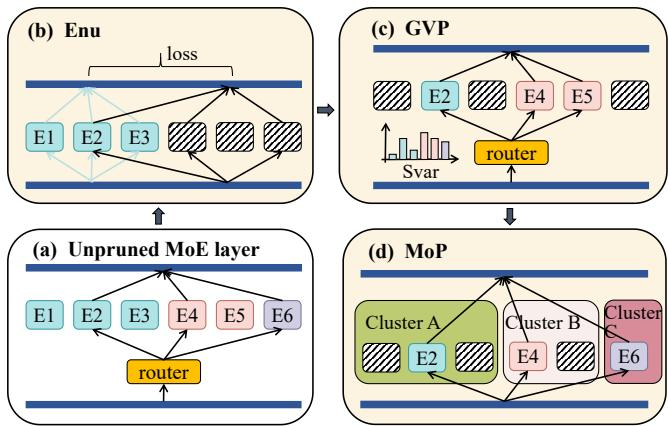
基线策略枚举剪枝(Enu)侧重于最小化移除专家时对模型输出的扰动。它在校准数据集上搜索一个最优专家子集,以最小化输出重建损失。该优化问题形式化表达如下:
Ekept∗=Ekept⊂E,∣Ekept∣=rargminLrecon(Dcache,Ekept)其中Lrecon量化了原始未剪枝的混合专家(MoE)层与剪枝后层输出之间的累积差异。虽然该方法在专家数量较少的模型上有效,但对于较大配置,穷举枚举在计算上变得不可行。在这种情况下,采用贪心策略迭代移除对重建损失增量贡献最小的专家。然而,这种方法倾向于保留功能通用型专家,而牺牲对下游任务至关重要的专家。
为解决Enu对重建损失的过度依赖,作者提出了全局变异性感知剪枝(GVP)。该方法使用统一的变异性指标优先保留功能专家。核心指标是激活变异性得分(Svar),通过计算专家归一化激活分布与所有token上均匀分布之间的KL散度来量化专家的功能专业性:
Svar(i)=t=1∑NtotalZipt,ilog2(Zipt,iNtotal)较高的Svar得分表明激活模式集中,说明该专家为功能专家。GVP策略分两个阶段运行。首先,通过最小化重建损失保留一组核心通用专家(Egeneral)以确保基线性能。其次,从剩余候选池中根据Svar得分的全局排名选择最专业的专家。尽管GVP有所改进,但其全局排名可能保留功能相似但高度专业的专家,导致冗余。
为从根本上解决GVP中的冗余问题,作者提出了马赛克剪枝(MoP),一种系统性地保留专家功能多样性的层次化框架。MoP的第一阶段与GVP类似,保留共享专家集以确保基线性能。核心创新在于第二阶段,该阶段将GVP的简单全局排名替换为基于功能相似度的结构化"先聚类后选择"流程。可参考工作流图查看该过程的详细可视化。
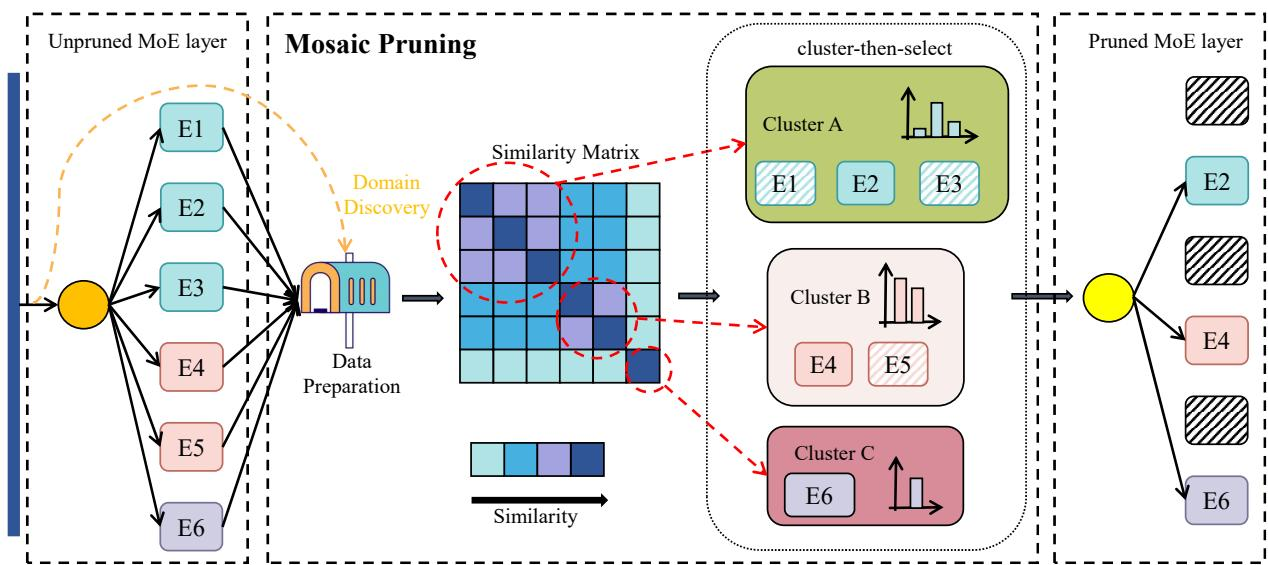
MoP流程始于数据驱动的领域发现。利用混合多样性校准数据集评估专家在不同功能领域的表现。作者对所有token的输入隐状态应用K-Means聚类,将token嵌入划分为语义连贯的领域,最小化组内平方和(WCSS):
Cmink=1∑Kxt∈Ck∑∥xt−μk∥22其中μk是第k个聚类的质心。聚类数K设置为与待选择的专家数量一致,从而在所发现的功能聚类与专家之间建立一一映射关系。
接下来,构建相似度矩阵以评估专家功能相似性。对于候选池中的每对专家,作者根据其在所发现领域上的表现计算相似度得分。选择斯皮尔曼秩相关系数作为核心指标,因为它是非参数的、对异常值具有鲁棒性,并且能够捕获专家绩效中的单调关系。专家i的性能向量viperf使用其在每个领域中的平均重建误差构建。计算专家i和j的秩变换性能向量之间的斯皮尔曼相关系数ρ,最终性能相似度得分被归一化到区间[0,1]:
Sperf(i,j)=21(1+ρ(Ri,Rj))随后应用凝聚层次聚类对专家进行分组。将相似度矩阵转换为距离矩阵,并使用Ward连接法迭代合并最近的聚类对。合并成本定义为合并所导致的总误差平方和(ESS)增量:
Δ(ESS(Ca,Cb))=∣Ca∣+∣Cb∣∣Ca∣∣Cb∣∥μa−μb∥22该过程持续进行,直到候选池被划分为目标数量的聚类。
最后,执行聚类内代表选择。使用激活变异性得分(Svar)识别每个功能聚类中最为专业的专家。对于每个聚类Gk,代表专家ek∗的选择方式如下:
ek∗=i∈GkargmaxSvar(i)由此产生的代表集合构成一组既个体专业又功能互补的专家,有效缓解了冗余,同时保持了多样的能力。
实验
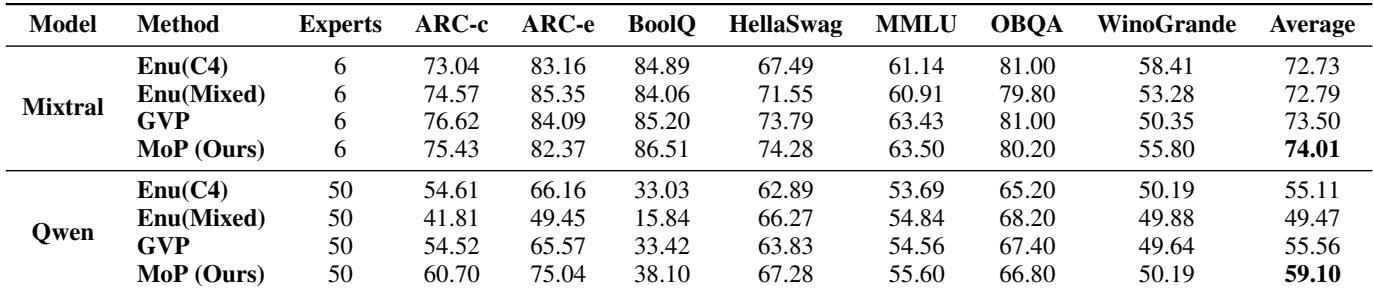
实验在Mixtral-8x7B和Qwen1.5-MoE上开展,涵盖通用、数学、编程和多领域基准。MoP在所有剪枝率和模型下均一致优于所有基线方法,表明保留功能多样性能够实现更鲁棒的模型压缩,同时带来内存节省和更快的推理速度。消融研究证实每个组件都提供了渐进式贡献,即使在校准数据集完全相同的情况下,MoP依然保持优势。激活分析表明,MoP保留了清晰的领域专业性,而基于枚举的剪枝则导致功能同质化;在数学和代码等专业任务上,剪枝后的模型在保留复杂推理能力方面远优于现有方法。
马赛克剪枝(MoP)在所有专家保留率和基准上均一致优于枚举剪枝、随机剪枝和频率剪枝等基线方法,相比枚举剪枝平均提升7.24%。该方法保留了专家间的功能多样性,从而实现鲁棒的压缩。它还带来了显著的部署效率提升,包括内存节省和平均1.20倍的推理加速。在每层6个和4个专家的配置下,MoP相较于所有基线均取得了最高平均得分。在较高剪枝率下性能差距进一步扩大,MoP相比频率剪枝或随机剪枝保持了更强的平均精度。该方法的优势归因于保留了专家功能多样性,防止了基线方法中出现的功能同质化问题。
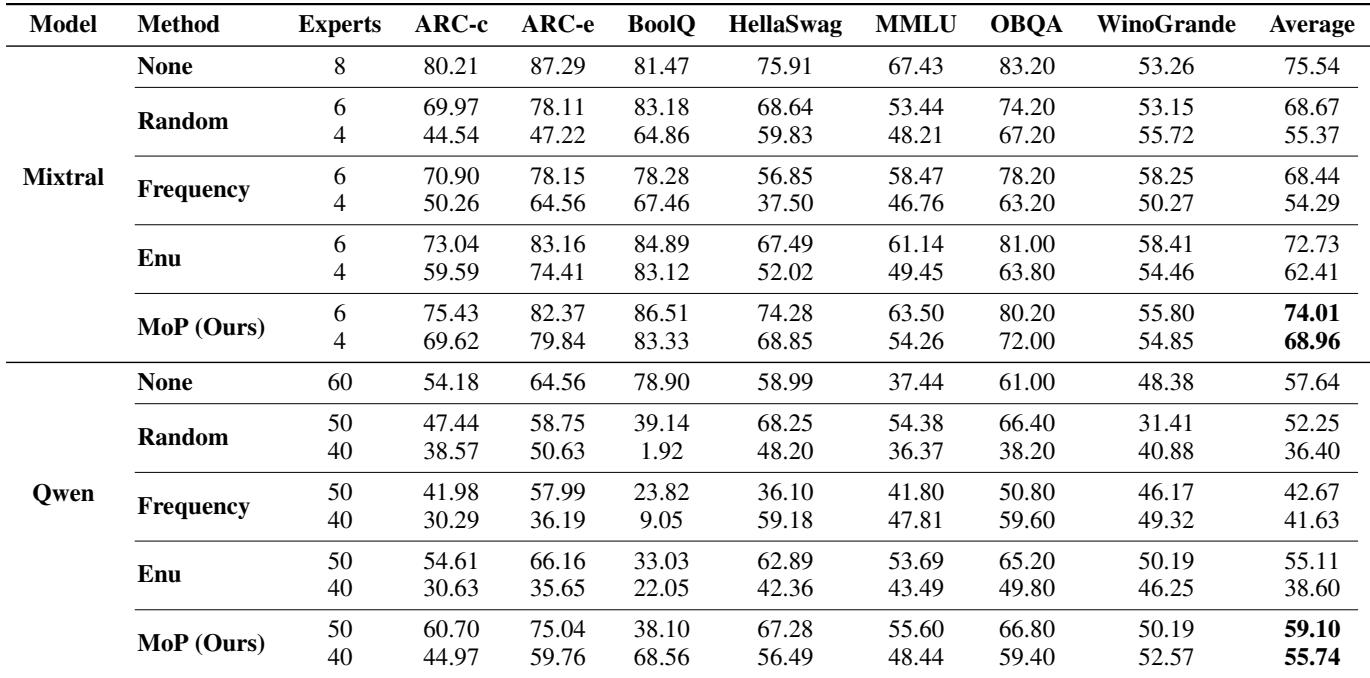
一项跨两个模型的消融研究显示,从枚举剪枝到GVP再到MoP,性能逐步提升,MoP在两种情况下均取得了最佳平均得分。即使将枚举剪枝在MoP所使用的同一混合多样性数据集上重新校准,MoP仍然在所有基准上表现更优。MoP在Mixtral和Qwen上均取得了所有剪枝方法中最高的平均精度。使用相同的混合校准数据集时,MoP在每项评估基准上均超越了枚举剪枝(混合数据集版本)。从枚举剪枝到GVP再到MoP,性能逐步改善,证实了每个组件的贡献。
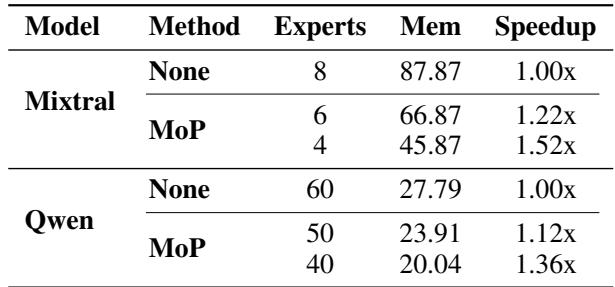
马赛克剪枝(MoP)减少了MoE模型中的专家模块数量,从而带来显著的内存节省和更快的推理速度。在Mixtral和Qwen两种架构上,剪除较少的专家即可获得有意义的加速,平均推理加速比为1.20倍。该方法在实现这些效率提升的同时保持了模型性能。移除专家模块显著降低了两款模型的峰值内存占用。随着专家被剪除,推理速度持续提升,加速比范围为1.12倍至1.52倍。由于专家数量减少以及设备间通信开销降低,MoP实现了平均1.20倍的加速。
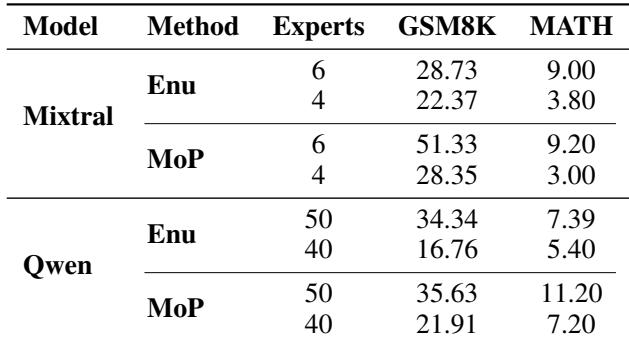
在GSM8K基准上,MoP在两种模型和所有专家数量配置下均一致优于枚举剪枝,在较高剪枝率下优势尤为显著。在MATH基准上,提升幅度不太均匀:MoP在高剪枝率下对Qwen有显著提升,但Mixtral的结果则喜忧参半。总体模式支持了MoP保留功能多样性并避免现有剪枝方法所出现的功能坍缩的观点。在GSM8K上,MoP相比枚举剪枝带来了较大的精度提升,尤其是将Mixtral剪枝到较少专家时。在MATH上,MoP在高剪枝率下对Qwen显示出明显优势,而Mixtral的结果则较为混杂。在所有专业基准上,MoP相比枚举剪枝平均提升8.92%,反映了对专家专业性的更好保留。
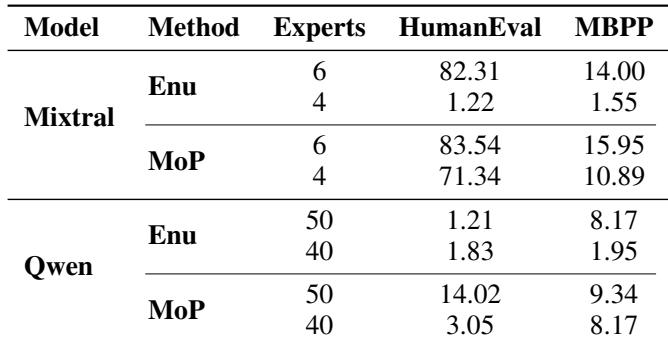
在零样本评估的代码生成基准上,MoP剪枝方法在Mixtral和Qwen两种模型以及不同专家保留水平下均一致优于枚举剪枝。性能差距在较高剪枝率下尤为突出,此时枚举剪枝降至接近零分,而MoP仍能保持有效能力。在相同专家数量下,MoP保持了远高于枚举剪枝的HumanEval和MBPP得分,特别是Mixtral保留4个专家时。枚举剪枝在激进剪枝率下表现出严重的功能坍缩,两模型的HumanEval得分均跌至2分以下。在Qwen的中等剪枝水平(50个专家)下,MoP的HumanEval得分比枚举剪枝高出10倍以上,而MBPP的提升幅度较小但仍为正值。
马赛克剪枝(MoP)通过保留专家间的功能多样性,在基准、模型和专家保留率的各个维度上均一致优于基线剪枝方法,从而防止了基线方法中出现的功能坍缩。消融研究证实每个组件都提供了渐进式贡献,MoP甚至超越了在混合多样性数据集上重新校准的枚举剪枝。除精度之外,MoP还带来了有意义的部署收益,包括内存节省和平均1.20倍的推理加速。在GSM8K、MATH和代码生成等专业任务上,MoP在基线方法经常坍缩的激进剪枝率下仍能保持显著更高的性能。