Command Palette
Search for a command to run...
ReconVLA:作为高效机器人感知器的重建式视觉-语言-动作模型
ReconVLA:作为高效机器人感知器的重建式视觉-语言-动作模型
Wenxuan Song Ziyang Zhou Han Zhao Jiayi Chen Pengxiang Ding Haodong Yan Yuxin Huang Feilong Tang Donglin Wang Haoang Li
摘要
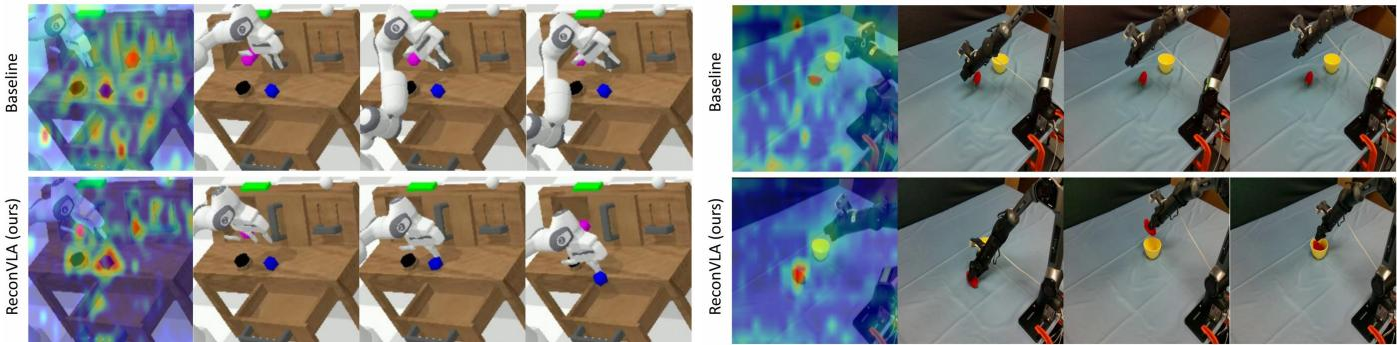
近年来,视觉-语言-动作(VLA)模型的快速发展使机器人智能体能够将多模态理解与动作执行相结合。然而,我们的实证分析表明,当前的 VLA 模型难以将视觉注意力有效分配至目标区域,其注意力始终处于分散状态。为了引导视觉注意力正确定位到目标,我们提出了 ReconVLA,一种具有隐式定位范式的重建式 VLA 模型。以模型的视觉输出为条件,扩散 Transformer 旨在重建图像中的注视区域,该区域对应于目标操作物体。这一过程促使 VLA 模型学习细粒度表征并精确分配视觉注意力,从而有效利用任务特定的视觉信息并实现精准操作。此外,我们从开源机器人数据集中整理了一个包含超过 10 万条轨迹和 200 万个数据样本的大规模预训练数据集,进一步提升了模型在视觉重建方面的泛化能力。在仿真和真实世界中的大量实验证明了我们的隐式定位方法的优越性,展示了其在精准操作和泛化方面的能力。
一句话总结
港科大(广州)、西湖大学、浙江大学和蒙纳士大学提出 ReconVLA,该方法将 VLA 模型的视觉输出作为条件注入扩散 Transformer,以重构与目标操作对象对应的注视区域,从而隐式定位视觉注意力并实现精确机器人操作。
核心贡献
- ReconVLA 是一种在隐式定位范式下训练的重构型视觉语言动作框架,它将扩散 Transformer 的视觉输出作为条件来重构与操作目标对应的注视区域,从而引导精确的视觉注意力分配。
- 从开源机器人数据集中整理出大规模机器人预训练数据集,包含超过 100k 轨迹和 200 万数据样本,以增强跨场景和未见对象的视觉重构与泛化能力。
- 仿真和真实世界实验表明,隐式重构定位支持精确视觉注意力分配、精确操作以及对未见目标的泛化。
引言
视觉语言动作模型旨在将多模态感知转化为机器人动作,因此在杂乱场景和长程任务中精确抓握依赖于准确的视觉定位。以往的 VLA 通常将注意力分散到整个场景,并依赖显式定位流程,例如输入已定位图像或预测边界框,这提升了区域感知,但没有从根本上教会策略将注意力分配给目标。作者提出 ReconVLA,一种重构型 VLA 框架,使用轻量级扩散 Transformer 从视觉输出中重构目标注视区域,隐式引导细粒度表示学习并产生更敏锐的注意力。为支持视觉生成与泛化,作者整理了一个大规模机器人预训练数据集,包含超过 100k 轨迹和 200 万样本,使仿真和真实世界中的操作性能更强。
数据集
-
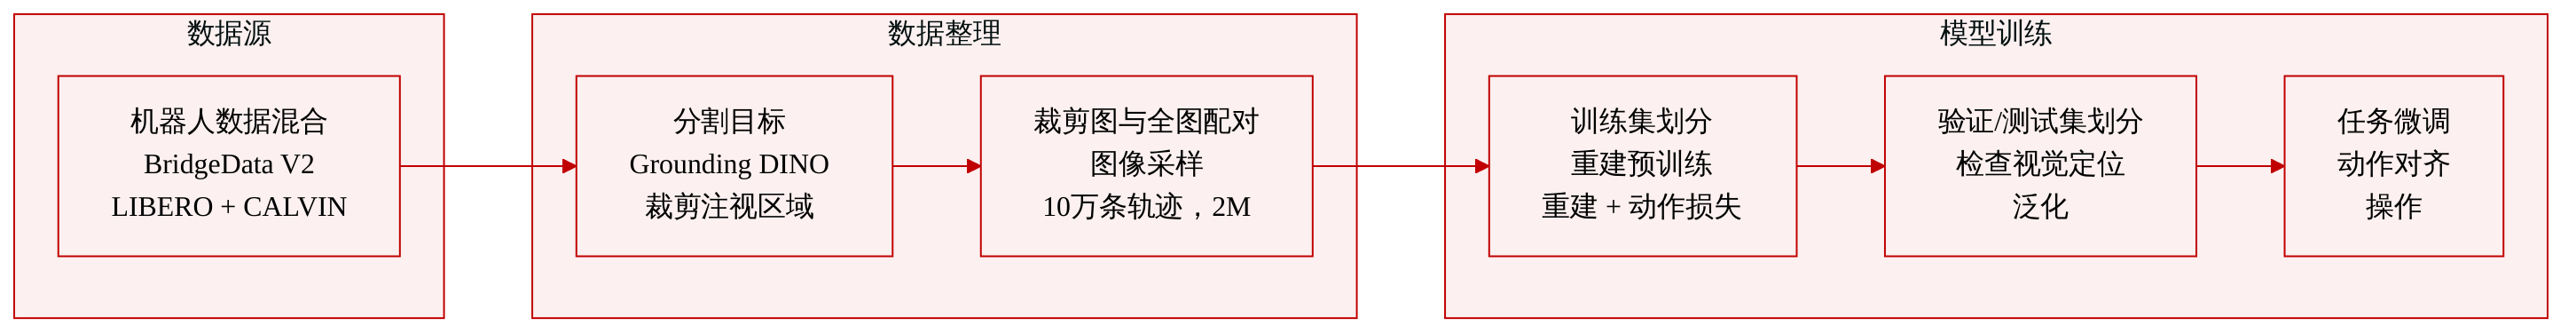
作者从大规模开源机器人数据 BridgeData V2 以及仿真数据集 LIBERO 和 CALVIN 构建视觉预训练数据集。
-
数据集按图文对组织,标注来自被要求交互的区域。
-
作者微调 Grounding DINO(一种开放词汇目标检测器)来分割并裁剪每条指令对应的目标注视区域。
-
每个样本存储裁剪后的目标区域和原始完整图像作为配对示例,支持重构和定位监督。
-
最终视觉预训练语料库包含超过 100k 轨迹和 200 万样本。
-
作者使用该数据集预训练模型重构指定视觉区域的能力,然后在特定任务上微调以实现操作。
方法
作者以标准视觉语言动作模型作为方法基础。给定由图像 I 和文本指令 S 组成的观察对,模型输出可执行机器人动作 A。视觉编码器 E 将图像转换为图像 tokens hI,而文本 tokenizer T 将指令转换为文本 tokens hS。这些 tokens 由大语言模型 LLM 处理,生成离散动作 tokens a,然后动作 detokenizer Q 将这些 tokens 映射为连续或可执行的控制信号:
A=Q(a)=Q(LLM(hI,hS))=Q(LLM(E(I),T(S))).动作 tokens 以自回归方式生成:
p(a)=i=1∏NpLLM(ai∣a1∼i−1;hI;hS),其中 ai 是第 i 个动作 token,N 是动作 tokens 总数。
为缓解视觉注意力分散,所提出的重构型视觉语言动作模型增加了一条辅助视觉监督路径。核心思想是训练模型关注拟操作区域,作者将其称为注视区域。该目标区域作为视觉锚点,帮助模型在多个潜在可操作候选对象中选择正确对象,并提升用于精确控制的细粒度感知。
参见框架图。
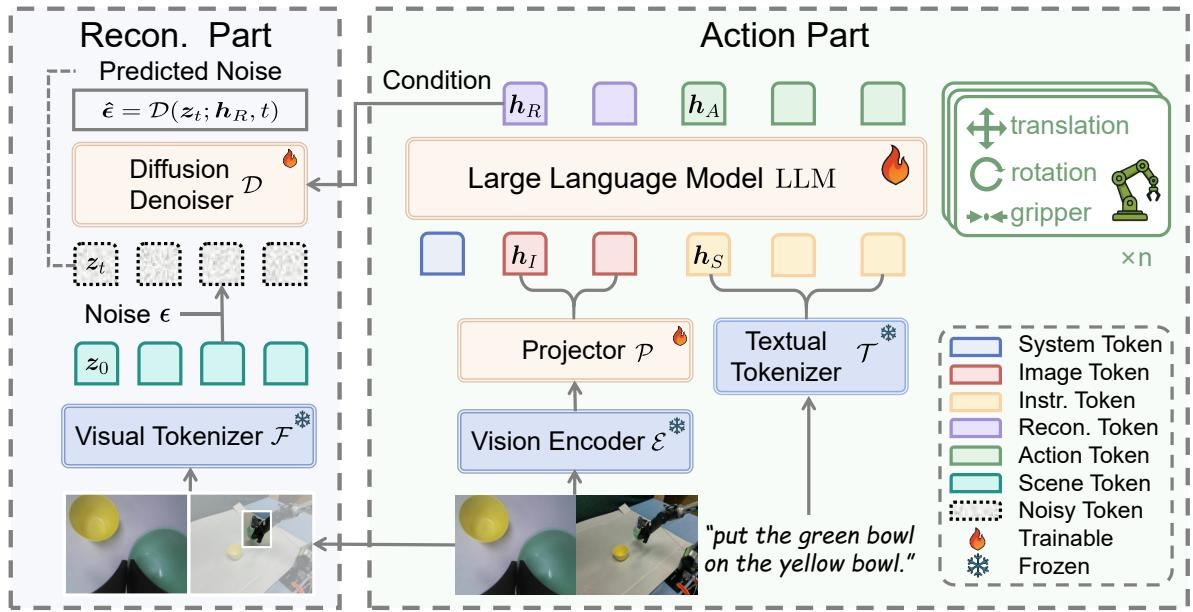
该架构包含两个耦合部分:动作部分和重构部分。动作部分接收图像 tokens 和指令 tokens,将它们输入大语言模型,并输出用于机器人控制的动作 tokens。重构部分从大语言模型状态中生成特殊重构 tokens hR。这些 tokens 作为条件信息,供扩散去噪过程使用,从噪声潜在 tokens 中重构注视区域。
形式化地,重构目标是对应于被操作区域的裁剪图像 I′。视觉 tokenizer F 将该目标转换为场景 tokens z0=F(I′)。前向扩散过程添加噪声 ϵ 以获得噪声 tokens zt。随后,去噪器 D 被训练为在重构 tokens hR 条件下预测噪声:
LVLAvisual(hR,I′)=Et,ϵ[∥D(zt;hR,t)−ϵ∥2],其中 t 表示扩散时间步。去噪器由带自注意力模块的 Transformer 编码器块组成,允许噪声场景 tokens 和重构 tokens 交换信息。由于重构在潜在视觉空间中执行,模型被鼓励捕捉目标区域内在的结构和语义特征,而不是简单复制显式 RGB 值。
总体训练目标结合动作监督和重构监督:
LReconVLA=LVLAaction+LVLAvisual.这里,LVLAaction 是演示动作 tokens 上的交叉熵损失,而 LVLAvisual 衡量潜在视觉空间中的重构质量。该联合目标将操作预测与区域感知视觉定位耦合起来。
一个关键设计细节是 token 顺序。指令 tokens 被放置在图像 tokens 之前,使图像 tokens 通过因果注意力关注指令上下文。这有助于确保视觉 tokens 与指令指定的目标相关联,而不是与无关场景内容相关联,同时保留大语言模型的语言建模能力。
该方法还采用分阶段训练过程。首先,模型在配有裁剪注视区域的机器人轨迹数据上进行视觉重构预训练。在该阶段,重构损失和动作损失都会进行梯度反向传播,使视觉定位目标与控制目标保持一致。这一步增强模型在不同场景中定位并重构任务相关区域的能力。预训练之后,模型在任务特定操作数据上适配,使其视觉语言理解、视觉重构行为和动作生成与目标动作空间对齐。
实验
实验在仿真和真实世界机器人操作中评估 ReconVLA,使用基准长程任务和实践多任务设置来测试视觉定位、预训练泛化和精确控制。与显式定位和思维链定位的比较表明,隐式定位能更好地将注意力聚焦于目标对象,并避免冗余或含糊的空间线索;消融实验证实,预训练和注视区域重构提升了泛化能力和目标选择能力。所提出方法在长程仿真和真实世界任务中也表现出色,包括未见对象,表明其相比基线方法具有更强的视觉定位、操作精度和适应性。
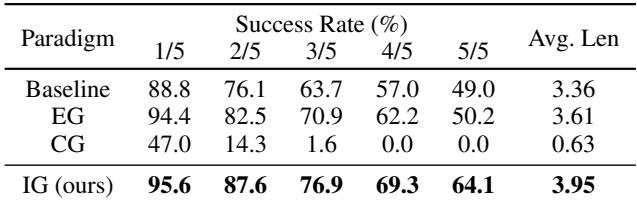
隐式定位在任务长度增加时带来最强总体操作性能和最佳增益。显式定位也优于基线,尤其对短链有效,但在长程任务中不如隐式定位有效。思维链定位总体表现较差,并随着连续任务增加急剧下降。比较中,隐式定位取得最高成功率和最长平均任务序列。显式定位提升基线但落后于隐式定位,尤其在更长子任务链上。思维链定位随任务长度严重退化,表明在该设置下扩展性较差。
结果和讨论表明,基于重构的训练在采用大规模预训练并关注注视区域而非完整图像时更强。这些技术改善了未见机器人操作设置中的对象定位和泛化,而完整图像重构仍可通过增强整体视觉注意力提供帮助。所比较的生成式基线显示较强的早期表现,但在后续子任务成功率较低。在大规模数据集上预训练提升了未见操作环境中的泛化和成功率。重构注视区域帮助模型聚焦目标对象,并支持更可靠的操作。列出的生成式方法在早期子任务表现最佳,并在连续子任务中逐渐减弱。
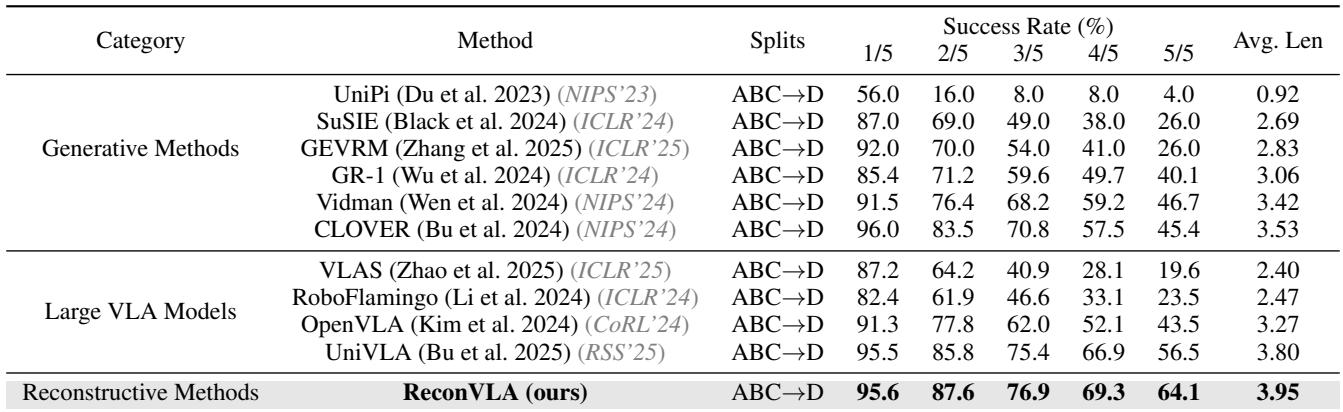
ReconVLA 在 CALVIN 操作基准上与生成式方法和大型视觉语言动作模型相比表现良好。它取得所比较模型中最高的平均连续任务完成长度,以及较强的第一步成功率,同时在后续子任务上保持有竞争力的性能。这一趋势表明,对当前视觉观察进行定位可以提高长程操作可靠性。在所比较模型中具有最高报告平均连续任务完成长度。与生成式和大型 VLA 基线相比具有较强的第一步成功率。在未见背景设置的后续子任务上,相对生成式基线具有报告优势。
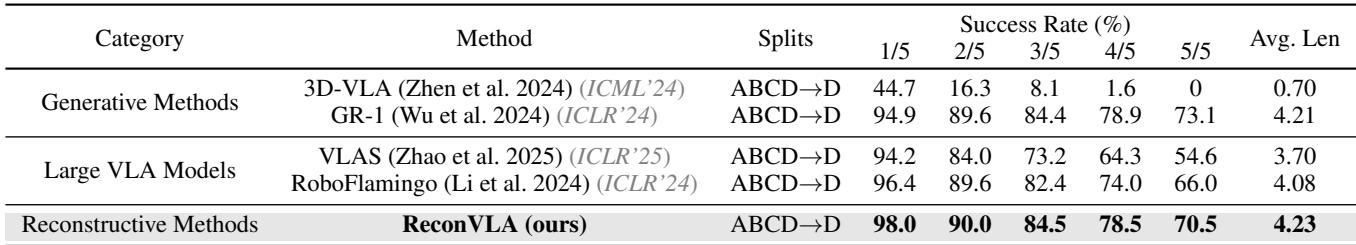
实验在包括 CALVIN 在内的机器人操作任务上评估定位策略、基于重构的训练变体以及 ReconVLA,并与生成式和大型视觉语言动作基线进行比较。隐式定位提供最强总体操作性能,并且在更长任务链上具有更好的扩展性,而显式定位主要帮助短链,思维链定位随长度急剧退化。重构训练在大规模预训练和注视区域重构时最有效,能够改善未见设置中的对象定位和泛化,尽管完整图像重构仍可支持视觉注意力。ReconVLA 在长程和未见操作任务上优于所比较的生成式基线,取得强第一步成功率和最佳连续任务长度,表明对当前观察进行定位可提高长程可靠性。