Command Palette
Search for a command to run...
LLM2CLIP: Powerful Language Model Unlocks Richer Cross-Modality Representation
LLM2CLIP: Powerful Language Model Unlocks Richer Cross-Modality Representation
摘要
CLIP is a seminal multimodal model that maps images and text into a shared representation space by contrastive learning on billions of image–caption pairs. Inspired by the rapid progress of large language models (LLMs), we investigate how the superior linguistic understanding and broad world knowledge of LLMs can further strengthen CLIP—particularly in handling long, complex captions. We introduce an effcient fne-tuning framework that embeds an LLM into a pretrained CLIP while incurring almost the same training cost as regular CLIP fne-tuning. Our method frst "embedding-izes" the LLM for the CLIP setting, then couples it to the pretrained CLIP vision encoder through a lightweight adaptor trained on only a few million image–caption pairs. With this strategy we achieve large performance gains—without large-scale retraining—over stateof-the-art CLIP variants such as EVA02 and SigLIP-2. The LLM-enhanced CLIP delivers consistent improvements across a wide spectrum of downstream tasks, including linear-probe classifcation, zero-shot image–text retrieval with both short and long captions (in English and other languages), zero-shot/supervised image segmentation, object detection, and used as tokenizer for multimodal large-model benchmarks.
一句话总结
同济大学、微软公司和麦考瑞大学的研究人员提出 LLM2CLIP,这是一种高效微调框架,通过仅在数百万图像描述对上训练的轻量级适配器,将大语言模型嵌入预训练 CLIP,从而在零样本分类、零样本图文检索、分割和检测等任务上,相对于 EVA02 和 SigLIP-2 等最新变体取得一致提升,且无需大规模重新训练。
核心贡献
- 该论文引入 LLM2CLIP,这是一个轻量级微调框架。它通过将大语言模型转化为描述嵌入模块,并通过一个小型可训练适配器连接到预训练 CLIP 视觉编码器,从而增强预训练 CLIP 处理较长且复杂描述的能力。
- 该集成设计冻结大语言模型,将其句嵌入作为固定特征,并移除原始 CLIP 文本编码器。消融实验表明,直接替换比组合或拼接 CLIP 与 LLM 文本特征更有效。
- 仅在数百万图像描述对上训练即可在强 CLIP 基线上取得显著提升,包括在短描述检索上相对 SigLIP-2 提升 +1.0/+1.9,在长描述检索上提升 +14.8/+15.8,在多语言任务上提升 +11.9/+15.2,并在零样本分类、分割、检测和多模态基准上取得增益。
引言
CLIP 是一个轻量级跨模态基础模型,它将图像和文本映射到共享空间中,支持图文检索、零样本分类、检测、分割和生成流程。其双塔设计高效且可扩展,但其文本编码器可能在处理较长或较复杂描述时表现不足,并且缺乏现代 LLM 的广泛文本理解能力。此前将 LLM 与 CLIP 结合的方法通常使用较弱语言编码器,需要高成本联合训练,或者忽略原始 LLM embeddings 对对比学习而言判别性不足的问题。该研究利用 LLM2CLIP,先通过微调将 LLM 转变为描述感知嵌入模型,然后用冻结 LLM 加上一个小型适配器替换 CLIP 的文本编码器,从而以接近标准 CLIP 微调成本改善检索和下游多模态任务。
数据集
-
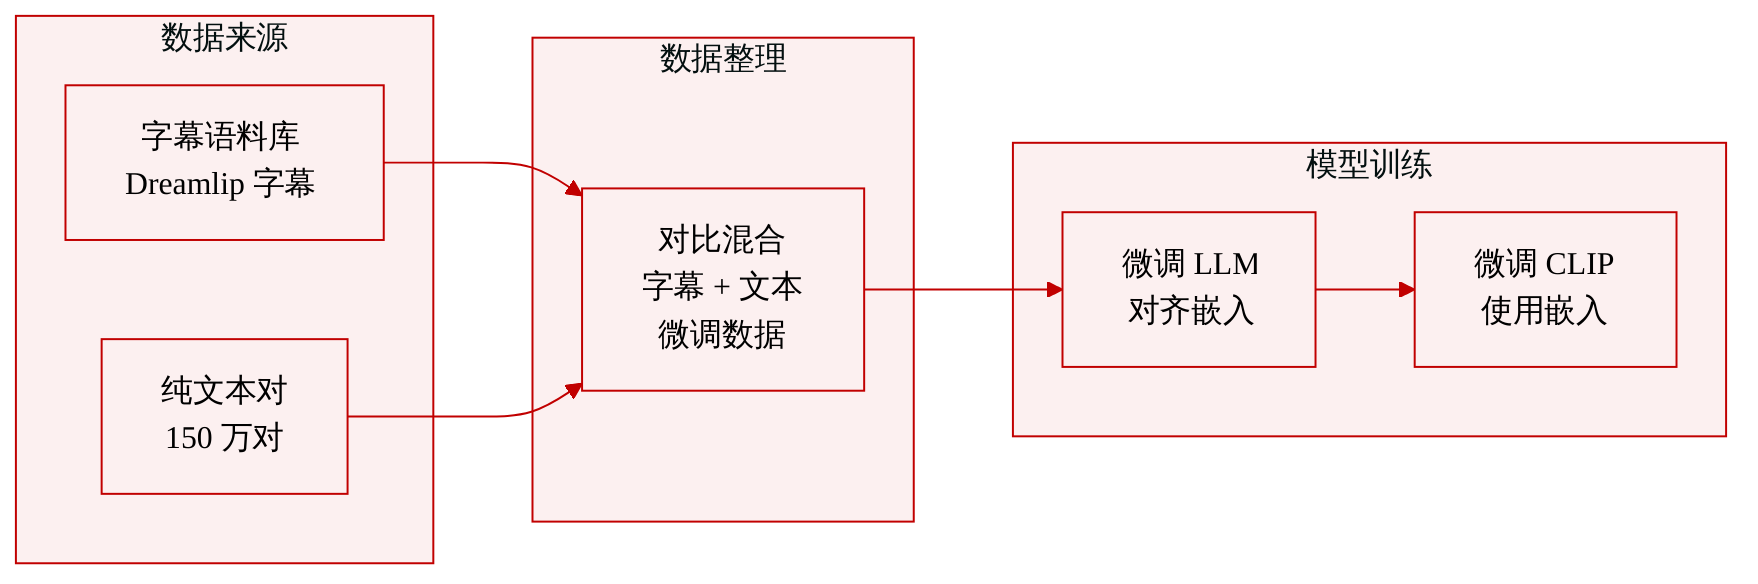
该研究使用两类主要数据源进行对比训练:基于图像的描述语料和纯文本对。
-
描述数据:
- 来源:从图文数据集中提取的描述语料。
- 主要子集:Dreamlip 描述。
- 关键细节:图像可能具有多个相关描述。
- 用途:支持有监督文本对比学习,并帮助将 LLM 嵌入空间与下游多模态任务对齐。
-
纯文本数据:
- 来源:Echo Embeddings。
- 规模:150 万纯文本对。
- 用途:用于在对比训练期间保留通用语言理解能力。
-
数据使用:
- 描述数据和纯文本对被组合为混合对比训练设置。
- 该混合数据用于微调 LLM,其 embeddings 随后用于 CLIP 微调。
方法
所提方法可以理解为一个两阶段适配流程。第一阶段,通过基于描述的对比学习微调,将大语言模型转换为句嵌入模型。第二阶段,将该微调后的语言模型作为文本通路插入预训练 CLIP 模型,然后使用图像与文本对比学习对 CLIP 进行后微调。
第一阶段处理生成式语言模型与嵌入模型之间的不匹配。标准语言模型通过输出层输出离散 tokens,而 CLIP 需要密集句级表示。因此,该研究将语言模型的输出特征映射为整句表示。其比较了序列结束 token 表示和跨所有输出 tokens 的平均池化。平均池化被用作默认设置,因为经验上它能带来更强的特征质量。序列结束 token 能够关注完整输入句子,但池化为嵌入提取提供了更稳定的聚合。
为了改善文本理解,该研究修改语言模型的注意力行为。由于下游目标是编码而非生成,因此移除因果注意力掩码。这允许模型建模输入描述中 tokens 之间的双向关系。该研究还使用低秩适配(LoRA)进行参数高效微调。这在基本冻结主要语言模型权重的同时,使输出空间能够适配面向嵌入风格的目标。
该研究还考察了在语言模型之后增加适配器以提升特征可分性。考虑了三种变体。第一种是带有若干潜在交叉注意力层的 Transformer 风格适配器。第二种是在提取句表示后由多个线性层构成的线性适配器。第三种不使用适配器。适配器被视为紧凑模块,可在语言模型 embeddings 用于对比学习前进一步重塑其特征。
对于第一阶段训练,该研究最初考虑掩码下一 token 预测。该目标会对选定的 tokens 进行掩码,并从被掩码 token 之前位置进行预测,从而保留因果语言模型的下一 token 预测范式。尽管该目标可以改善纯文本 embeddings,但该研究发现,在多模态设置下,它不如直接对比微调。因此,核心训练信号变为文本对比学习。
文本对比学习设置遵循 SimCSE 的风格思想,即在嵌入空间中分离正向和负向描述对。该研究使用两种可能形式。无监督形式依靠 dropout 增广来创建同一句子的不同视图。有监督形式使用来自标注数据的语义相关描述对。有监督变体被用作默认设置,因为它提供更强的监督信号。正向对由同一图像的两个不同描述构建。这些对会配合一个 system prompt 进行格式化,要求模型从给定描述中检索相似的相关描述。
给定一批描述表示,有监督对比目标会将 anchor 描述的表示拉近其正向对,并将其推离 batch 中的其他描述。设 zi 表示 anchor 描述的嵌入,zi+ 表示其正向描述,τ 表示温度缩放因子。一个典型的基于 batch 内负样本的对比损失可以写为
Ltxt=−log∑jexp(sim(zi,zj)/τ)exp(sim(zi,zi+)/τ).第一阶段使用从图像和文本数据集派生的描述语料。为每张图像提供多个描述的描述集合尤其有用,因为它们自然地提供了有监督正向对。为避免语言模型过拟合到短描述风格文本,该研究还将纯文本对比对混合进训练。这有助于保留更广泛的语言理解,同时仍将嵌入空间适配到描述检索语义。
第二阶段从预训练 CLIP 模型开始,其视觉和语言组件已经编码了强图像语言映射。CLIP 通常包含视觉编码器和相对较小的文本编码器。该研究将此预训练映射视为强基础,并引入经过描述对比学习微调的语言模型,以丰富语言侧。目标不是从头训练 CLIP,而是执行一个定向后微调步骤,将大语言模型连接到视觉嵌入空间。
高效适配是该阶段的核心,因为 CLIP 训练通常需要大型数据集和大 batch sizes。该研究使用参数高效微调。对于视觉编码器,默认允许全梯度,从而让视觉表示能够从更丰富的语言侧信号中学习。对于语言模型,其比较两种选项。第一种使用低秩适配保持语言模型可训练。第二种完全冻结语言模型,并在其输出层后附加适配器。冻结语言模型加适配器被用作默认配置,具体为由四个线性块组成的适配器。
冻结语言模型加适配器设计提供了重要的系统收益。由于语言模型被冻结,其文本特征可以离线预先计算并在训练期间存储。这避免了在多个训练 epoch 中反复将大语言模型加载到 GPU memory。因此,训练循环只需加载 CLIP、适配器和缓存的句特征,从而降低 GPU 显存占用、降低推理开销并加速实验。
加入语言模型后,CLIP 有两个潜在文本通路:原始 CLIP 文本编码器和新的语言模型编码器。该研究探索了组合它们的多种方式。一种选择是移除原始 CLIP 文本编码器,并直接将语言模型与 CLIP 视觉编码器配对进行跨模态对比学习。另一种保留两个文本编码器,并分别对二者应用对比损失。第三种保留两者,并在语言模型与原始文本编码器之间添加额外对比任务。第四种拼接它们的输出特征,并跨模态对比学习使用视觉编码器。采用的设计是第一种选择:移除原始 CLIP 文本编码器,并将微调后的语言模型嵌入用作唯一文本编码器。
在这一跨模态对比设置中,视觉编码器生成图像嵌入,而冻结语言模型和适配器生成文本嵌入。模型随后在图像文本 batch 内优化图像与文本表示之间的对称对比对齐。如果 vi 是图像 i 的嵌入,ti+ 是其对应描述的嵌入,τ 是温度,则对比目标会鼓励匹配的图像文本对在共享空间中占据邻近区域。
第二阶段训练数据聚焦于密集且详细的图像描述。由于语言模型在处理长文本描述方面远强于原始 CLIP 文本编码器,该方法可以从包含更丰富视觉细节的描述中受益。该研究使用为同一图像提供多个密集描述的变体。训练期间,其考察单张图像的多个正向描述样本,并将真实描述与多模态描述系统生成的密集描述进行混合。最终默认设置将真实描述与密集生成描述按百分之五十比例混合,使模型能够从自然人类描述和详细合成描述中学习。
实验
实验在检索、分类、分割、检测和多模态模型任务上评估两阶段 LLM2CLIP 流程,使用 CLIP 系列编码器、不同数据规模和替代语言骨干。总体而言,LLM2CLIP 改善了跨模态对齐,特别是在长文本和多语言检索方面,并生成更强的视觉表示,从而有利于下游探测和多模态推理,尽管零样本分类出现轻微权衡。消融实验进一步表明,第一阶段中的有监督 SimCSE 与 LoRA 至关重要,额外训练数据持续有帮助,而第二阶段使用简单线性适配器并通过替换而非复用原始 CLIP 文本编码器时效果最佳。
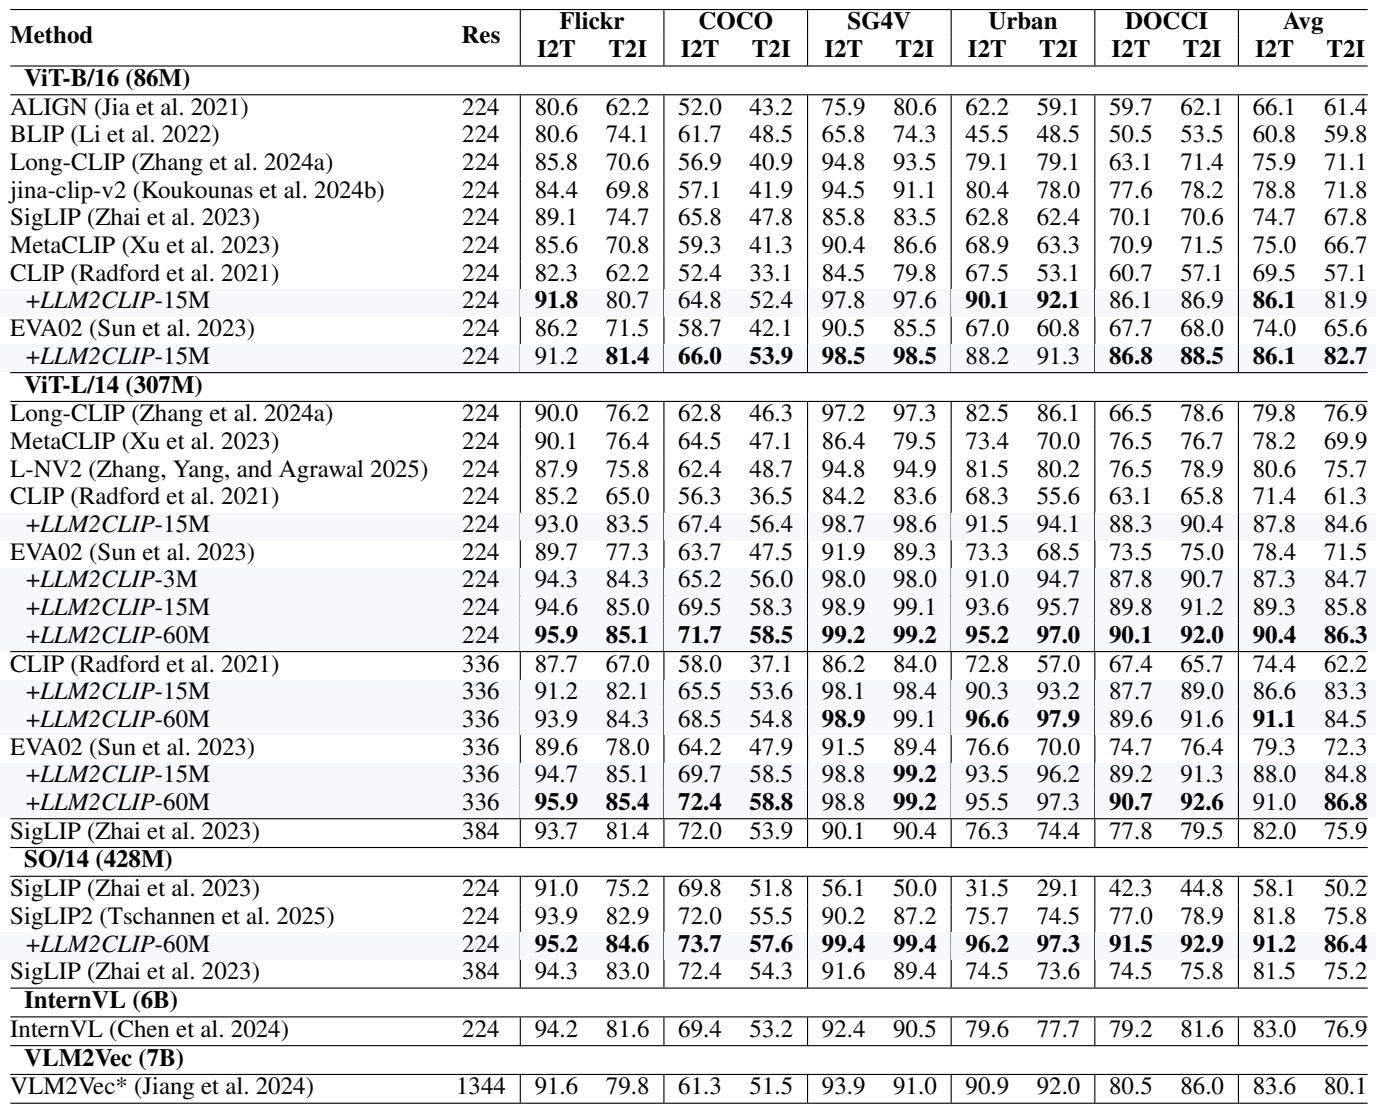
对比结果显示,LLM2CLIP 后训练增强了多个预训练 CLIP 风格模型在零样本英文图文检索上的表现。增益出现在短描述和长描述基准上,并在长描述数据集上优势更大。该提升在多种视觉模型变体上均可见,甚至在强预训练的 SigLIP2 模型上也成立。LLM2CLIP 相比 base CLIP、EVA02 和 SigLIP2 模型产生一致的检索提升。长文本检索数据集比 Flickr 和 COCO 等短描述数据集受益更多。该方法在不同模型规模和视觉骨干上仍然有效。
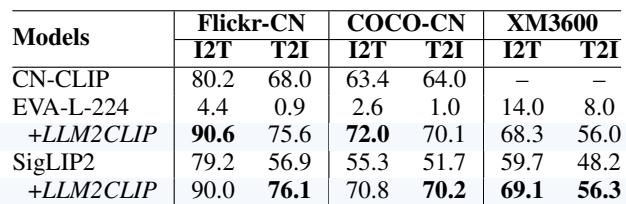
多语言检索结果显示,添加 LLM2CLIP 能持续改善 Flickr-CN、COCO-CN 和 XM3600 上的双向图文检索。该增益在 EVA-L-224 上尤其明显,该模型在后训练前在中文短描述数据集上表现较弱,但在 LLM2CLIP 后变得具有竞争力。SigLIP2 本身已经较强,但 LLM2CLIP 仍然提升图像到文本和文本到图像得分。LLM2CLIP 在中文 Flickr 和 COCO 检索以及 XM3600 上产生广泛增益。EVA-L-224 在 LLM2CLIP 后从较弱的中文检索变为强双向检索。尽管 SigLIP2 基线已经很高,LLM2CLIP 在报告的所有 SigLIP2 比较中仍然带来提升。
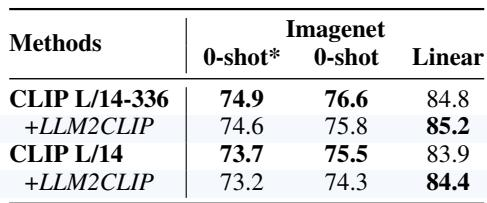
该表比较了 CLIP 基线及其 LLM2CLIP 后训练变体在 ImageNet 零样本分类和线性探针评估上的表现。在两种模型规模下,LLM2CLIP 会轻微降低零样本准确率,同时轻微提升线性探针性能。更大的 336 分辨率 CLIP 变体在报告的所有设置中仍强于标准 CLIP 变体。LLM2CLIP 在相应 CLIP 基线上提供线性探针性能的微小增益。在该表中,零样本分类准确率并未因 LLM2CLIP 而提升。CLIP L/14-336 在零样本和线性探针设置中均持续优于 CLIP L/14。
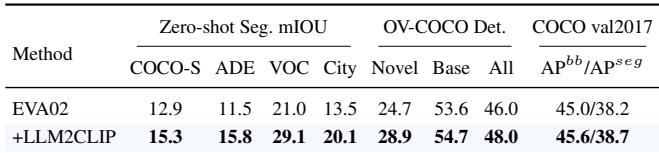
报告的结果显示,将 LLM2CLIP 添加到 EVA02 视觉模型可提升零样本分割和开放词表检测任务的性能。这些增益在分割数据集上一致,并且比检测准确率和 COCO AP 指标中较小但依然为正的改善更显著。零样本分割 mIOU 在 COCO-S、ADE、VOC 和 City 上均提升,其中 VOC 和 City 上的相对增益尤其强。开放词表 COCO 检测也得到改善,包括 novel、base 和 all 类别以及检测 AP 的适度提升。
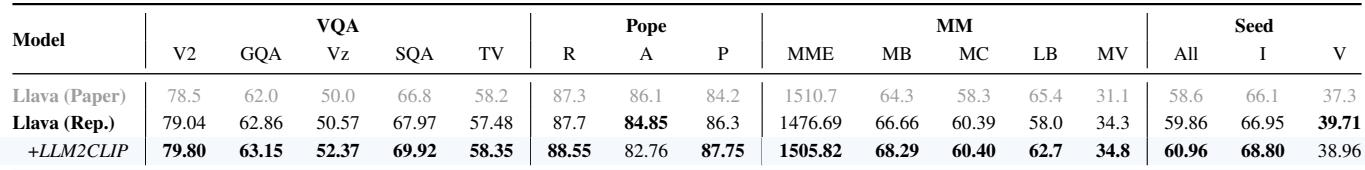
该表比较了当原始 CLIP ViT-L/14 视觉编码器被替换为微调后的 LLM2CLIP 版本时的 Llava 1.5 结果。+LLM2CLIP 行通常在多个基准列上优于复现的 Llava 基线,尤其在 Seed V2、GQA、Vz、TV、MB、MC 和 LB 上。少数列,例如 SQA 和 MV,低于复现基线,表明改进广泛但并非均匀。将 CLIP ViT-L/14 替换为微调后的 LLM2CLIP 变体相对于复现 Llava 运行提升了 VQA、POPE、MM、Seed V2、GQA 和 Vz 分数。相对于复现 Llava 基线,+LLM2CLIP 模型还改善 TV、R、A、P、MME、MB、MC 和 LB。SQA 和 MV 在 +LLM2CLIP 下仍低于复现 Llava 基线,因此该替换不会改善每一个基准列。
实验评估了 LLM2CLIP 作为 CLIP 风格视觉编码器后训练方法的效果,测试其对英文和中文零样本图文检索、ImageNet 分类、开放词表分割与检测,以及替换视觉编码器后的 Large Language-and-Vision Assistant 的影响。结果显示,LLM2CLIP 通常能够跨模型规模和视觉骨干增强检索性能,并在长描述和多语言设置中带来特别强的收益,同时让较弱的中文检索基线显著恢复。尽管 ImageNet 零样本分类准确率略微下降,线性探针性能有所提升,并且该方法还支持开放世界视觉理解任务和大多数多模态助手基准的增益,表明其效果广泛但并非对所有基准都为正向。