Command Palette
Search for a command to run...
通过多模态分析自闭症儿童眼手协调的独特行为模式(学生摘要)
通过多模态分析自闭症儿童眼手协调的独特行为模式(学生摘要)
Emily Yu
摘要
数据驱动分析在识别自闭症谱系障碍(ASD)个体行为中的细微模式方面展现出良好前景,可辅助诊断与干预。然而,现有方法大多聚焦于单一行为模态(如眼动),未能捕捉人类复杂的多模态行为。本文提出一种多模态方法,通过眼到手预测探究眼动与手部运动之间的内在关联。针对高度噪声化且不规则的行为数据,我们提出一种新颖方法,将预测任务定义为机器翻译问题,并利用序列到序列机器学习模型完成预测。基于 VR 系统采集数据集的实验研究表明,该方法具有较高的预测准确率。自闭症组与典型发育(TD)同龄组在预测准确率上的显著差异,为客观理解自闭症儿童的受限和重复行为(RRBs)提供了量化证据。源代码可在此获取:https://github.com/mathjams/AAAI 2024。
一句话总结
门顿高中的一名学生提出了一种多模态眼到手预测框架,将该任务重新表述为借助序列到序列模型求解的机器翻译问题,并表明在 VR 采集的数据上,自闭症儿童和典型发育儿童的预测准确率存在显著差异,为 ASD 中的限制性、重复性行为提供了量化证据。
核心贡献
- 提出一种多模态行为分析方法,将 VR 系统采集的眼动和手部运动数据关联起来,扩展了以往通常仅关注单一行为模态的方法。
- 将眼到手预测表述为机器翻译问题,并使用序列到序列模型将带噪声、不规则的眼动序列翻译为手部运动序列,从而在预测下一个手部位置时比基于对齐的替代方法更准确。
- 使用来自自闭症儿童和典型发育儿童的 VR 游戏数据集,证明预测准确率较高,并且组间预测准确率存在显著差异;对自闭症参与者的手部运动预测更准确,这为与限制性、重复性行为相关的模式提供了量化证据。
引言
自闭症谱系障碍是一种可能影响学习、社交互动、沟通和行为的发展性状况,研究人员越来越多地利用虚拟现实从儿童身上采集细粒度行为数据。传统诊断通常依赖问卷,可能遗漏细微的感官和行为模式,而现有数据驱动研究通常一次仅分析一种行为信号。作者指出,多模态行为数据具有挑战性,因为其存在噪声,并且不同传感通道之间的对齐较差,使得难以建模眼动和手部运动等信号之间的关系。为解决该问题,作者利用与机器翻译的类比,提出一种行为数据翻译框架,从眼动数据预测手部运动序列。结果表明,该方法优于替代设计,并揭示了自闭症儿童和典型发育儿童之间更清晰的行为差异;自闭症个体的手部运动更可预测,提供了可能支持后续干预和评估的量化证据。
方法
作者将多模态眼部和手部注视数据的分析表述为序列到序列翻译问题。在该表述中,按时间排列的注视序列被翻译为相应的手部注视序列。底层数据来自一个虚拟教室界面,该界面通过协调的眼动追踪和手部运动采集来记录与注意力相关的行为。系统在整个任务会话期间观测注视事件。每个注视用一个元组表示:
ri=(xi,yi,tis,tie),其中 xi 和 yi 表示归一化单位屏幕上的空间位置,tis 和 tie 表示注视开始时间和结束时间。空间坐标是单位正方形内的连续值:
(xi,yi)∈[0,1]2.下面展示数据采集环境。请参见图示的多模态界面,该界面用于生成注视序列。该界面将任务面板、背景教室活动和任务相关面板结合起来,提供了能够以时间对齐的流形式记录注视和手部行为的生态化场景。
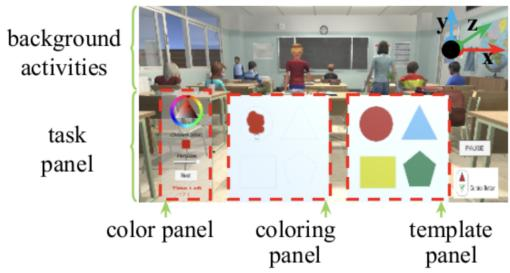
第一种建模设计使用基于长短期记忆或门控循环单元的循环序列到序列模型。模型将眼部注视序列作为源序列。为支持翻译,输入表示同时包含空间注视位置以及注视开始时间和结束时间。因此,循环结构从注视轨迹中学习时间上下文,并将其映射到目标手部注视序列:
E↦H.从概念上看,循环编码器或循环处理路径汇总不断演化的注视序列,而序列生成路径输出手部注视序列。时间特征使模型能够区分短暂注视和持续注视,二者可能对后续手部运动产生不同影响。
第二种设计增加了一个空间模块。屏幕被划分为功能区域,包括主任务区域、辅助区域和参考区域。对于选定区域,眼部输入经过过滤,仅保留坐标落在该区域内的注视。然后,门控循环单元序列到序列模型预测同样位于该区域内的手部注视。这得到了一种区域条件化的眼到手映射。该设计将学习到的翻译限制在局部注视与运动之间的关系上,并使分析能够考察特定屏幕区域中的注意力如何支配相应的手部行为。
实验
实验在固定的训练和测试划分上训练循环模型,并比较具有不同眼部注视输入的 GRU 和 LSTM 变体,以预测手部注视序列,包括一种基于区域的 GRU 设计。结果表明,GRU 通常表现最佳,并且与典型发育个体相比,自闭症个体的预测可靠性显著更高,尤其是在任务焦点区域和参考区域。这些发现表明,自闭症的注视与手部协调更有规律且更可预测,为与限制性、重复性行为相关的模式提供了量化支持。
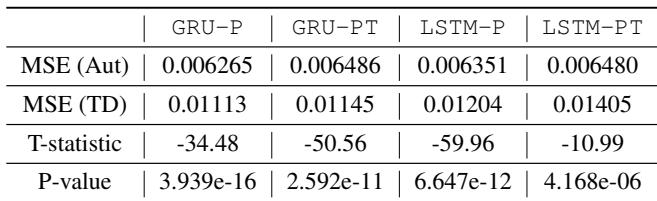
在 GRU 和 LSTM 变体中,与典型发育序列相比,自闭症手部注视序列的预测误差更低,且差异具有统计显著性。在该表中,GRU 模型,尤其是仅使用注视位置的版本,总体表现最强。增加开始时间和结束时间特征并不会一致提升准确率。所有模型变体在自闭症个体预测上的表现都优于在典型发育个体预测上的表现。与 LSTM 预测相比,GRU 预测通常误差更低。同时使用注视位置以及开始和结束时间并没有为任一组产生最低误差。
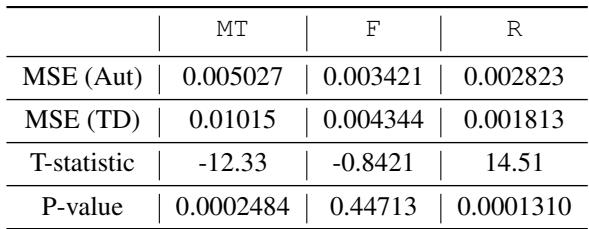
不同区域之间的预测误差存在差异;在主任务区域,自闭症个体表现出显著更低的误差。辅助区域中,自闭症个体与典型发育个体之间的预测差异很小;参考区域则呈现相反模式,典型发育个体的误差更低。这些趋势表明,在主任务期间,自闭症行为的预测准确率最高,而参考区域行为在典型发育组中可能更一致。在主任务区域,自闭症行为的预测更准确。在辅助区域,自闭症个体和典型发育个体的误差相似。在参考区域,典型发育行为的预测更准确。
实验评估了用于预测自闭症个体和典型发育个体注视行为的 GRU 和 LSTM 模型。总体而言,GRU 模型优于 LSTM 变体,其中仅使用注视位置得到最强结果,时间特征带来的额外收益有限。区域层面分析进一步表明,在主任务区域,自闭症行为的预测更准确;在辅助区域,表现相近;在参考区域,典型发育行为的预测更准确。