Command Palette
Search for a command to run...
面向活动的 RGB-热成像视频中多模态手到口手势识别(学生摘要)
面向活动的 RGB-热成像视频中多模态手到口手势识别(学生摘要)
Glenn Fernandes Meixi Lu Farzad Shahabi Jiayi Zheng Aggelos Katsaggelos Nabil Alshurafa
摘要
暴饮暴食和吸烟等健康风险行为对公共健康具有深远影响,对其进行监测和干预至关重要。目前,可穿戴 RGB-热成像相机被用于捕捉手到口(HTM)手势以监测此类行为。然而,依赖单一模态——仅 RGB 或仅热成像——的检测模型往往难以准确区分与进食或吸烟相关的易混淆手势,这源于传感器固有的局限性,如对光照条件的敏感性或热遮挡问题。本文提出一系列融合模型,采用早融合、决策融合以及一种新颖的中融合架构——RGB-热成像融合视频网络(RTFVNet)——整合 RGB 与热成像视频数据,以增强对进食和吸烟相关 HTM 手势的识别能力。实验评估表明,决策融合取得了最高的 F1 分数(88%,0.44 TFLOPs),而 RTFVNet 在性能(85%)与计算复杂度(0.37 TFLOPs)之间实现了最佳平衡,适用于进食、吸烟及非手势活动的分类。
一句话总结
西北大学提出了 RTFVNet,这是一种新型中期融合架构,属于早期融合、决策融合和中期融合 RGB-热成像模型家族,用于在可穿戴视频片段中识别进食和吸烟的手到嘴手势,在 85% F1 分数与 0.37 TFLOPs 计算成本之间达到最佳平衡。
核心贡献
- 提供了在自由生活环境中采集的 441.9 小时 RGB-热成像视频数据集,用于进食、吸烟和非手势活动的多类别手到嘴手势识别。
- 提出早期融合、中期融合和决策融合模型家族,将 RGB 视觉细节与热成像热量线索相结合,以区分容易混淆的进食、吸烟和非手势手到嘴动作。
- 提出 RGB-Thermal Fusion Video Network(RTFVNet),一种新型中期融合架构,用于活动导向相机视频中的多类别手到嘴手势识别;RTFVNet 在 0.37 TFLOPs 下达到 85% 的 F1,相比 88% F1 和 0.44 TFLOPs 的决策融合,提供了准确性与计算复杂度的最佳平衡。
引言
RGB-热成像可穿戴活动导向相机系统是项链式设备,从非第一人称视角监测进食和吸烟等健康风险行为。这一点很重要,因为可靠地检测手到嘴手势可以支持行为追踪、健康监测和干预。以往工作通常单独依赖 RGB 或热成像数据,但 RGB 在低光条件下表现不佳,而热成像会受到环境温度变化和遮挡的影响。为解决这些限制,作者提出了一个大规模自由生活场景 RGB-热成像视频数据集、一组用于区分进食、吸烟和非手势活动的融合模型,以及 RTFVNet,一种为高效多类别手势识别设计的中期融合架构。
数据集
-
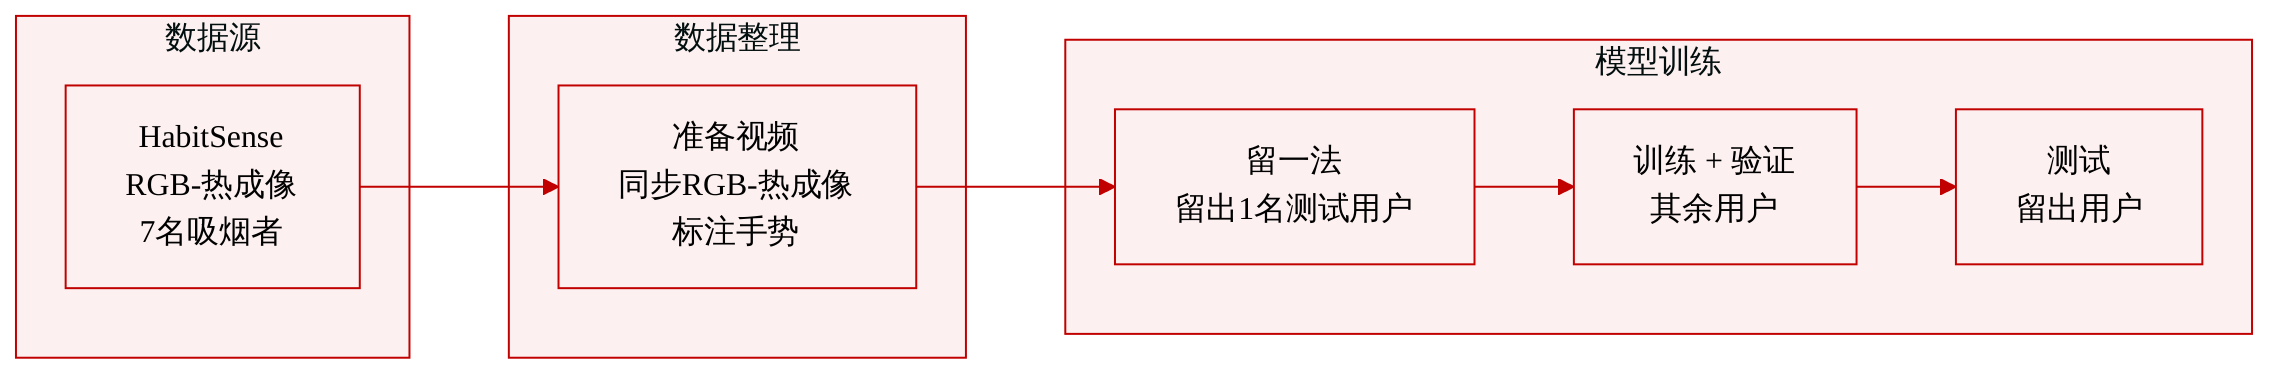
数据来源:作者使用 HabitSense 采集该数据集,这是一种颈戴式 RGB-热成像相机系统,设计用于从佩戴者面部记录活动导向视频。
-
数据集规模和组成:数据集包含 441.9 小时的配对 RGB 与热成像视频,由 7 名吸烟者采集。
-
模态设置:每个样本包含同步的 RGB 和热成像数据流,反映感知系统的 RGB-热成像特性。
-
标注方案:数据集标注了进食和吸烟手势的起止点,为这些目标动作提供时间片段标签。
-
子集细节:提供的文本描述的是单个 RGB-热成像数据集,而不是多个带标签子集,参与者信息仅限于受试者数量。
-
评估中的数据使用:作者使用该数据集进行手势识别实验,并采用留一人交叉验证评估模型。
-
训练/验证策略:在该协议下,将一名参与者的数据留作测试,而其余参与者用于训练和验证。
方法
所提出的框架使用三种融合策略,从配对 RGB 和热成像视频流中区分进食、吸烟和非手势活动。对于决策融合,作者训练两个独立的 TimeSformer 分类器,一个使用 RGB 数据流,另一个使用热成像数据流,然后组合它们的预测类别输出。对于早期融合,RGB 和热成像帧先拼接,再输入单个 TimeSformer 模型,使视频 Transformer 从初始阶段就处理合并后的视觉信号。
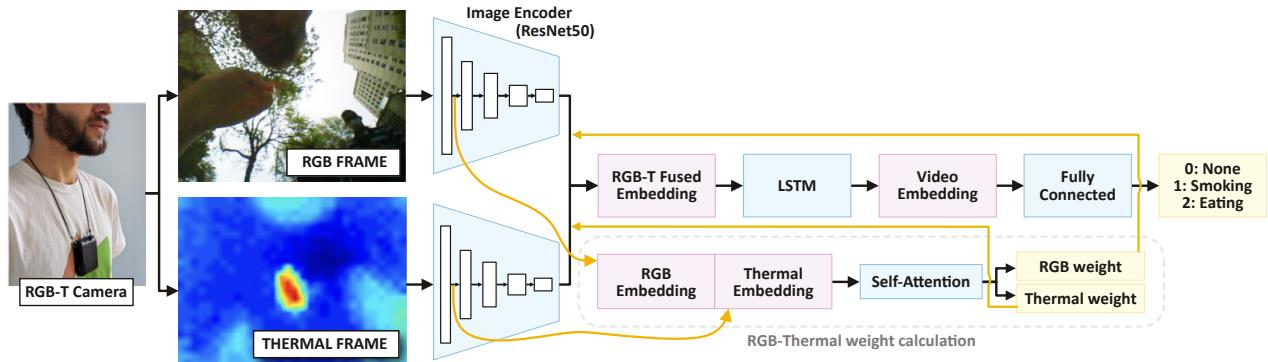
核心贡献是 RTFVNet,一种面向多类别手势分类的新型中期融合架构。该设计借鉴了 RGB-热成像分割网络,但移除了将热成像编码器特征转移到 RGB 编码器的捷径连接。这一修改使每个编码器分支专门从其自身模态提取特征,减少融合前的跨模态干扰,并改进模态特定证据的使用。
如架构图所示:
在该模块中,RGB 和热成像帧首先由独立的早期 ResNet50 编码器处理。这些编码器分别从每个模态提取空间嵌入。随后,RGB 和热成像嵌入被拼接为联合表示。一种自注意力机制估计每个帧对中 RGB 和热成像数据流的相对重要性。如果 zRGB 和 zT 表示潜在特征,wRGB 和 wT 表示学习到的模态权重,则融合后的表示可表示为:
z=wRGBzRGB+wTzT加权后的特征随后被组合,并通过 LSTM 层捕捉帧间时间依赖。最后,全连接层将得到的视频嵌入映射到三类:无、吸烟或进食。整个模型家族使用留一人交叉验证进行训练和评估,并通过分类指标和计算成本评估性能。
实验
实验在由颈戴式 HabitSense 系统采集的多参与者数据集上评估 RGB-热成像进食与吸烟手势识别,并使用留一人验证比较单模态方法与融合方法。这些测试表明,热成像和 RGB 数据流各自捕捉有用但不完整的线索,而决策融合可以通过更高的计算成本提高准确性。提出的中期融合 RTFVNet 被验证为更高效的替代方案,在保留较强识别性能的同时,避免决策层融合的高成本。
结果将单模态 RGB 和热成像模型与用于手势检测的早期、中期和决策融合方法进行比较。决策融合在总体准确率上最高,但计算成本也最高,而采用 RTFVNet 的中期融合在性能与效率之间提供了较强平衡。在报告的指标中,基于 RGB 的模型通常优于仅使用热成像的模型。决策融合给出最佳 F1 分数,但计算量约为单模态模型的两倍。采用 RTFVNet 的中期融合优于 RGB、热成像和早期融合,同时计算量低于决策融合。在比较架构中,仅使用热成像的建模报告的最低性能。
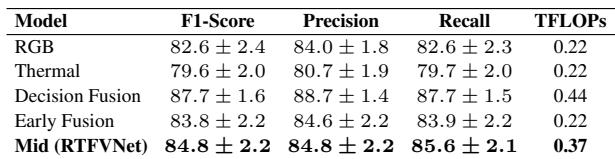
实验评估了 RGB、热成像和融合模型在手势检测中的表现,比较早期融合、中期融合和决策融合。决策融合在总体准确率和 F1 分数上最佳,但计算量约为单模态模型的两倍。采用 RTFVNet 的中期融合在性能与效率之间的平衡优于 RGB、热成像和早期融合,同时 RGB 模型通常优于仅使用热成像的模型,后者的结果最弱。