Command Palette
Search for a command to run...
Revelations:一类具有 ω-正则目标的 POMDP 的可判定类
Revelations:一类具有 ω-正则目标的 POMDP 的可判定类
Marius Belly Nathanaël Fijalkow Hugo Gimbert Florian Horn Guillermo A. Pérez Pierre Vandenhove
摘要
部分可观测马尔可夫决策过程(POMDP)是序贯决策中处理不确定性的一个重要模型。我们关注构造具有理论保证的算法,以判定智能体是否存在以概率 1 满足给定规范的策略。由于对不确定事件的推理存在困难,这一问题即使在非常简单的 ω-正则目标下也已被证明是不可判定的。我们提出一种揭示机制,该机制要求智能体几乎必然最终获得当前状态的完全信息,从而限制信息损失。我们的主要技术成果是针对称为弱揭示和强揭示的两类 POMDP 构造了精确算法。重要的是,可判定情形归约为对一个有限信念支撑马尔可夫决策过程的分析。这为一大类 POMDP 提供了一种概念上简洁且精确的算法。
一句话总结
LaBRI、IRIF 和安特卫普大学的研究人员为 POMDP 提出一种揭示机制,该机制要求当前状态最终以几乎必然的方式被完全观测;他们定义了弱揭示类和强揭示类,使得 ω 正则目标在几乎必然满足方面可通过归约到有限信念支持 MDP 来判定。
核心贡献
-
为 POMDP 引入了一种揭示机制,该机制要求 agent 最终几乎必然获得当前状态的完整信息,并定义了弱揭示类和强揭示类;在这些类中,给定规格的几乎必然策略存在性变得可判定。
-
通过将该问题归约到一个有限信念支持马尔可夫决策过程,为这些类别构造了精确算法;使用信念支持更新函数跟踪可能的状态,并将可达性目标和 Büchi 目标扩展到信念支持集合。
-
分析表明,有限记忆策略已经足够;在信念支持 MDP 上,无记忆策略在揭示假设下是最优的。该分析还把这些可判定类别置于接近不可判定性前沿的位置,例如优先级类别 {0, 1, 2} 与 {1, 2, 3} 之间的界限。
引言
部分可观测马尔可夫决策过程是不确定环境下序贯决策的核心模型,但设计保证 omega-正则规格的精确策略往往不可判定,因此许多已有工作依赖近似规划或经验强化学习。该工作利用一种有限信念支持 MDP 抽象,该抽象只跟踪可能当前状态的集合并忽略概率;但结果表明,这种抽象通常既不健全也不完备,因为很小的概率差异可能累积成信息损失,从而改变几乎必然的结果。主要贡献是一种揭示机制,该机制以弱形式和强形式进行研究,要求 agent 以概率 1 重新获得完整状态信息,从而防止不确定性的无界累积。在该研究中,可判定性与不可判定性边界在这些限制下得到证明;可判定情形可通过分析信念支持 MDP 求解;并给出了一个简单的概念验证算法,在其实验中优于经过调优的深度强化学习基线。
方法
该方法将 POMDP 的几乎必然 omega-正则策略综合视为一个有限抽象问题。给定一个 POMDP 如下 P=(Q,Act,Sig,δ,q0),其中 agent 从 Act 中选择动作,从 Sig 中观测信号,并按照概率转移函数 δ 演化。由于真实状态只可部分观测,agent 的相关知识可以用信念支持来概括,它记录了在给定观测信号历史后仍然可能的状态集合。
核心算法模块是信念支持 MDP。对于信念支持 b 和动作 a,如果存在一个信号 s 使得信念支持更新产生 b′,则信念支持 b′ 可以以正概率到达,即:
δB(b,a)(b′)>0⟺∃s∈Sig,B(b,a,s)=b′.信念支持 MDP PB 的状态是 Q 的所有非空子集,保留相同的动作,并对具有正概率的后继赋予均匀概率。该构造抽象掉信念支持内部的精确概率分布,同时保留可能可观测历史的结构。
策略也可以从信念支持 MDP 提升回原始 POMDP。给定一个可观测历史 h=a1s1…ansn,可以计算诱导的信念支持序列,并形成信念支持历史
Bh=a1b1…anbn.如果 σB 是 PB 中的一个策略,则对应的 POMDP 策略定义如下:
σB(h)=σB(Bh).因此,一旦在有限抽象中找到获胜策略,就可以通过在博弈过程中跟踪信念支持,在原始部分可观测系统中执行该策略。
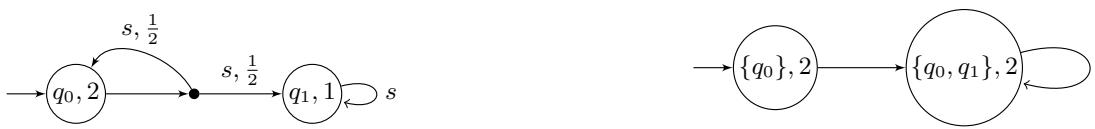
然而,仅使用该抽象通常不健全,因为它忽略了概率质量随时间的集中或消失。一个简单反例表明,即使原始 POMDP 没有几乎必然策略,信念支持 MDP 仍可能在朴素优先级提升下表现为获胜。该失效源于当信念被压缩为支持时定量信息的丢失。下面给出一个最小反例。
为了修复该抽象,该研究引入了揭示语义。当信念支持坍缩为单元素集合时,就会发生揭示,意味着当前状态已被确定识别。形式上,单元素信念支持的集合为:
BsingP={{q}∣q∈Q}.如果一个 POMDP 对每个策略都以概率 1 无限经常到达单元素信念支持,则该 POMDP 是弱揭示的:
PσP[Inf(BsingP)]=1.直观上,弱揭示性确保 agent 不会永久被困于关于当前状态的不确定性。具有无限经常可观测重置的 POMDP 是弱揭示行为的一个自然来源。对于这类 POMDP,抽象的信念支持 MDP 在分析上变得有用,尤其是在使用最大优先级语义提升优先级时
pB(b)=max{p(q)∣q∈b}.关键健全性结果表明,对于弱揭示 POMDP,如果一个策略在此优先级扩展下在信念支持 MDP 中几乎必然获胜,则提升后的策略也在原始 POMDP 中几乎必然获胜。由于无记忆纯策略对于 MDP 中的奇偶目标已经足够,算法可以在保持几乎必然保证的同时搜索一个有限抽象空间。
对于受限的奇偶优先级,该抽象不仅健全而且完备。当优先级属于 {0,1,2} 时,弱揭示 POMDP 中几乎必然策略的存在性等价于其信念支持 MDP 中几乎必然策略的存在性。由于信念支持 MDP 的大小随 POMDP 状态数呈指数级,而 MDP 上的奇偶博弈可在多项式时间内求解,因此这给出了该问题的一个 EXPTIME 算法。
完备性并不推广到所有优先级函数。对于属于 {1,2,3} 的优先级,信念支持抽象可能会拒绝一个仍然拥有几乎必然策略的 POMDP。下面的示例说明一个弱揭示 POMDP,其信念支持 MDP 没有获胜策略,但原始 POMDP 有获胜策略。
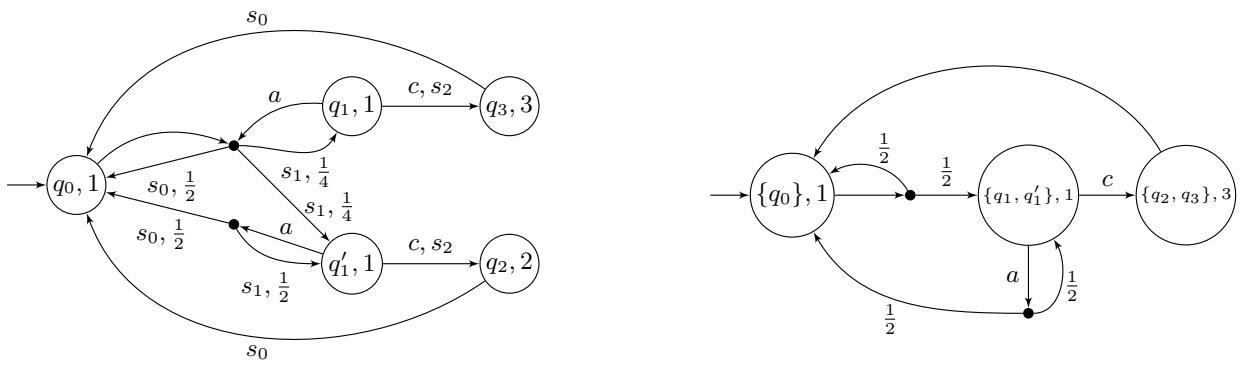
在这个示例中,agent 通过一个专用信号无限经常地返回可观测初始状态 q0。从 q0 出发,一个动作通向包含两个可能状态的信念支持,两者在支持层面都给出最大奇优先级;另一个动作通向可区分好结果和坏结果的状态。信念支持 MDP 只能看到每个支持的最大优先级,因此得出结论认为不存在获胜策略。原始 POMDP 能够成功,因为重复观测可以使 agent 对处于一个分支而非另一个分支具备任意高的信心。如果 agent 重复选择第一个动作并连续观测到 s1 n 次,那么处于期望分支的条件概率趋近于 1:
PσaP[Qnq1′∣(s1)n]=1−2n1.通过逐轮增大 n,agent 能够确保期望状态被无限经常访问,而坏状态只被有限经常访问。将此构造推广后,可得到当优先级属于 {1,2,3} 时几乎必然策略存在性的不可判定性。
一个更强的条件,强揭示性,恢复了对任意奇偶目标的判定性。对于状态 q,揭示信号是保证下一状态为 q 的信号:
Revealing(q)={s∈Sig∣∀r,r′∈Q, r′=q⇒δ(r,a)(s,r′)=0}.如果在一个动作下从 q 到 q′ 的转移可能,则这种转移也能伴随 q′ 的揭示信号发生;满足该条件的 POMDP 是强揭示的。在这种条件下,对每个策略,单元素信念支持都会被无限经常访问,因此强揭示蕴含弱揭示。该性质可通过扫描转移来检查,从而在 POMDP 描述大小意义下可多项式时间判定。对于强揭示 POMDP,信念支持 MDP 分析对所有奇偶目标都既健全又完备,并再次给出 EXPTIME 完全性。
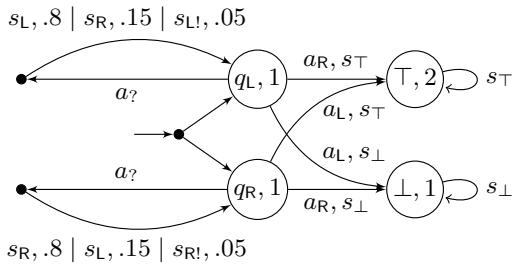
一个说明性的强揭示构造基于老虎式环境。agent 可以听取带噪观测,但该环境增加了罕见揭示信号;当这些信号出现时,它们确定性地识别真实状态。这些信号为信念支持抽象提供了足够信息,保证隐藏状态最终被揭示。下面给出修改后的老虎 POMDP。
该方法还可以解释为为所有 POMDP 定义一种乐观语义。给定任意 POMDP,可以构造一个扩展 POMDP,其中每个转移都以小概率发出一个揭示下一状态的附加信号。该扩展 POMDP 是强揭示的。如果扩展 POMDP 对某个 omega-正则目标没有几乎必然策略,则原始 POMDP 对该目标也没有几乎必然策略。这将揭示结果转化为一个对否定答案的充分判据,即使原始模型并不显式具有揭示性。
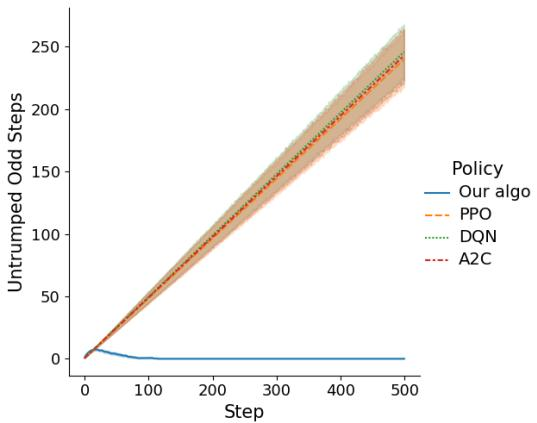
在实现的概念验证中,该算法与现成深度强化学习系统进行对比,这些系统在一个观察封装器上进行训练,该封装器动态维护当前信念支持。该封装器实现子集构造更新,因此学习 agent 接收的是信念支持状态,而不是原始观测。这些 agent 使用简单奖励方案训练:好事件带来奖励 100,坏事件带来奖励 −1,并在有限的交互步数内使用默认超参数。对于 omega-正则规格,评估指标跟踪自最后一次坏事件以来、且尚未被未来好事件取代的步数。数值越低,表示对长期规格的满足越好。下面的比较图报告了该量在多次仿真中的演化。