Command Palette
Search for a command to run...
通过溯因反射高效修正神经符号推理不一致性
通过溯因反射高效修正神经符号推理不一致性
Wen-Chao Hu Wang-Zhou Dai Yuan Jiang Zhi-Hua Zhou
摘要
神经符号(NeSy)人工智能可被视为人类双过程认知的类比,用神经网络建模直觉性的系统1,用符号推理建模算法性的系统2。然而,对于复杂的学习目标,NeSy系统经常产生与领域知识不一致的输出,且修正这些输出具有挑战性。受人类认知反射的启发——它能迅速检测我们直觉反应中的错误,并通过调用系统2推理来修正它们——我们提出基于溯因学习(ABL)框架引入溯因反射(ABL-Ref)来改进NeSy系统。ABL-Ref在训练期间利用领域知识溯因出反射向量,该向量随后能标记神经网络输出中的潜在错误,并调用溯因法进行修正,在推理时生成一致的输出。与之前的ABL实现相比,ABL-Ref具有高效性。实验表明,ABL-Ref优于最先进的NeSy方法,以更少的训练资源实现卓越的准确性,并提高了效率。
一句话总结
南京大学的研究人员提出 ABL-Ref,一种基于 溯因学习 的框架,其灵感来源于人类的 认知反思。该框架利用领域知识在训练过程中溯因出反思向量,标记神经网络输出中的潜在错误,并调用溯因修正这些错误以实现一致的推理,在神经符号推理中达到最先进的精度,同时减少训练资源并提升效率。
核心贡献
- 引入 ABL-Ref,一种基于溯因学习框架的溯因反思方法。该方法利用领域知识在训练过程中溯因出反思向量,标记神经网络输出中的潜在错误,并在推理时触发溯因以产生与知识一致的输出。
- 反思向量作为符号推理的注意力机制,大幅缩小问题空间,相较于先前 ABL 实现效率更高,而先前实现饱受一致性优化复杂度过高之苦。
- 实验结果表明,ABL-Ref 在推理精度上优于最先进的 NeSy 方法,同时所需训练资源更少,并在包括图上的组合优化在内的多种任务上得到验证,展示了其在不同数据类型、数据维度和知识库形式上的多样性。
引言
神经符号 (NeSy) 人工智能通过将神经网络(类似系统 1,用于快速模式识别)与符号推理(类似系统 2,用于深思熟虑、知识驱动的逻辑)相结合,仿效人类推理。其吸引力在于,符号领域知识能够捕捉并纠正神经网络在复杂任务上常常产生的不可靠输出。然而,先前的方法难以保持两者完整的表达能力:有些将符号知识松弛为神经约束,另一些则用分布式表示近似逻辑演算,两者都牺牲了完整推理能力。溯因学习 (ABL) 保留了完整的符号推理,但代价高昂:该方法依赖高度离散的一致性优化步骤,该步骤计算代价大且限制了向大问题的扩展。
为解决这一问题,作者提出溯因反思 (ABL-Ref),这是对 ABL 框架的一般性增强机制。受人类认知反思过程的启发(快速直觉反应触发对领域知识的核查),ABL-Ref 在神经网络输出的同时生成一个反思向量。该向量标记潜在错误并调用符号溯因来修正它们,实际上起到注意力机制的作用,缩小符号求解器的搜索空间。关键的是,这取代了昂贵的一致性优化,而反思向量以无监督方式从领域知识中溯因得到,无需超出最先进 NeSy 系统已使用的额外训练数据。作者在符号形式和视觉形式的数独基准上验证了 ABL-Ref,相比先前的 NeSy 方法,该方法以更少的训练资源获得更高的推理精度,并同时在组合图优化任务上展示了改进的推理效率。
方法
作者提出溯因反思 (ABL-Ref) 来解决标准溯因学习 (ABL) 中固存的计算低效问题。在传统 ABL 框架中,神经网络 f 将输入 x 映射为直觉输出 y^。如果该输出包含与知识库 (KB) 不一致的错误,外部一致性优化模块必须识别出错位置。该模块通常采用零阶优化并反复查询 KB,随着数据规模增大导致指数级时间消耗。
参照框架图。如图所示,标准 ABL 过程包含一致性优化阶段,该阶段在溯因步骤修正错误之前定位错误的真值分配。这种对重复符号推理查询的依赖造成了显著瓶颈,限制了 ABL 只能处理小规模数据集。
为解决此问题,ABL-Ref 引入了一个可学习的反思层 (R),取代外部优化模块。模型架构首先通过主体块 f1 处理输入以生成高维嵌入。这些嵌入随后分裂为两条路径。一条路径进入输出层 f2 产生直觉输出 y^。另一条路径进入反思层 R,生成反思向量 r。
如下方架构图所示,反思向量 r 充当与 y^ 相同维度的二元掩码。每个元素 ri 指示对应元素 y^i 是错误(1)还是正确(0)。该反思机制与直觉输出生成同时运作,模拟人类认知反思过程。
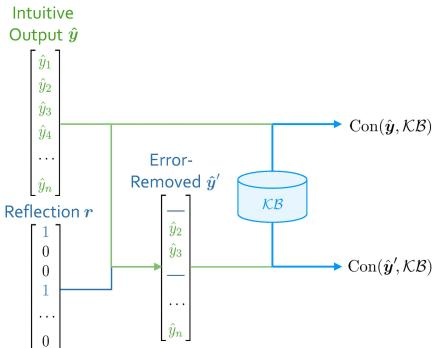
利用反思向量 r,模型通过掩码标记为错误的元素来构建错误移除后的输出 y^′。随后 KB 对这些掩码位置执行溯因以填补空白,从而产生与领域知识一致的最终输出 yˉ。这一方法显著减少了对重复 KB 查询的需求,在反思层识别错误后仅需一次溯因调用即可。
ABL-Ref 的训练聚焦于优化反思机制,以最大化一致性提升。作者定义了一致性度量函数 Con(y^,KB),若输出符合 KB 约束则返回 1,否则返回 0。训练目标是最大化一致性增益 ΔConr(y^)=Con(y^′,KB)−Con(y^,KB) 由于该增益是离散的,采用 REINFORCE 算法优化神经网络参数。
总损失函数结合三部分:
- 一致性损失 (Lcon): 鼓励反思向量识别出能在溯因后带来更高一致性的错误。
- 反思规模损失 (Lsize): 惩罚反思向量将过多元素标记为错误,确保仅在必要时启用溯因。该损失使用超参数 C 控制允许的错误比例上限。
- 监督损失 (Llabeled): 应用于标注数据的标准交叉熵损失。
组合损失公式如下:
L=∣Dl∣1(x,y)∈Dl∑Llabeled(x,y)+∣Dl∪Du∣1x∈Dl∪Du∑(αLcon(x)+βLsize(x))其中 Dl 和 Du 分别表示标注与未标注数据集,α,β 为超参数。
实验
实验在符号数独、视觉数独(图像输入)以及 NP 难的图优化问题上评估了 ABL-Ref。结果表明,ABL-Ref 在推理精度上持续优于现有神经符号基线,同时减少训练时间和标注数据需求。反思机制缩小了符号推理搜索空间,相比纯符号求解器降低了推理时间。该方法还展示了在不同数据类型(符号和亚符号数据)以及以命题逻辑、一阶逻辑或数学公式形式表达的领域知识上的通用性。进一步分析证实,反思机制检测神经网络错误的效率和有效性均优于其他方法。
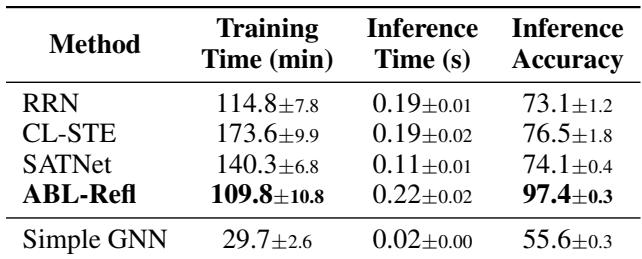
表格比较了求解数独的各类方法,显示 ABL-Refl 达到最高推理精度 (97.4%),同时保持有竞争力的训练和推理时间。简单 GNN 最快,但精度显著较低 (55.6%),凸显速度与正确性之间的权衡。ABL-Refl 在推理精度上超过所有基线,达到 97.4%,比次优方法高出近 20 个百分点。简单 GNN 在训练和推理上均最快,但精度最低,表明纯神经输出不足以完成规则约束任务。ABL-Refl 的推理时间 (0.22 秒) 仅略高于其他方法,精度提升却非常大。基线方法中,CL-STE 精度最高 (76.5%) 但训练时间最长,而 SATNet 提供了中等平衡。
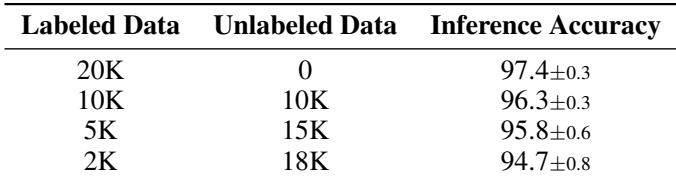
在固定 20K 样本的数据集上,将标注数据从 20K 减至 2K 并相应增加未标注数据,数独推理精度逐步下降。即使只有 2K 标注,精度仍保持高位,表明该方法对标签稀缺的鲁棒性。当标注数据降至总数据集的 10% 时,精度仍高于 94%。标注数据从 20K 降至 2K 时,精度降幅小于 3 个百分点。
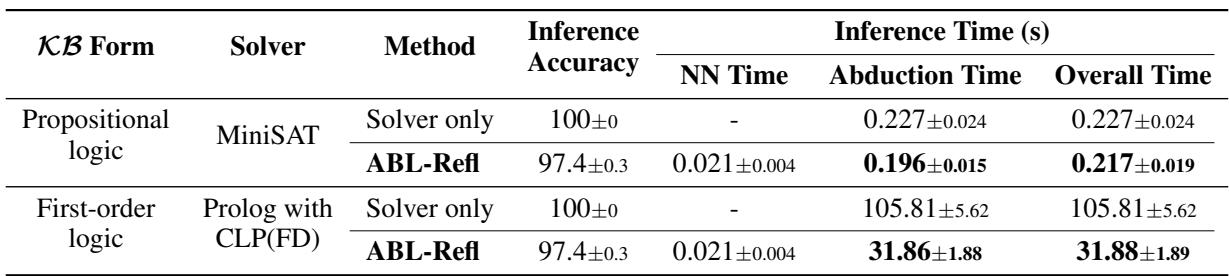
ABL-Ref 将神经网络推理与符号推理相结合以求解数独,实现接近完美的精度,同时大幅降低推理时间,相较于单独使用符号求解器。当知识库以可满足性问题形式表达时,加速效果尤为显著,整体推理时间下降超过三分之一。ABL-Ref 在保持高推理精度 (97.4%) 的同时,削减了整体推理时间(相比仅用求解器的基线)。一阶逻辑的加速更为剧烈:整体时间从超过 100 秒降至大约 32 秒。神经网络组件仅增加极少量时间,主要节省来自溯因时间的减少,尽管引入了神经反思。
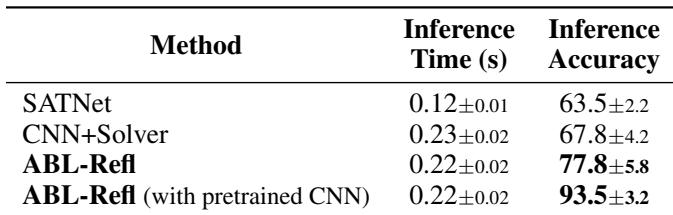
ABL-Refl 在视觉数独上的推理精度高于 SATNet 和 CNN+Solver,而预训练 CNN 进一步提升了精度,同时推理时间保持相当。该方法表明,带反思的端到端推理在精度和鲁棒性上均优于现有方法。ABL-Refl 在推理精度上优于 SATNet,同时推理时间相近或略高。预训练 CNN 的 ABL-Refl 在不改变推理时间的情况下大幅提高精度。CNN+Solver 的精度较低且推理时间更高,部分原因是 CNN 产生的错误无法被修正。
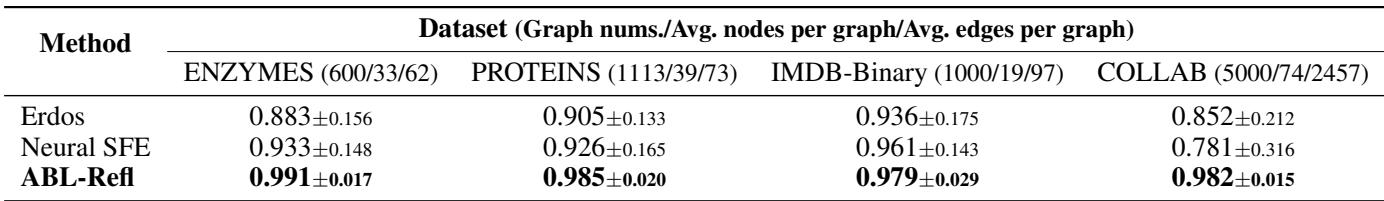
表格比较了四个数据集上最大团问题的近似比,显示所提方法始终取得最高或接近最高的比值,而方差显著低于其他两个基线。特别是在 COLLAB 数据集上,基线方法性能下降,但所提方法保持稳定。所提方法在 ENZYMES、PROTEINS 和 COLLAB 上获得最佳平均近似比,在 IMDB-Binary 上与最佳持平。所提方法的方差在所有数据集上远小于基线,表明性能更为可靠。基线的性能在 COLLAB 上显著下降,而所提方法保持高比值,表明对更大图更好的可扩展性。
实验表明,ABL-Refl 在数独上取得优于基线的推理精度,同时保持有竞争力的训练和推理时间,并且即使只有 10% 标注数据时依然高度准确。整合神经与符号推理削减了整体推理时间,特别是对于一阶逻辑,且不损失精度。在视觉数独和最大团任务上,ABL-Refl 持续优于或匹配现有方法,且具有更低的方差和更好的可扩展性,证实了其在不同推理问题上的鲁棒性和实际效率。